





Un agent qui traite un ticket en six étapes consomme environ 54 000 tokens d’entrée pour 2 400 tokens de sortie, soit 0,12 € au tarif affiché de Claude Sonnet 5.5. Une fois la reprise humaine, les évals et l’observabilité comptées, la même tâche revient à 2,14 € par succès. Le rapport est de dix-sept pour un, et il ne vient pas d’une erreur de calcul : il vient de ce qu’on met dans le mot « coût ».
Besoin d'aide ? Découvrez les solutions de notre agence d'agents IA.
Gartner prévoit que plus de 40 % des projets d’IA agentique seront abandonnés d’ici la fin 2027, l’escalade des coûts figurant parmi les trois causes avec la valeur métier floue et les contrôles de risque insuffisants (Gartner, 2025). Le chiffre surprend moins quand on regarde où part réellement la facture. Sur les milliers d’éditeurs qui se disent agentiques, Gartner en estime 130 réellement capables de l’être.
Je vais poser le calcul complet sur un cas chiffré, avec les tarifs publics de novembre 2026, puis montrer les trois leviers qui font bouger le résultat — et celui qui ne le fait presque pas.
Pourquoi la facture d’un agent n’a rien à voir avec le prix du token ?
Parce qu’une tâche agentique n’est pas un appel de modèle mais une boucle qui renvoie son contexte à chaque tour. La facture se calcule sur la somme des tours, pas sur le tarif au million de tokens.
Une tâche est une boucle, pas un appel
Un agent raisonne, choisit un outil, lit le résultat, raisonne à nouveau. Chaque étape est une requête facturée séparément, qui renvoie le prompt système, les schémas d’outils, l’historique et les résultats précédents. Anthropic mesure cet effet sur son propre système de recherche : un agent consomme environ 4 fois plus de tokens qu’une conversation, un système multi-agents environ 15 fois (Anthropic, 2025). L’étude menée par le Stanford Digital Economy Lab sur huit modèles de frontière va plus loin : une tâche de code agentique consomme 1 200 fois plus de tokens qu’un échange de chat et 3 500 fois plus qu’un raisonnement en un seul tour (Bai et al., 2026).
Le mécanisme est arithmétique. Le contexte s’accumule, et comme il est renvoyé à chaque tour, le total croît approximativement avec le carré du nombre d’étapes. Ce ne sont pas les tokens de sortie qui coûtent : ce sont les tokens d’entrée rejoués. Sur les trajectoires analysées par Stanford, le ratio entrée/sortie des tâches agentiques est structurellement plus élevé que sur du chat, même avec le cache activé.
Le même travail peut coûter trente fois plus
Sur une même tâche, deux exécutions du même agent peuvent varier d’un facteur 30 en tokens consommés. Cette variance n’est pas un défaut de mesure : elle est dans la nature stochastique des trajectoires, et elle explique pourquoi un budget agentique se tient mal avec une moyenne.
Deux résultats de la même étude méritent d’être retenus. D’abord, les modèles de frontière prédisent mal leur propre consommation — corrélation au mieux de 0,39 — et la sous-estiment systématiquement. Ensuite, et c’est plus contre-intuitif, la précision plafonne à un coût intermédiaire puis stagne, voire régresse, quand on dépense davantage : les tokens excédentaires financent souvent de l’exploration improductive plutôt que du raisonnement. Un travail complémentaire sur la spécification des tâches le confirme : réduire une spécification complète à un simple récit utilisateur augmente la dépense de 29,7 % sur les tâches mesurées (arXiv 2608.25399, 2026).
Autrement dit, le coût d’un agent est une variable de conception, pas une donnée du catalogue. Deux équipes qui déploient le même modèle sur le même processus peuvent avoir un facteur dix sur la facture.
Où partent les tokens dans une tâche réelle ?
Dans le contexte, presque exclusivement. Prenons un agent de traitement de demandes de remboursement pour un site e-commerce, le cas le plus banal qui soit.
Le calcul, étape par étape
La tâche se déroule en six étapes : lire la demande, récupérer la commande, vérifier la politique de retour, décider, écrire la décision dans l’outil de gestion, confirmer au client. Le préfixe statique — prompt système et schémas des douze outils — pèse 6 000 tokens. Chaque étape ajoute environ 1 200 tokens d’historique, et produit 400 tokens de sortie.
| Étape | Action | Tokens d’entrée envoyés |
|---|---|---|
| 1 | Lire la demande | 6 000 |
| 2 | Récupérer la commande | 7 200 |
| 3 | Vérifier la politique de retour | 8 400 |
| 4 | Décider | 9 600 |
| 5 | Écrire dans l’outil | 10 800 |
| 6 | Confirmer au client | 12 000 |
| Total | 6 appels | 54 000 entrée / 2 400 sortie |
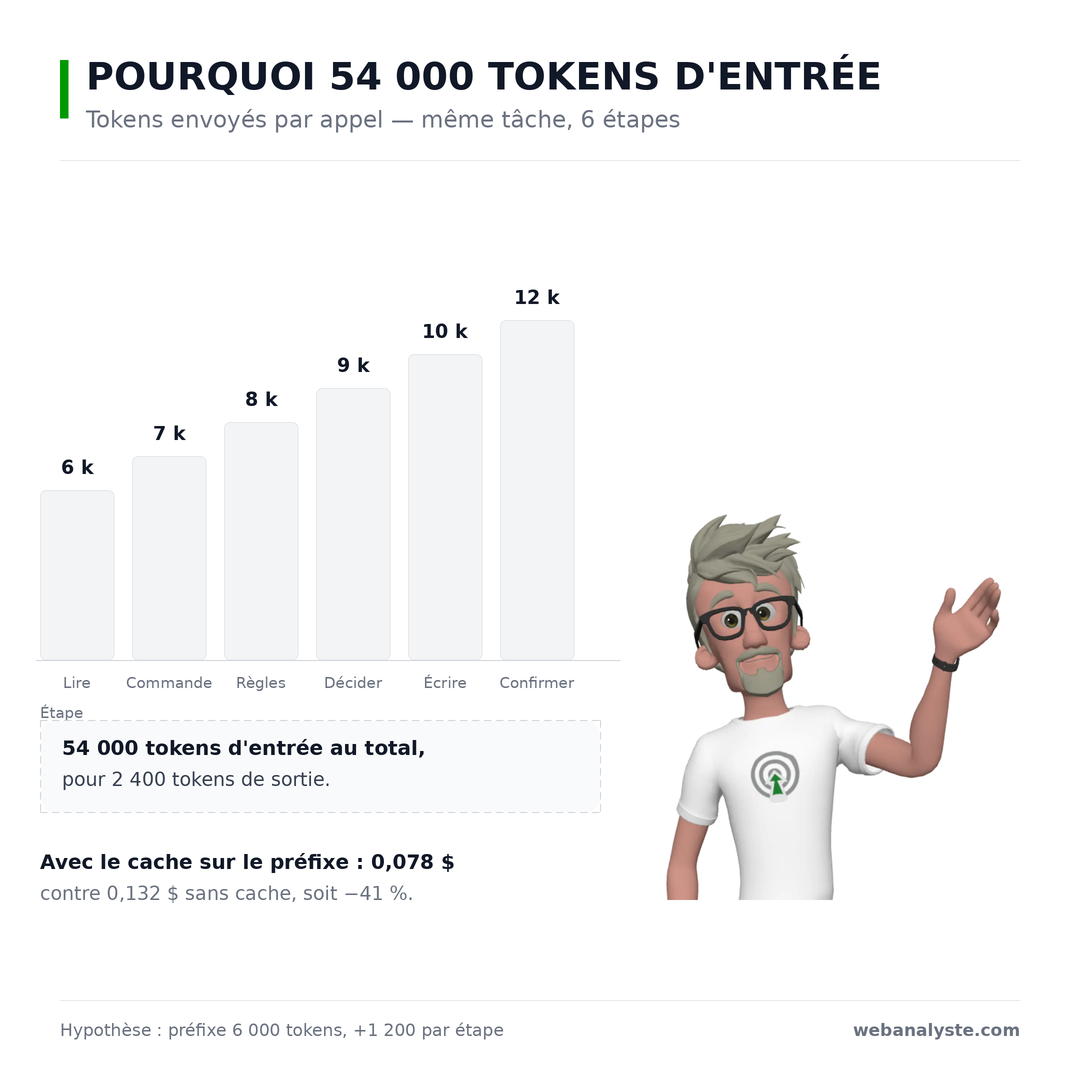
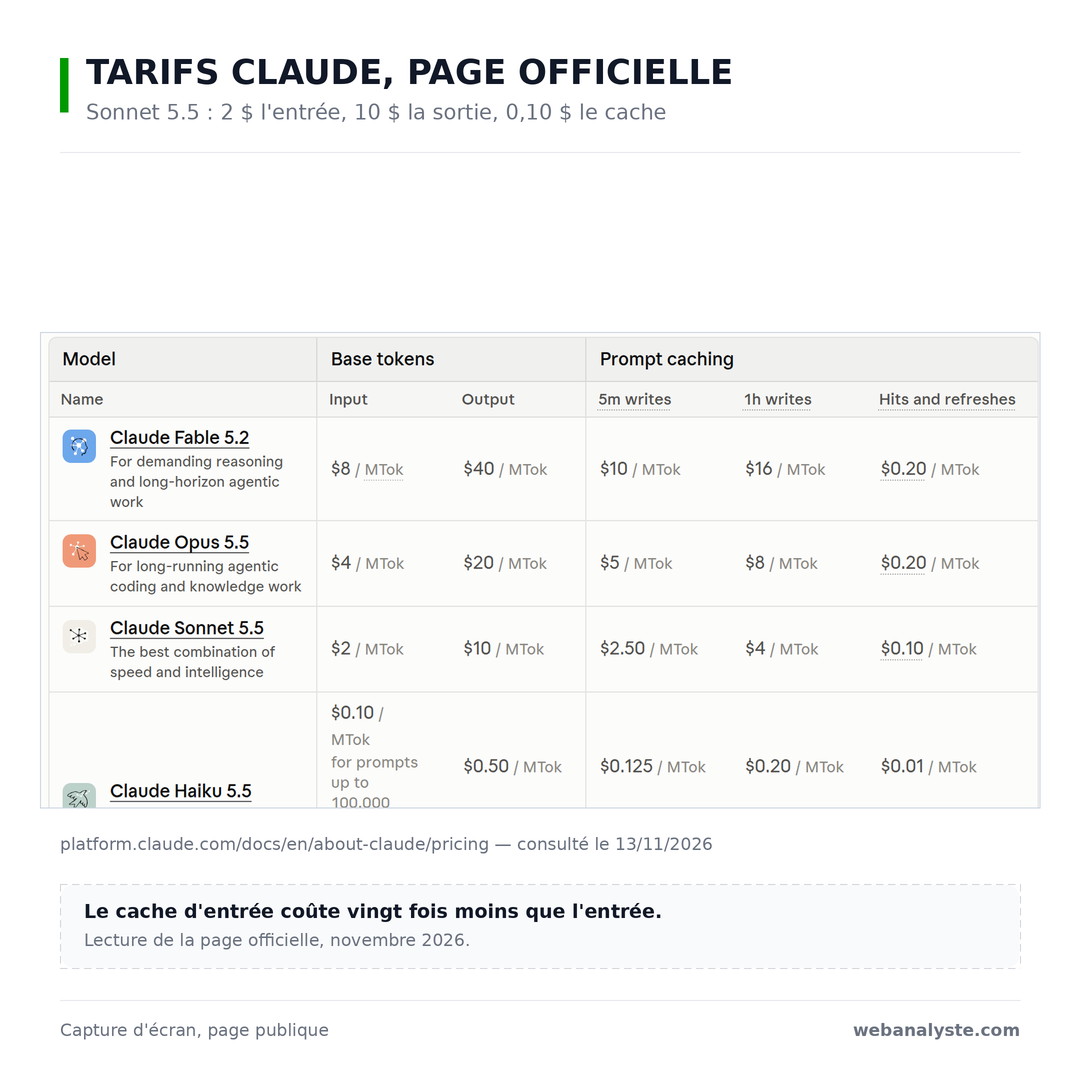
Au tarif public de Claude Sonnet 5.5, soit 2 $ par million de tokens d’entrée et 10 $ par million en sortie, la tâche coûte 0,132 $ : 0,108 $ d’entrée, 0,024 $ de sortie, soit 0,12 € au taux de 0,92. C’est le chiffre que tout le monde a en tête. Il est exact, et il ne sert à rien.
Le cache change l’ordre de grandeur
Le préfixe statique ne change pas d’un appel à l’autre. Le mettre en cache coûte 2,50 $ par million de tokens à l’écriture, puis 0,10 $ par million à la lecture, soit vingt fois moins que le tarif d’entrée. Sur notre tâche, seuls 18 000 tokens d’historique variable restent facturés plein tarif : la facture tombe à 0,078 $, soit 41 % de moins.
La condition est stricte. Le cache ne fonctionne que si le préfixe est identique et placé au début de la requête. Un prompt système qui contient la date du jour, l’identifiant de session ou un rappel du contexte client casse le cache à chaque appel — et c’est l’erreur que je vois le plus souvent dans les journaux d’exécution. Le gain ne se lit pas dans le code : il se vérifie dans les compteurs de tokens mis en cache, qui doivent être non nuls et stables.
Quels coûts n’apparaissent jamais sur la facture du modèle ?
Trois postes : la reprise humaine des échecs — un agent fiabilisé en production en garde toujours une part —, la revue des sorties douteuses, et la plateforme qui fait tourner l’ensemble. Sur le cas précédent, ils représentent 96 % du coût complet.
Les échecs et la reprise humaine
Admettons un taux de résolution autonome de 82 %, ce qui est un bon résultat pour un agent de support en production. Les 18 % restants repartent vers un humain, avec un temps de reprise de 12 minutes. À 35 € de coût horaire chargé, la reprise coûte 1,26 € par tâche échouée. Ajoutons une revue humaine sur 10 % des sorties signalées par les garde-fous, à 3 minutes pièce, et un coût de plateforme de 0,25 € par tâche. Les tokens sont convertis au taux de 0,92 € pour 1 $.
| Poste | Par 100 tâches | Par tâche réussie |
|---|---|---|
| Tokens du modèle | 7,20 € | 0,09 € |
| Reprise humaine (18 %) | 126,00 € | 1,54 € |
| Revue des sorties (10 %) | 17,50 € | 0,21 € |
| Plateforme, évals, observabilité | 25,00 € | 0,30 € |
| Total | 175,70 € | 2,14 € |
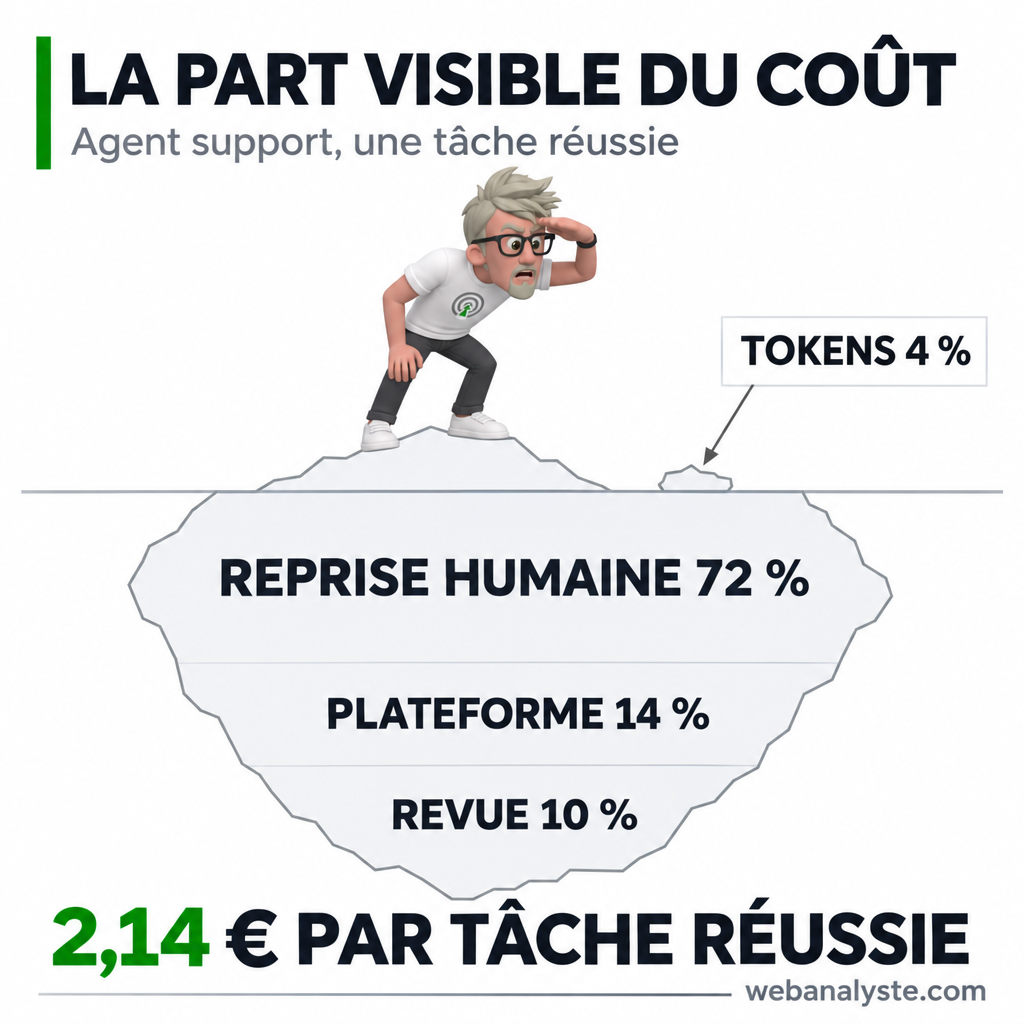
Les tokens pèsent 4 % du total. Les échecs en pèsent 72 %. Ce déséquilibre est la raison pour laquelle le tarif au million de tokens est un mauvais instrument de pilotage : il mesure le seul poste qui n’est pas un problème.
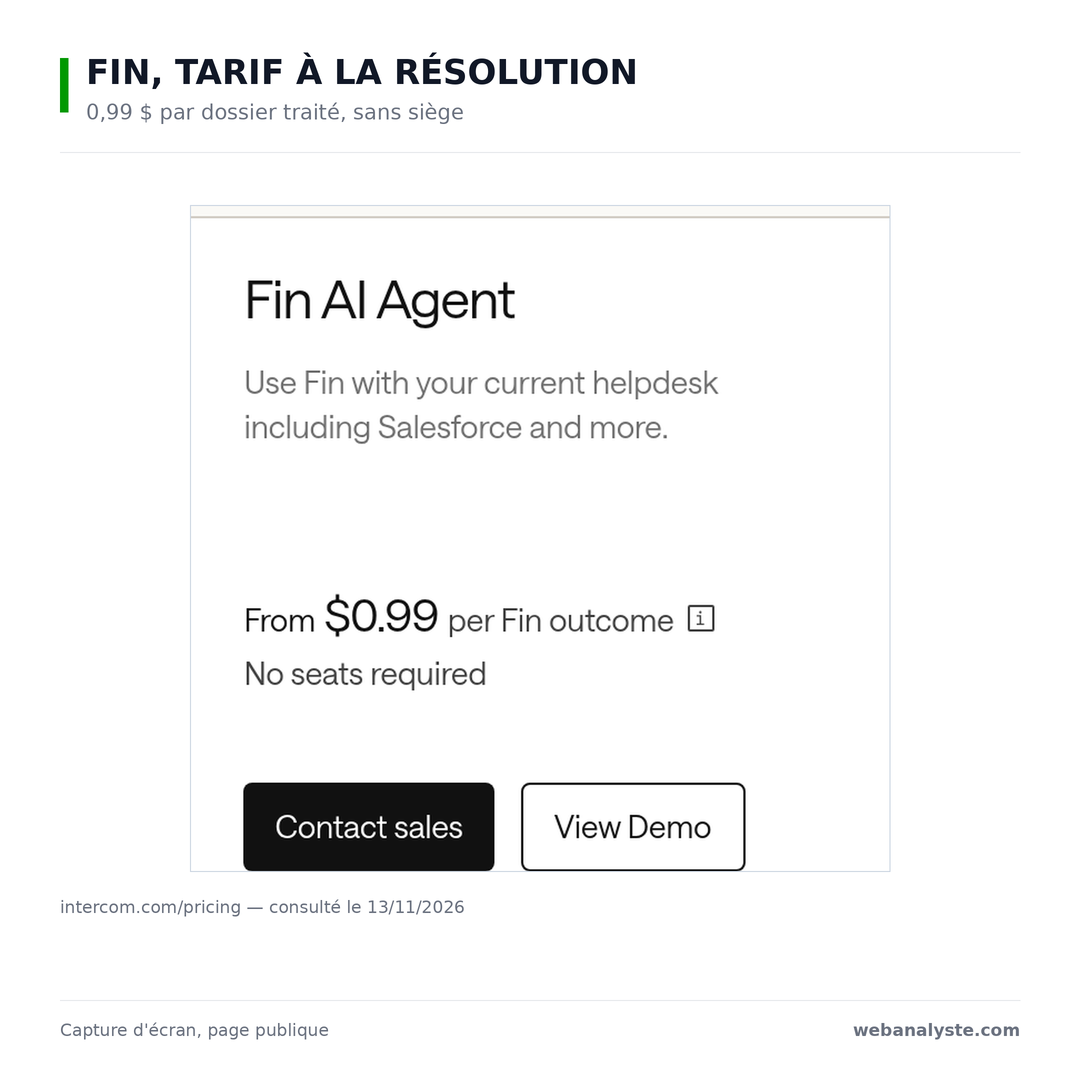
La comparaison avec un tarif éditeur aide à comprendre ce que publient les fournisseurs. Intercom facture son agent Fin à partir de 0,99 $ par résolution. Ce prix couvre les résolutions réussies, pas les dossiers qui échouent — ceux-là restent à la charge du client, en temps humain. À 82 % de résolution, le coût complet côté client ressort autour de 2,45 € par tâche réussie, soit un ordre de grandeur très proche du calcul précédent. Les deux chiffres ne se contredisent pas : ils ne parlent pas du même périmètre.
La plateforme, les évals et l’observabilité
Ce poste est fixe pour l’essentiel, et c’est ce qui le rend traître. Hébergement de l’orchestrateur, base vectorielle, traçage des exécutions, jeux d’évaluation rejoués à chaque changement de prompt, modèles secondaires pour le routage et la modération : à 10 000 tâches par mois, l’ensemble tourne autour de 2 500 €, soit 0,25 € par tâche. À 100 000 tâches, le même socle tombe à 0,03 € par tâche. Un agent à faible volume coûte cher non pas parce que les tokens sont chers, mais parce que rien n’est amorti.
Ces coûts ne sont pas optionnels. Un agent sans traçage des exécutions ne se diagnostique pas, et un agent sans évals ne se modifie pas sans risque. Vous pouvez les ignorer au pilote ; en production, ils réapparaissent sous forme d’incidents.
Comment calculer votre coût par tâche réussie ?
Avec une division : toute la dépense attribuable à un flux, divisée par le nombre de tâches arrivées à un résultat correct. Le dénominateur est le point important — une tâche traitée n’est pas une tâche réussie.
La formule et les quatre nombres à journaliser
Coût par tâche réussie = (dépense modèle sur toutes les tentatives + reprise humaine + coûts de plateforme alloués) ÷ tâches réussies. Le numérateur inclut les échecs et les reprises automatiques, sinon la mesure flatte le système.
Quatre nombres suffisent, à condition de les journaliser par tâche et non par mois : les tokens d’entrée, de sortie et mis en cache à chaque appel, avec un identifiant de tâche commun ; le nombre d’étapes par tâche ; l’issue de chaque tâche — réussie, escaladée, réessayée, abandonnée ; les minutes humaines consommées par escalade. Si vous ne savez pas produire ces quatre séries depuis vos journaux, vous pilotez à l’aveugle avec la grille tarifaire du fournisseur.
Le levier le plus rentable n’est pas le modèle
Une expérience contrôlée publiée en octobre 2026 isole l’effet de l’orchestration : 22 tâches d’entreprise verrouillées, six modèles de cinq éditeurs, deux couches d’orchestration, tout le reste figé. Le simple changement de couche fait passer le coût par tâche de 0,21 $ à 0,12 $, soit −41 %, avec 38 % de tokens en moins, 44 % de latence en moins et une qualité inchangée (arXiv 2607.06906, 2026). Le même travail montre que passer du modèle le plus cher au moins cher n’économise que 36 % : la façon dont on assemble les appels pèse plus lourd que le choix du modèle.
À l’échelle d’un million de tâches par mois, l’écart entre les deux orchestrateurs vaut 90 000 $ par mois, soit 1,08 M$ par an. Sur mon cas de support, diviser le prix du token par deux ne récupère que 2 % du coût total, puisque les tokens représentent 4 % de la facture. Les leviers utiles sont ailleurs : plafonner le nombre d’étapes, détecter les boucles qui répètent le même appel avec les mêmes arguments, router les étapes simples vers un petit modèle, élaguer le contexte, mettre en cache ce qui est stable, et mesurer la qualité avec des évals avant de toucher aux réglages.
Quel budget prévoir pour un premier agent en production ?
Deux lignes distinctes : une dépense de construction, non récurrente, et un coût d’exploitation par tâche. Confondre les deux est la cause la plus fréquente des coûts cachés d’un projet IA.
Côté construction, comptez 15 000 à 60 000 € pour un agent correctement outillé sur un seul flux : intégration aux systèmes existants, jeux d’évaluation, garde-fous, traçage et procédure de reprise humaine. Un démonstrateur qui répond juste coûte dix fois moins ; il ne passe pas la production. Côté exploitation, le coût par tâche réussie se situe autour de 0,50 à 3 € pour un agent unique, et grimpe à 3–10 € dès qu’un orchestre multi-agents tourne, cohérent avec le facteur 15 sur les tokens mesuré par Anthropic.
La décision qui économise le plus intervient avant l’architecture. Si les étapes d’un processus sont connues à l’avance, un agent est une manière coûteuse d’exécuter un workflow : du code déterministe avec un seul appel de modèle pour l’interprétation fait le même travail pour une fraction du prix. Gartner le dit sans détour : beaucoup de cas d’usage présentés comme agentiques n’ont pas besoin d’une implémentation agentique. L’agent se justifie quand le chemin n’est pas connaissable à l’avance — recherche ouverte, données hétérogènes, décisions à enchaîner avec des outils.
Votre agent coûte-t-il moins cher que la tâche qu’il remplace ?
C’est le seul chiffre qui décide. Comparez le coût par tâche réussie, reprise humaine comprise, au coût actuel du même processus. Un ticket traité à 8 € aujourd’hui revient à 2,14 € avec l’agent : le gain est réel. Un ticket traité à 3 € ne le finance pas.
Cette comparaison suppose de mesurer, donc d’instrumenter. Le tarif au million de tokens ne sera jamais qu’une ligne de la facture, et rarement la plus lourde. Si vous voulez poser ce calcul sur vos propres flux — tokens, échecs, reprises, plateforme —, faisons le point sur vos flux avant d’écrire une ligne d’orchestration.
Questions fréquentes
Combien coûte un agent IA en production par mois ?
Le montant dépend du volume, pas du modèle. Un socle de plateforme coûte 300 à 2 500 € par mois selon l’observabilité et les évals, auquel s’ajoute le coût par tâche multiplié par le volume. Sur notre cas de support à 10 000 tâches par mois, la facture complète ressort autour de 17 600 €, dont 720 € de tokens.
Le prix des tokens va-t-il rendre les agents gratuits ?
Non. Epoch AI mesure une baisse du prix de l’inférence à performance constante allant de 9 à 900 fois par an selon le niveau visé (Epoch AI, 2025). Mais la consommation augmente plus vite que le prix ne baisse : c’est l’effet Jevons appliqué à l’inférence, où la baisse du prix unitaire finance des boucles plus longues et plus d’agents. Et les tokens ne représentaient que 4 % du coût complet dans notre calcul.
Faut-il prendre le modèle le plus cher pour un agent fiable ?
Pas par défaut. L’écart de coût entre le modèle le plus cher et le moins cher du marché pèse moins que l’écart entre deux orchestrateurs sur les mêmes tâches. Un petit modèle suffit pour classifier, extraire et valider ; le modèle de raisonnement se réserve aux étapes de décision. Sur les tâches de code analysées par Stanford, la précision plafonne d’ailleurs à un coût intermédiaire, pas au maximum.
Combien de tokens consomme un agent par tâche ?
Cela va de 8 800 tokens par tâche pour un orchestrateur optimisé à 14 200 pour une boucle de production classique sur le même jeu de tâches d’entreprise. Un agent de support en six étapes avec un préfixe de 6 000 tokens monte à 54 000 tokens d’entrée. Les agents de code dépassent largement le million de tokens sur certaines tâches.
Peut-on facturer un agent au résultat ?
Seulement si le coût par tâche est prévisible. Les modèles de frontière prédisent mal leur propre consommation et la sous-estiment, ce qui rend un prix au forfait risqué sans plafond d’étapes ni mesure par tâche. La pratique viable consiste à plafonner la dépense par exécution, mesurer le coût par succès, puis fixer un prix qui couvre la queue de distribution des tâches les plus coûteuses.
Sources
- Bai, L., Huang, Z., Wang, X., Sun, J., Mihalcea, R., Brynjolfsson, E., Pentland, A., Pei, J. (2026). How Do AI Agents Spend Your Money? Analyzing and Predicting Token Consumption in Agentic Coding Tasks. Stanford Digital Economy Lab / Microsoft Research. arxiv.org/abs/2604.22750
- Anthropic (2025). How we built our multi-agent research system. anthropic.com/engineering/multi-agent-research-system
- The Harness Effect: How Orchestration Design Sets the Token Economics of Enterprise Agentic AI (2026). arXiv 2607.06906. arxiv.org/abs/2607.06906
- Can your AI agent be cheaper? Investigating the effects of task specifications on token spend in agentic coding tasks (2026). arXiv 2608.25399. arxiv.org/abs/2608.25399
- Gartner (25 juin 2025). Gartner Predicts Over 40% of Agentic AI Projects Will Be Canceled by End of 2027. gartner.com
- Anthropic (consulté en novembre 2026). Pricing. Tarifs Claude Sonnet 5.5 et cache de prompt. platform.claude.com/docs/en/about-claude/pricing
- Intercom (consulté en novembre 2026). Pricing — Fin AI Agent. intercom.com/pricing
- Cottier, B., Snodin, B., Owen, D., Adamczewski, T. (2025). LLM inference prices have fallen rapidly but unequally across tasks. Epoch AI. epoch.ai
Franck Scandolera — data engineer et spécialiste de l’automatisation IA. Je conçois des agents et des applications métier qui tournent en production, avec leurs évals, leur traçabilité et leur coût par tâche.

Dev d’applications métier · Data Engineer · Automatisation IA
Clients : Logis Hôtels, Yelloh Village, BazarChic, FFF, Texdecor…
- Apps & agents IA : Node.js, Python, API, RAG, OpenAI, Mistral, Claude
- Data & Analytics Engineering : GCP, BigQuery, Snowflake, PostgreSQL, ClickHouse, dbt, Airflow, Dataform, Looker, Power BI, Metabase
- Automatisation IA : n8n, Apps Script, scraping, API, LLM
- Tracking & perf Web : GA4, GTM server, Matomo, Piano, Tealium, CAPI, Core Web Vitals