





La mémoire d’un agent IA repose sur des données stockées hors du modèle, puis réinjectées dans ses prompts. Je distingue mémoire à court terme, mémoire à long terme, contexte et RAG, avant de détailler les composants nécessaires pour suivre l’état d’une tâche et réutiliser des informations entre sessions.
Besoin d'aide ? Découvrez les solutions de notre agence d'agents IA.
Pourquoi chaque appel au LLM repart-il de zéro ?
Chaque appel au LLM est indépendant : le modèle ne conserve pas, à lui seul, les souvenirs des appels précédents. Il répond à partir des informations qui lui sont transmises au moment de l’appel. Si une conversation semble continue, cette continuité vient d’informations conservées ailleurs puis réintroduites dans le prompt.
La mémoire d’un agent ne correspond donc pas à un souvenir persistant dans le modèle. C’est une information stockée hors de celui-ci et fournie à nouveau lorsqu’elle est utile. Le prompt sert alors de contexte : il peut contenir des éléments issus d’échanges antérieurs, des données de tâche ou des consignes nécessaires à la réponse.
Le principe est simple : le modèle ne se rappelle pas ; le système lui redonne le contexte pertinent. Sans cette réinjection, un nouvel appel ne dispose pas des informations précédentes. Avec elle, l’agent peut poursuivre une tâche ou tenir compte d’éléments déjà collectés, sans que le modèle ait acquis une mémoire permanente.
Les informations à conserver dépendent de la durée et de l’objectif de la tâche. Pour une demande ponctuelle, le contexte utile peut se limiter aux informations nécessaires à cet échange. Pour une tâche qui se prolonge, il peut être pertinent de conserver des éléments utiles à la suite, puis de les réinjecter lors des appels concernés. Tout garder n’est pas forcément utile : l’enjeu est de préserver ce qui aide réellement l’agent à atteindre son objectif.
La question suivante n’est donc pas seulement « où stocker la mémoire ? », mais aussi quoi conserver, pour combien de temps et à quel moment le remettre dans le contexte. Ces choix déterminent la continuité de l’agent, pas une capacité de souvenir propre au LLM.
Quelle différence entre mémoire courte et mémoire longue ?
La mémoire à court terme suit le contexte et l’état d’une tâche en cours. La mémoire à long terme conserve des informations réutilisables entre plusieurs tâches ou sessions. L’une aide l’agent à poursuivre ce qu’il fait ; l’autre lui permet de retrouver ce qui reste utile dans le temps.
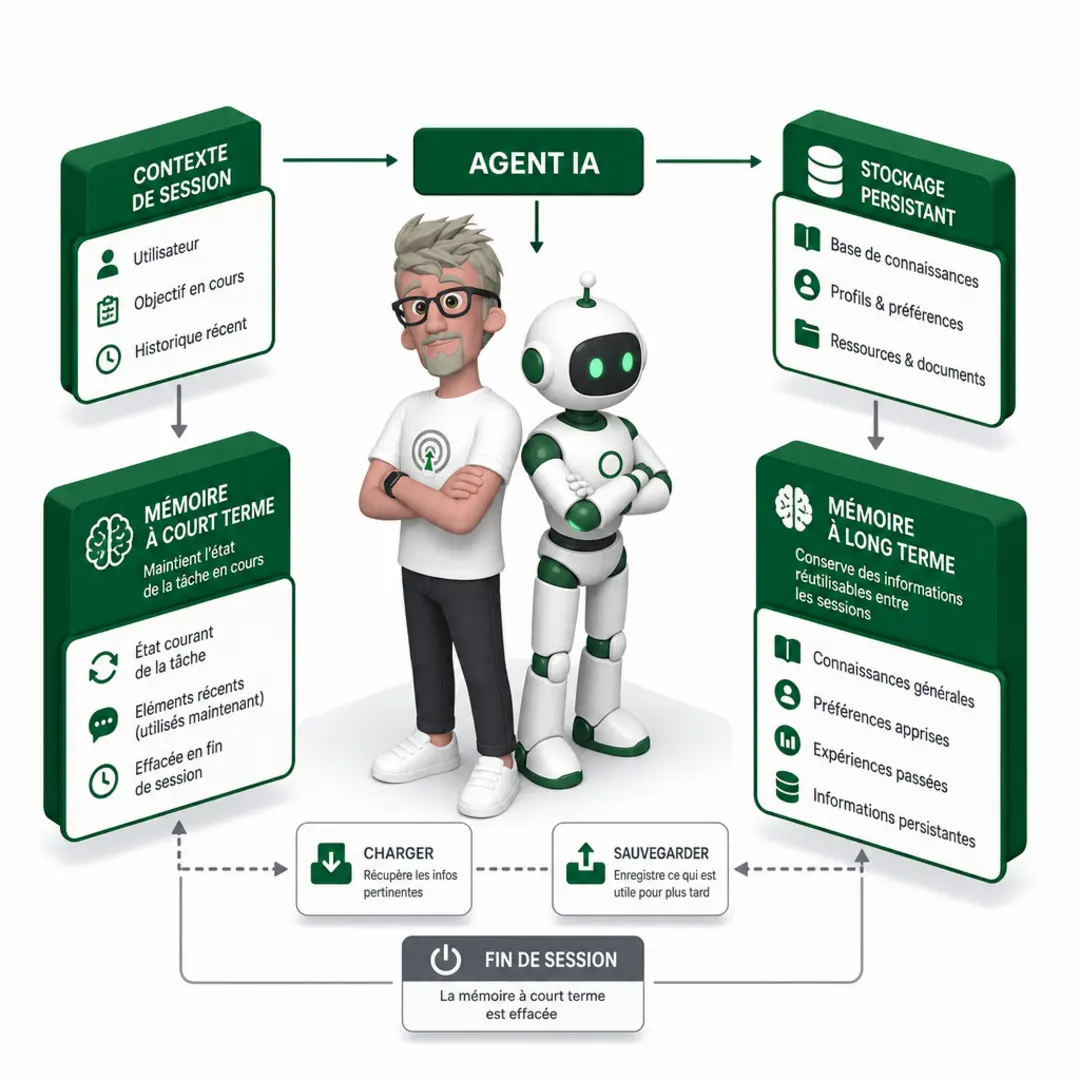
La mémoire à court terme contient généralement les échanges récents, les étapes déjà réalisées, les contraintes actives et les décisions prises pendant la tâche. Elle peut être limitée par la fenêtre de contexte du modèle, c’est-à-dire la quantité de texte qu’il peut traiter simultanément. Quand la conversation s’allonge, un résumé peut maintenir le fil. Mais un résumé compresse l’information : une nuance, une exception ou une valeur précise peut disparaître.
La mémoire à long terme stocke plutôt des éléments utiles au-delà de la tâche immédiate : préférences récurrentes, résultats obtenus, décisions validées, connaissances métier ou procédures fiables. Elle n’a pas vocation à archiver chaque échange. Une couche externe — par exemple une base de données ou un système de recherche — doit décider quoi conserver, comment l’indexer et quand le restituer. Si elle récupère une information obsolète ou hors sujet, l’agent peut produire une réponse cohérente mais erronée.
À titre d’exemple, imaginons un agent qui prépare des comptes rendus commerciaux. Pendant la rédaction, sa mémoire courte suit le client concerné, les points discutés et les actions à confirmer. Sa mémoire longue pourrait conserver le format préféré de l’équipe ou une règle de qualification validée. Ce scénario illustre la distinction ; il ne décrit pas un fonctionnement universel.
À retenir
- La mémoire courte maintient le contexte et l’état d’une tâche en cours.
- La mémoire longue conserve des préférences, des résultats et des connaissances réutilisables.
- Les résumés prolongent le contexte, mais peuvent perdre des détails.
- Une couche externe pilote la conservation et la restitution des informations.
Mémoire du modèle, contexte, RAG ou mémoire d’agent ?
La mémoire du modèle vient de son entraînement. L’ingénierie du contexte choisit ce qu’on ajoute au prompt. Le RAG consulte un corpus existant pour retrouver des informations. La mémoire d’agent enregistre des faits ou des résultats issus de son activité, afin de les réutiliser plus tard. Ces mécanismes ne font pas la même chose : consulter une source, c’est récupérer une information ; enrichir une mémoire, c’est conserver une nouvelle information pour une réutilisation ultérieure.
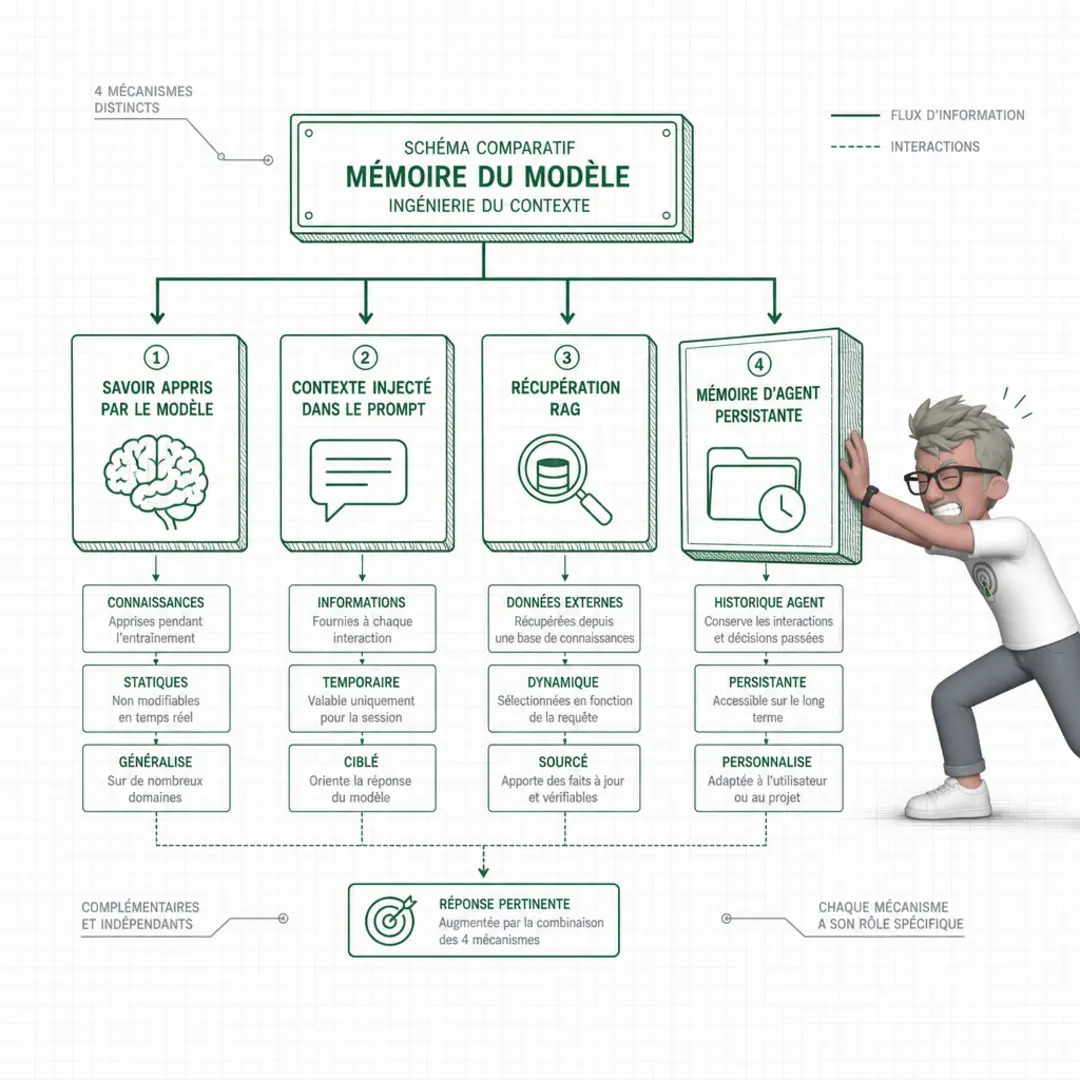
La mémoire du modèle correspond aux informations apprises et intégrées dans ses paramètres pendant l’entraînement. Elle n’est pas enrichie automatiquement à chaque échange. L’ingénierie du contexte, elle, sélectionne les éléments pertinents à transmettre au modèle dans le prompt. Ce contenu peut provenir d’une conversation, d’instructions ou d’informations récupérées par un système externe.
Le RAG, pour « génération augmentée par récupération », recherche des passages dans un corpus existant et les ajoute au contexte de la requête. Il permet donc au modèle de consulter une source, mais ne lui fait pas enregistrer les nouvelles informations dans ce corpus. La mémoire d’agent joue un autre rôle : elle peut stocker des faits ou des résultats produits au fil de son activité, puis les rendre disponibles lors d’interactions ultérieures.
| Notion | Rôle |
| Mémoire du modèle | Savoir appris pendant l’entraînement. |
| Ingénierie du contexte | Sélection des éléments ajoutés au prompt. |
| RAG | Récupération d’informations depuis un corpus existant, sans y écrire les nouvelles informations. |
| Mémoire d’agent | Enregistrement de faits ou de résultats pour les réutiliser plus tard. |
La distinction est importante dans une architecture : une recherche RAG ne constitue pas, à elle seule, une mémoire persistante de l’agent. Dans le chapitre suivant, les composants d’architecture montreront où se situent la récupération du corpus, la construction du contexte et le stockage de la mémoire d’agent.
Quels composants composent une mémoire d’agent ?
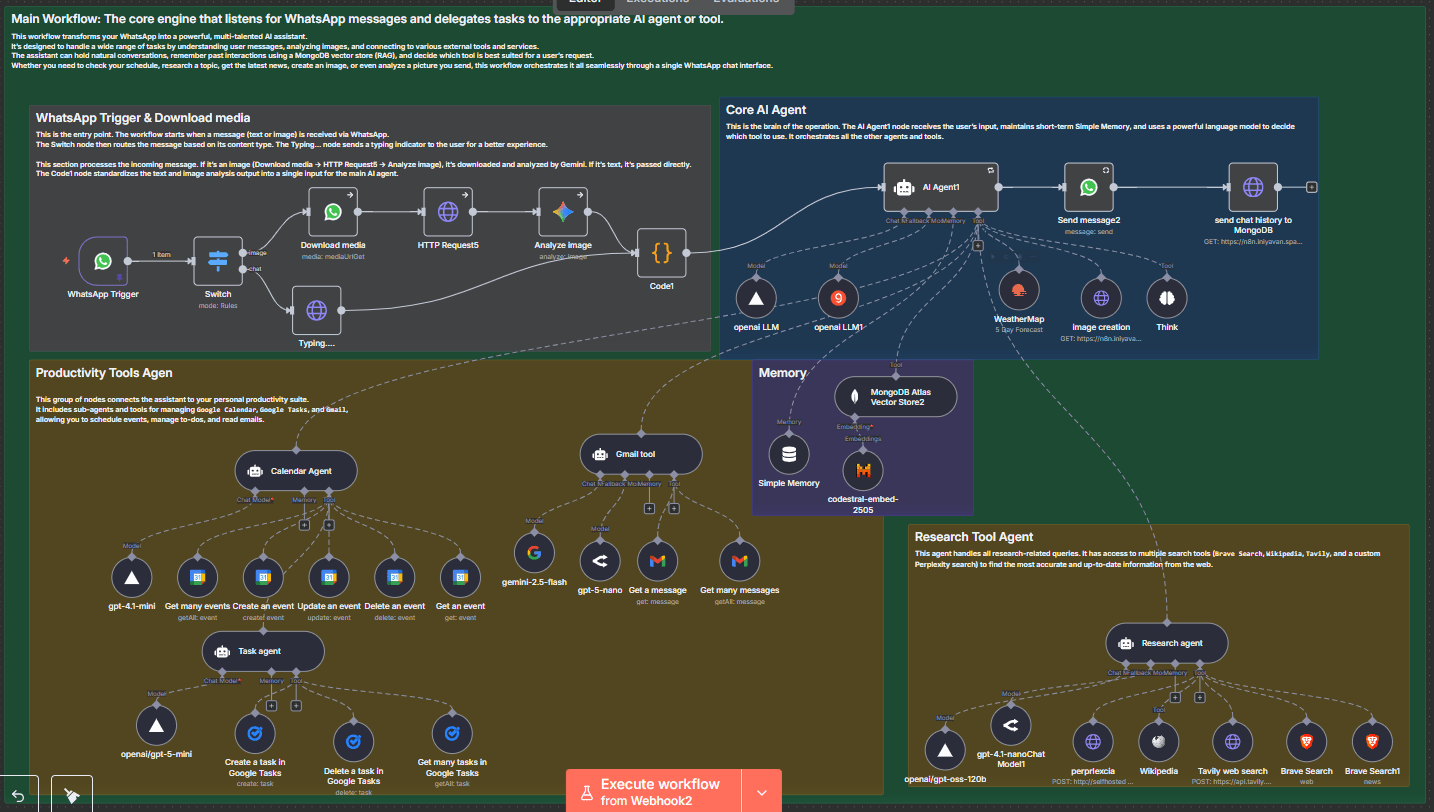
Une mémoire d’agent comprend au minimum trois composants : un stockage persistant, une logique d’écriture et une interface de récupération. Le modèle ne conserve pas nécessairement ces informations d’un échange à l’autre. La mémoire est enregistrée hors du modèle, puis remise à sa disposition quand le contexte le justifie.
| Composant | Rôle |
| Stockage persistant | Conserver les informations au-delà d’une exécution ou d’une conversation. Il peut s’agir d’une mémoire individuelle ou partagée, selon le besoin. |
| Logique d’écriture | Déterminer quelles informations méritent d’être enregistrées et déclencher leur enregistrement. Sans cette logique, le stockage reste vide ou accumule des éléments inutiles. |
| Interface de récupération | Permettre à l’agent de retrouver des informations stockées et de les remettre dans son contexte de travail. |
Le flux conceptuel est simple : une information utile est choisie, enregistrée hors du modèle, puis récupérée lorsqu’elle devient pertinente. Elle est alors réinjectée dans le prompt, c’est-à-dire dans les instructions et le contexte transmis au modèle pour produire sa réponse. L’agent peut ainsi tenir compte d’une préférence, d’un fait ou d’un élément de contexte sans devoir le redemander à chaque échange.
La difficulté n’est pas seulement de stocker. Une mémoire trop large peut ajouter du bruit au contexte ; une mémoire trop restrictive peut faire perdre des éléments importants. Il faut donc définir le périmètre de l’écriture et de la récupération en fonction de l’usage. Dans un workflow agentique, n8n et Cognee sont évoqués comme des pistes pour créer une mémoire partagée ou l’intégrer à un système d’agents. Cela ne définit pas, à lui seul, une architecture ni des étapes d’implémentation précises.
Les décisions structurantes restent les mêmes : quoi écrire, où le stocker et quand le récupérer. Elles déterminent ce que l’agent pourra réellement réutiliser, et dans quel contexte.
Quelle mémoire faut-il mettre en place ?
Un LLM ne conserve pas, par défaut, l’état de ses appels précédents. Pour créer de la continuité, je stocke les informations utiles à l’extérieur du modèle et je les réinjecte dans le prompt. La mémoire à court terme suit une tâche en cours ; la mémoire à long terme permet de réutiliser des préférences, des résultats ou des connaissances entre sessions. Le RAG consulte un corpus existant, tandis que la mémoire d’agent peut aussi enregistrer de nouvelles informations. Une architecture repose au minimum sur un stockage persistant, une logique d’écriture et une interface de récupération. En séparant clairement ces rôles, vous donnez à vos agents une continuité exploitable sans confondre contexte, mémoire et recherche.
FAQ
-
Pourquoi un agent IA a-t-il besoin d’une mémoire externe ?
Chaque appel au LLM est indépendant. Une mémoire externe permet de conserver les informations utiles et de les réinjecter dans les prompts pour assurer la continuité. -
À quoi sert la mémoire à court terme d’un agent ?
Elle suit le contexte et l’état d’une tâche en cours. Des résumés peuvent aider à maintenir ce contexte, mais ils peuvent aussi omettre des détails. -
Que conserve la mémoire à long terme ?
Elle conserve entre les sessions des éléments réutilisables, comme des préférences, des résultats ou des connaissances. Une couche externe décide quoi enregistrer et quoi restituer. -
Quelle est la différence entre RAG et mémoire d’agent ?
Le RAG récupère des données dans un corpus existant sans y écrire les nouvelles informations. La mémoire d’agent peut enregistrer des faits et des résultats produits pendant son activité pour les réutiliser ensuite. -
Quels sont les composants minimaux d’une mémoire d’agent ?
Il faut un stockage persistant, une logique qui décide quoi enregistrer et une interface permettant de récupérer les informations pertinentes.
A propos de l’auteur
Franck Scandolera est expert en automatisation IA et en workflows agentiques. Il conçoit des applications métier capables de gérer leur état et de réutiliser des informations pertinentes d’une session à l’autre.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.