





Une couche de données respectueuse de la vie privée ne transmet que des champs approuvés, nécessaires et liés à une finalité définie. Je détaille comment cadrer le consentement, inventorier les flux, limiter les données collectées et vérifier chaque état avec des preuves comparées à une référence.
Besoin d'aide ? Découvrez les solutions de notre agence Google Tag Manager.
Comment cadrer le consentement et les flux de données ?
Je cadre le consentement en établissant une matrice technique avant toute modification du gestionnaire de balises ou de la plateforme de gestion du consentement. Elle relie le choix exprimé par l’utilisateur aux états transmis aux balises et aux contrôles appliqués aux autres fournisseurs.
La matrice doit préciser, pour chaque choix possible, qui le recueille, où il est stocké et comment il est transmis. Je documente la correspondance avec les types de consentement Google utilisés dans l’implémentation, ainsi que le mécanisme de contrôle prévu pour chaque autre fournisseur. Je ne présume pas de leur comportement : je consigne ce qui est configuré et vérifiable dans l’environnement.
| Élément | Informations à consigner |
| Choix utilisateur | Composant qui recueille le choix, options proposées et état enregistré. |
| Consentement Google | Correspondance entre chaque choix et les types de consentement configurés. |
| Autres fournisseurs | Balises concernées et mécanisme utilisé pour contrôler leur déclenchement ou leur accès aux données. |
| Inventaire technique | Balises, cookies, autres stockages et destinations des données. |
| Périmètre | Sites, environnements, régions et exigences régionales à prendre en compte. |
Je délimite ensuite le périmètre de test : environnements concernés, régions à couvrir, accès nécessaires et personnes habilitées à les utiliser. Les scénarios doivent couvrir les choix disponibles, leur modification, la navigation entre pages et les parcours qui activent les balises concernées. Pour chaque scénario, je relève le choix affiché, l’état transmis et les stockages ou destinations observés.
L’inventaire doit être exploitable pendant les tests. Je note, pour chaque balise, sa finalité déclarée dans le dispositif, le fournisseur associé, les conditions de déclenchement et les données ou stockages observables. Les accès aux outils de test, aux réglages de la plateforme de consentement et au gestionnaire de balises doivent être confirmés avant le démarrage.
Enfin, je consigne le fonctionnement initial dans un état de référence daté, avec la configuration observée et les résultats des scénarios. Sans cette référence, on ne peut pas distinguer une régression d’un comportement déjà présent.
Quels champs faut-il conserver ou exclure ?
Seuls les champs approuvés, nécessaires et associés à une finalité définie doivent être conservés. Un champ sans usage démontré, sans provenance vérifiable ou sans responsable identifié n’a pas sa place dans la couche de données.
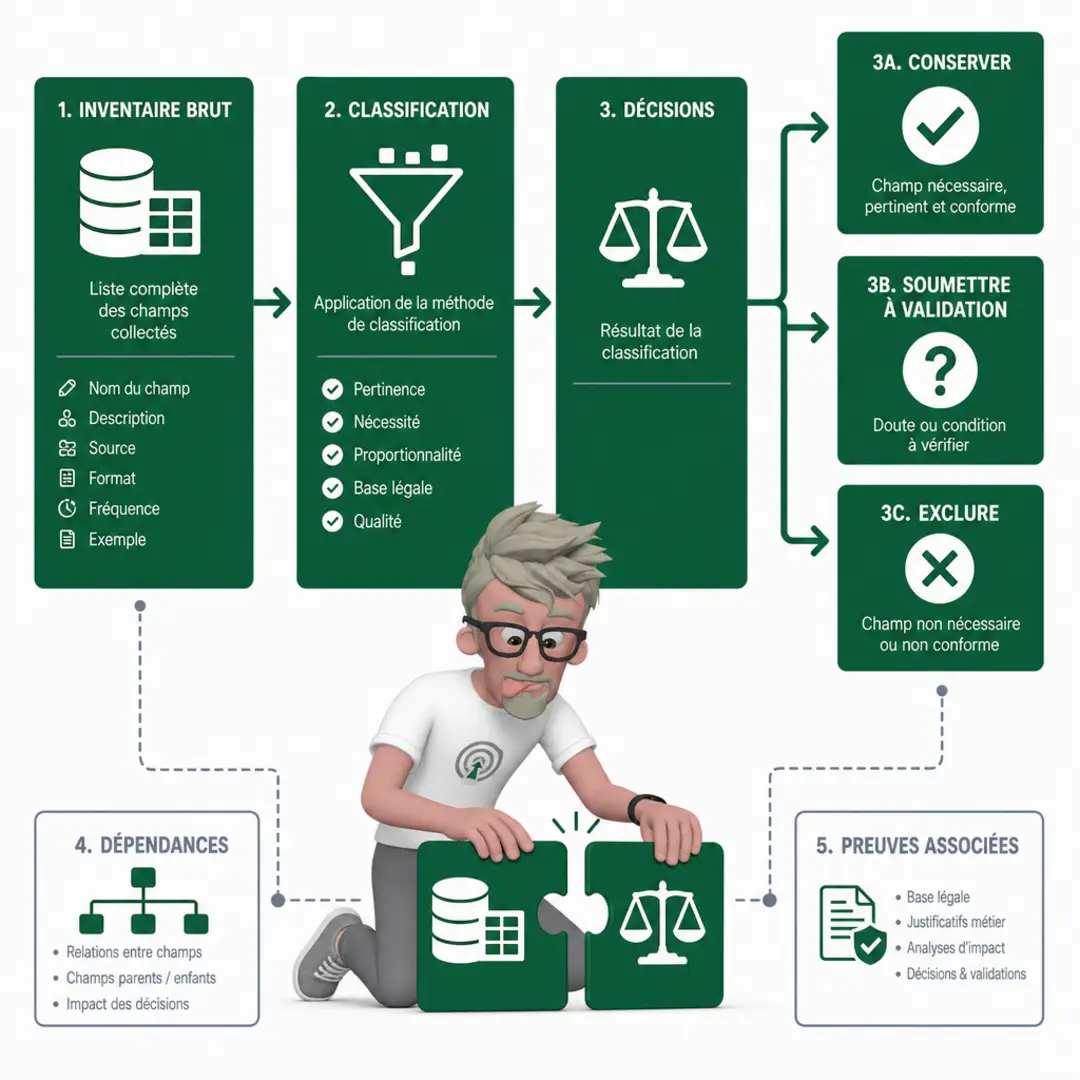
Pour chaque champ ou paramètre envisagé, je documente les éléments qui permettent de décider s’il peut être conservé, sous quelles conditions et avec quelles garanties :
| Élément | À documenter |
| Finalité | Le besoin métier précis auquel le champ répond. |
| État attendu | Le type, le format, la présence obligatoire ou facultative et les règles de validation. |
| Variantes autorisées | Les valeurs, formats ou cas particuliers acceptés. Toute autre valeur doit être rejetée ou signalée. |
| Responsable | La personne ou l’équipe qui approuve le champ et répond de son usage. |
| Dépendances | Les sources en amont, les transformations appliquées et les usages en aval. |
| Preuves et retour arrière | Les éléments attestant la conformité, ainsi que la procédure pour retirer le champ sans casser les traitements dépendants. |
J’exclus par défaut les données personnelles directement identifiantes, comme le nom, l’adresse e-mail ou le numéro de téléphone, ainsi que les données sensibles. Une exception exige une finalité explicite, une validation appropriée et des protections documentées. Je vérifie aussi la provenance des valeurs : source réelle, règle de transformation et cohérence avec le système d’origine. Une valeur qui semble plausible n’est pas une preuve.
Je cartographie les dépendances en amont et en aval avant toute décision. Un champ peut alimenter un tableau de bord, une audience ou un automatisme sans que cette dépendance soit visible dans la couche elle-même. Sa suppression doit donc être évaluée avec les équipes concernées.
Guide CNIL Consentement multi-terminaux
Enfin, je ne reconstitue jamais une information manquante à partir d’un libellé, du texte d’une page ou d’un élément de présentation. L’absence reste une absence. Cette classification complète l’inventaire préparé dans le chapitre précédent : chaque élément recensé reçoit un statut clair — conserver, soumettre à validation ou exclure.
Comment limiter les valeurs transmises ?
Je limite les valeurs transmises en privilégiant des catégories métier générales plutôt que du texte libre, et en supprimant les champs qui ne sont pas nécessaires à la finalité du suivi. Une valeur détaillée peut révéler plus d’informations que prévu, même sans nom ni adresse.
Je suis chaque valeur depuis sa source de référence jusqu’à sa destination : système métier, couche de données, puis requête ou enregistrement reçu par le destinataire. À chaque étape, je vérifie que la valeur reste conforme à l’état attendu.
Les contrôles portent sur les points suivants :
- Noms : Ils sont stables, compréhensibles et cohérents avec la définition métier. Un même nom ne doit pas désigner plusieurs notions.
- Types : Une date reste une date, un montant un nombre, une catégorie une valeur contrôlée. Une conversion implicite peut altérer le sens.
- Portée et temporalité : La valeur concerne le bon événement, la bonne session ou le bon utilisateur. Son horodatage reflète le moment attendu, avec une référence temporelle claire.
- Identifiants : Ils sont nécessaires, cohérents entre les étapes et limités à l’usage prévu. Je vérifie qu’aucun identifiant direct ne part sans justification.
- Devise et consentement : Chaque montant est interprété avec sa devise explicite. Les valeurs soumises au consentement ne sont transmises que lorsque l’état applicable l’autorise.
- Valeurs vides : Je distingue absence, valeur nulle, zéro et « non applicable ». Les confondre peut fausser les analyses ou déclencher un traitement inattendu.
Une inspection visuelle de l’interface ne suffit pas. Une valeur peut être masquée à l’écran, ajoutée par une règle intermédiaire ou transformée avant l’envoi. J’examine donc aussi une trace de requêtes ou les enregistrements effectivement transmis.
Pour chaque champ, je consigne l’état attendu : source, nom, type, portée, moment d’émission, règle de consentement et valeur autorisée. Je compare ensuite chaque valeur observée à cette référence. Toute différence — champ supplémentaire, valeur inattendue, type modifié ou donnée transmise sans consentement — doit être expliquée, corrigée ou explicitement acceptée avant la mise en production.
Comment mettre en œuvre les états de consentement ?
Je configure les états de consentement par défaut avant le traitement des balises Google, puis je transmets une mise à jour dès que l’utilisateur fait ou modifie son choix. L’ordre est critique : une balise qui s’exécute avant l’état initial peut traiter des données sans tenir compte du consentement attendu.
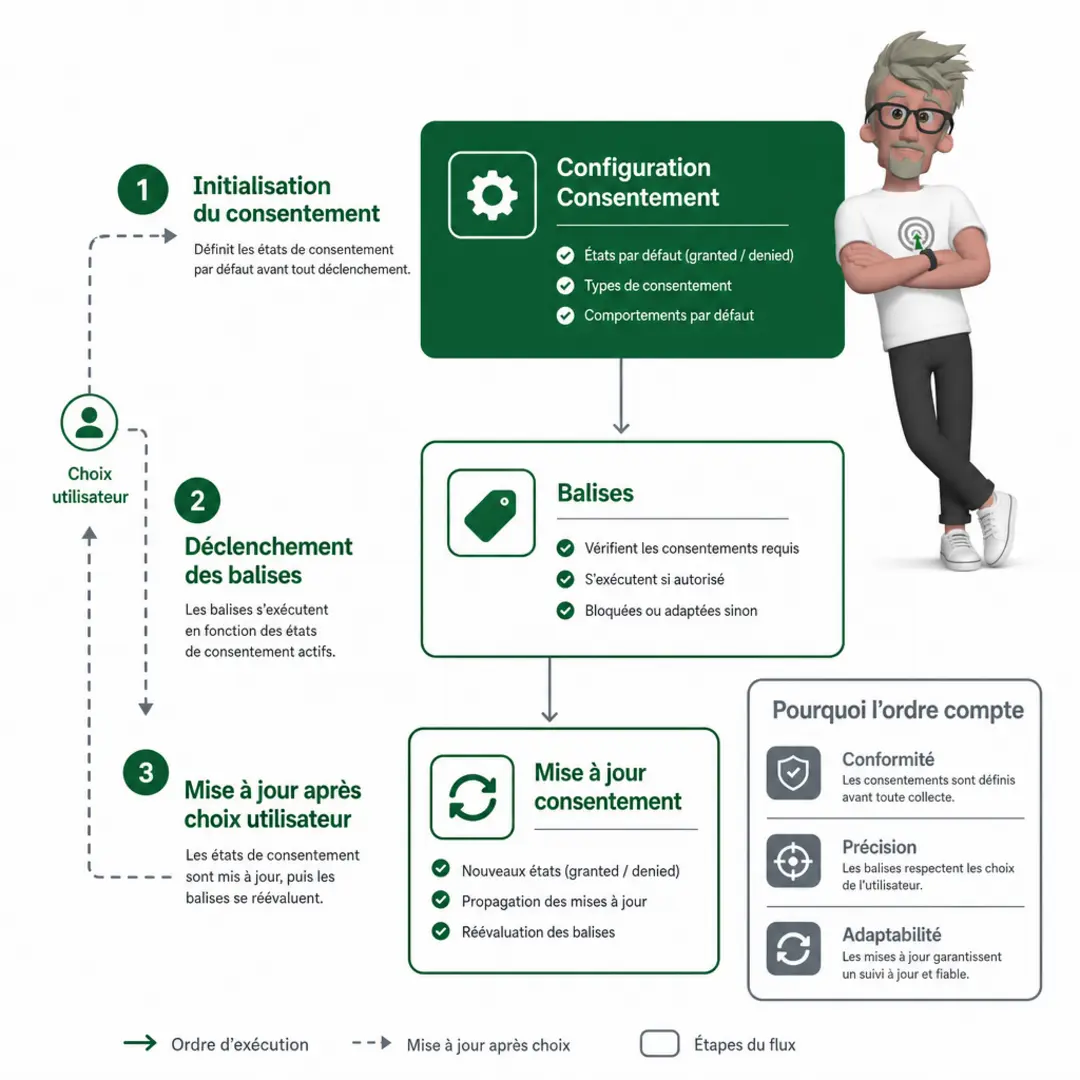
La mise en œuvre s’appuie sur l’API ou le modèle d’intégration documenté et pris en charge par la CMP retenue. Je privilégie les contrôles de consentement intégrés aux balises Google plutôt qu’un blocage personnalisé qui pourrait empêcher leur comportement prévu. Les catégories concernées — par exemple ad_storage ou analytics_storage — doivent correspondre aux finalités présentées dans l’interface de choix.
Je formalise aussi la règle régionale : quelles régions reçoivent quel état par défaut, et sur quelle base. Une différence de configuration régionale doit être documentée et testée, pas déduite du comportement supposé de la CMP.
| Étape | Responsable | Résultat attendu |
| Définir les états par défaut et les règles régionales. | Responsable privacy, avec l’équipe juridique. | Une matrice validée par région et par finalité, cohérente avec l’interface de consentement. |
| Configurer la CMP avec son API ou son modèle pris en charge. | Équipe martech. | L’état initial est transmis avant le traitement des balises Google. Les appels concrets dépendent de la solution retenue. |
| Relier le choix de l’utilisateur aux mises à jour de consentement. | Équipe martech et intégrateur CMP. | Un choix accepté, refusé ou modifié actualise les états correspondants, sans délai non maîtrisé. |
| Vérifier l’ordre et les résultats dans un environnement de test. | QA ou analyste tracking. | Les balises respectent l’état initial, puis la mise à jour, pour chaque région et chaque parcours de choix. |
Je teste aussi le refus, l’absence de choix, le retrait du consentement et le rechargement de page. Le résultat doit être observable dans les outils de diagnostic, sans exposer de données personnelles dans les journaux de test.
Comment tester les parcours et valider les résultats ?
Je compare les requêtes observées dans le navigateur et les enregistrements reçus par chaque destination à une matrice d’états attendus et à un état de référence daté. La matrice précise, pour chaque parcours, l’état de consentement, les champs autorisés, les valeurs attendues et les destinations visées. La référence indique sa date et sa version : sans ce point de comparaison, un écart reste difficile à qualifier.
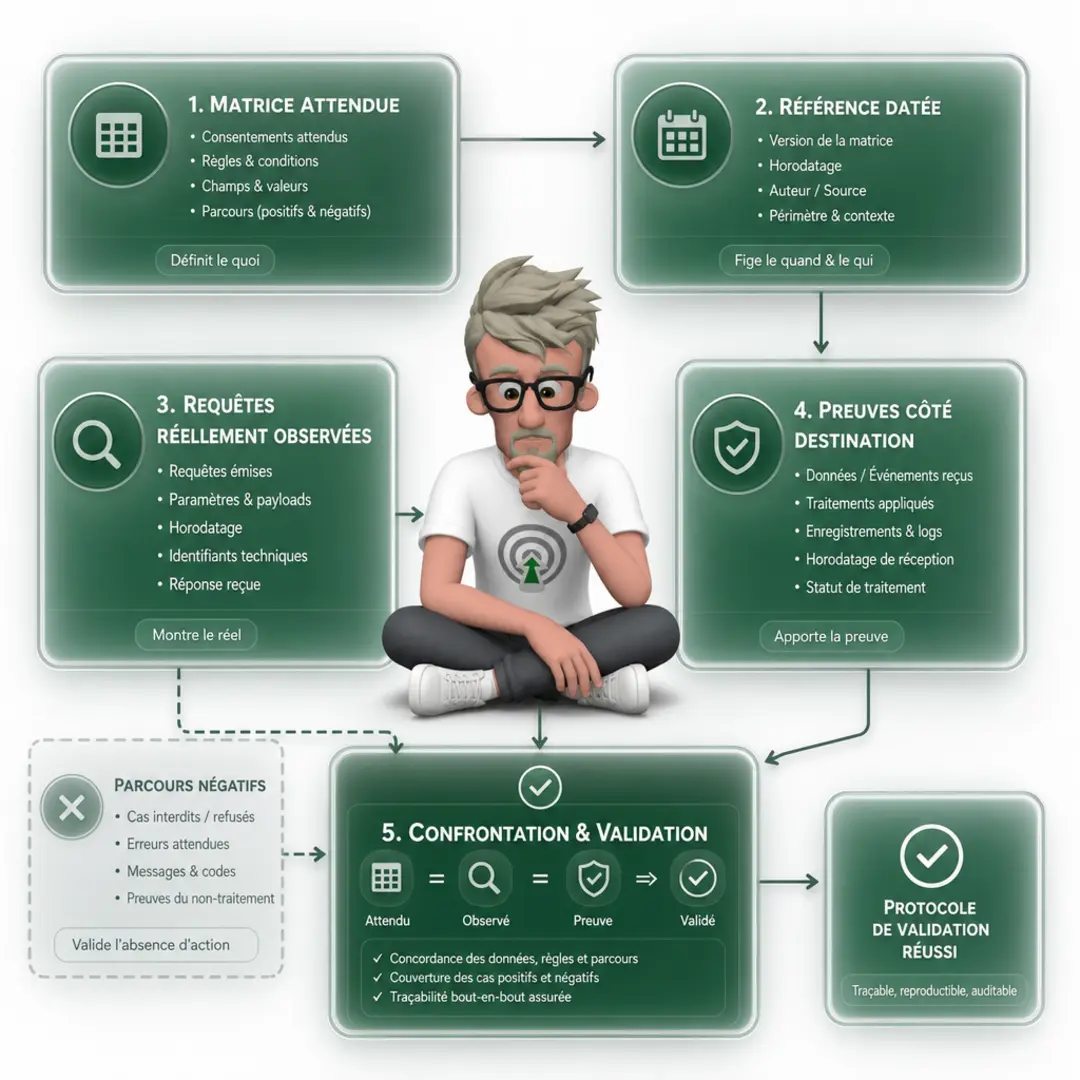
Je teste chaque état de consentement prévu par le dispositif, puis je vérifie le contenu réel des requêtes et des enregistrements. Un champ non autorisé ne doit pas être transmis. Une valeur vide, absente ou nulle doit produire le comportement prévu dans la matrice, pas une valeur de remplacement implicite. Je contrôle aussi les destinations : chaque donnée doit parvenir uniquement aux systèmes attendus, sans envoi parasite.
Je couvre les parcours nominaux et les parcours négatifs ou voisins, car c’est souvent là que les fuites apparaissent. Pour chaque test, je consigne le scénario, le résultat attendu, le résultat observé et une preuve vérifiable, par exemple une capture réseau horodatée ou un enregistrement côté destination.
- Répétition d’une action, pour vérifier qu’elle ne crée pas de transmission ou d’enregistrement inattendu.
- Actualisation de la page, pour contrôler la persistance de l’état et le comportement des nouvelles requêtes.
- Échec, annulation et erreur de validation, pour vérifier qu’aucune donnée non prévue n’est envoyée.
- Chargement différé, pour contrôler les requêtes déclenchées après le chargement initial.
Les identifiants pseudonymes stables ne sont testés qu’après approbation. Leur usage doit être associé à un résultat attendu explicite, à un responsable identifié et à une preuve vérifiable. Je consigne chaque écart sans lui attribuer de gravité ou de seuil qui n’aurait pas été défini.
Les tests alimentent la décision de validation métier et permettent de vérifier qu’un retour arrière restaure le comportement de référence. La mise en production ne se valide qu’avec les écarts examinés et la décision métier documentée.
Votre couche de données est-elle vérifiable ?
Une couche de données respectueuse repose sur un périmètre clair, un consentement modélisé avant les changements et un inventaire des balises, stockages et destinations. Chaque champ doit avoir une finalité, un état attendu et une validation métier ; les données personnelles directes, sensibles ou inutiles sont exclues. Les catégories générales limitent l’exposition du texte libre, tandis que le suivi des valeurs et l’inspection des requêtes rendent les flux vérifiables. Enfin, les tests doivent couvrir les états de consentement et les parcours négatifs, avec une comparaison à une référence datée. Vous obtenez ainsi des flux mieux maîtrisés et des décisions de collecte justifiables.
FAQ
- Que doit contenir une couche de données respectueuse de la vie privée ?
Uniquement des champs approuvés, nécessaires et associés à une finalité définie. Les champs inutiles ainsi que les données personnelles directes et sensibles doivent être exclus. - Que faut-il préparer avant de modifier le gestionnaire de balises ?
Une matrice technique du consentement, un état de référence daté, les exigences régionales, l’inventaire des balises, cookies, stockages et destinations, ainsi que les accès et scénarios de test. - Comment vérifier les données réellement transmises ?
Il faut comparer les requêtes ou enregistrements observés aux états attendus. L’inspection visuelle seule ne suffit pas ; les valeurs doivent aussi être vérifiées depuis leur source jusqu’à leur destination. - Comment gérer les états de consentement Google ?
Configurez les états par défaut avant le traitement des balises Google, puis transmettez les mises à jour lorsque l’utilisateur fait ou modifie son choix. Utilisez des API ou modèles CMP pris en charge. - Quand peut-on utiliser un identifiant pseudonyme stable ?
Uniquement après approbation. Son usage doit être défini comme un travail vérifiable, avec un résultat attendu, un responsable et une preuve à recueillir.
A propos de l’auteur
Je suis Franck Scandolera, expert en data engineering et en automatisation. J’aide les équipes à structurer des flux de données vérifiables, à cadrer leur collecte et à fiabiliser leur instrumentation, notamment pour les usages analytics et la performance digitale.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.