





La visibilité de l’IA se mesure uniquement quand une interaction laisse une trace exploitable. Je distingue les visites identifiables des conversions influencées mais non observées, puis je montre comment compléter l’analytics sans attribuer à l’IA des parcours qu’on ne peut pas prouver.
Besoin d'aide ? Découvrez les solutions de notre agence d'agents IA.
Que mesure vraiment la visibilité de l’IA ?
La visibilité de l’IA correspond à la part des interactions et des visites effectivement observables dans vos données. Elle recouvre deux mesures différentes : les visites identifiables comme provenant d’assistants d’IA, et l’influence éventuelle de ces assistants avant une visite ultérieure. La première peut apparaître dans les données de trafic. La seconde peut rester invisible si l’interaction avec l’IA n’a pas été enregistrée.
L’enquête Future of Web Analytics de Matomo, menée auprès de 300 spécialistes aux États-Unis, en Allemagne et en France, montre que le sujet pèse dans les préoccupations des répondants :
- 92,7 % jugent important le trafic provenant des plateformes d’IA.
- 85,7 % estiment que le trafic généré par l’IA a un impact important ou modéré sur leurs données analytiques.
- 53,7 % déclarent bénéficier d’une visibilité claire sur ce trafic, et 40,7 % d’une visibilité partielle.
- 42,7 % indiquent que l’IA les oblige à repenser la mesure de la performance, tandis que 41 % signalent une incertitude accrue dans les données.
Ces chiffres décrivent les réponses des personnes interrogées dans cette enquête. Ils ne permettent pas de généraliser ces constats à toutes les entreprises.
Le point central est la limite des données observées. L’analytics décrit les visites et les interactions qu’il enregistre, mais ne révèle pas nécessairement les échanges antérieurs avec un assistant d’IA lorsqu’ils sont absents des données. Un visiteur peut donc arriver sur votre site sans que son parcours précédent soit visible dans vos rapports. Mesurer les visites attribuables à l’IA ne revient pas à mesurer toute l’influence que l’IA a pu exercer avant la visite.
Que voit le suivi du trafic issu de l’IA ?
Le suivi du trafic issu de l’IA identifie les visites dont la provenance est enregistrée. C’est notamment le cas lorsqu’une personne clique sur un lien source affiché par un assistant et que le référent — l’information qui indique l’origine de la visite — est disponible.
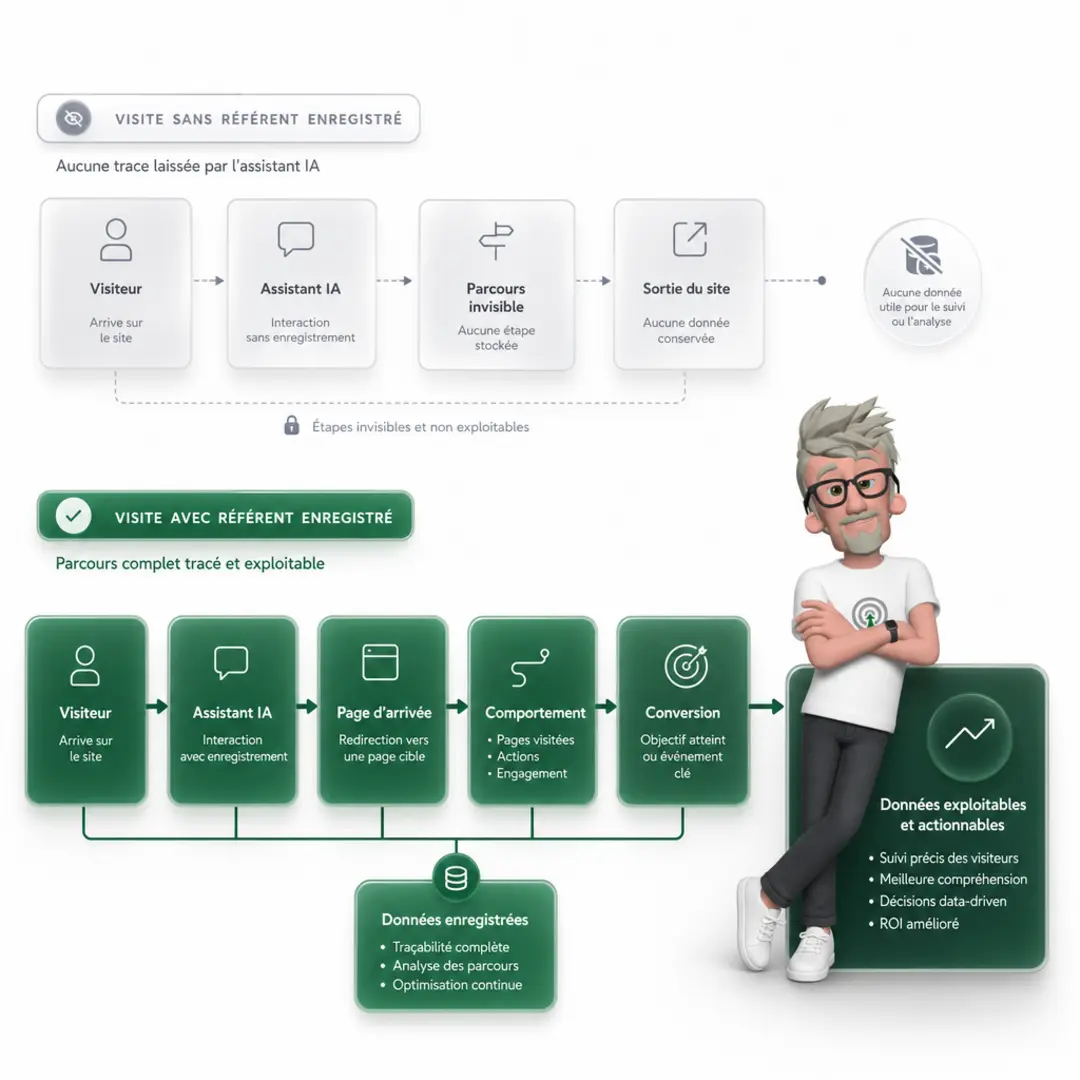
Pour ces visites identifiables, l’analytics permet d’observer ce qui se passe sur le site après le clic. J’examine notamment la page d’arrivée, le comportement de la personne, les conversions associées aux objectifs définis et les résultats observés.
- Page d’arrivée : la page sur laquelle la personne entre sur le site.
- Comportement : les actions réalisées pendant la visite, dans la limite des données enregistrées.
- Conversions : les objectifs atteints, comme une demande ou un achat, lorsqu’ils sont mesurés.
Cette mesure couvre uniquement la partie visible du parcours. Elle ne révèle pas, à elle seule, les recherches, les questions posées à un assistant ou les échanges antérieurs qui n’ont pas été enregistrés. Une visite identifiable est donc différente d’une simple possibilité d’influence : la première repose sur une provenance observée, la seconde reste une hypothèse.
Une visite directe ou organique ne peut pas être attribuée à l’IA sans preuve de provenance. Le fait qu’une personne ait pu voir une réponse d’IA avant sa visite ne suffit pas à établir ce lien.
Comme pour la visibilité partielle abordée dans le chapitre précédent, ces données restent utiles. Elles permettent de décrire les visites attribuables et leurs résultats, à condition de préciser ce qu’elles démontrent — et ce qu’elles ne permettent pas de conclure.
Pourquoi une conversion influencée peut-elle venir d’un autre canal ?
Oui, une conversion influencée par une interaction avec l’IA peut être enregistrée sous un autre canal si cette interaction n’a laissé aucune trace exploitable dans les données. Le canal mesuré décrit alors le point de contact observé avant la conversion, pas nécessairement l’ensemble du parcours.
| Parcours illustratif | Canal observé | Influence antérieure inconnue |
| Une personne compare des fournisseurs dans ChatGPT, puis revient sur le site après une recherche organique et convertit. | Recherche organique. | La comparaison dans ChatGPT, si elle n’est pas tracée, n’apparaît pas dans les données. |
| Une personne découvre une marque dans Perplexity, puis saisit son adresse pour revenir directement sur le site. | Trafic direct. | La découverte dans Perplexity reste invisible si aucun signal ne la relie à la visite. |
| Une personne découvre un produit avec un assistant, puis clique sur une campagne payante avant de convertir. | Campagne payante. | La découverte avec l’assistant n’est pas identifiable sans point de contact enregistré. |
Un modèle d’attribution multicanale peut répartir le crédit entre les interactions présentes dans les données. Il ne peut pas ajouter un contact avec une IA qui n’a pas été enregistré. Le résultat peut donc attribuer la conversion à la recherche organique, au direct ou au payant, sans révéler l’influence antérieure.
Règle opérationnelle : je conserve le canal observé et je ne le reclasse pas en trafic IA sans preuve. Un modèle d’attribution ne transforme pas une hypothèse en mesure. Pour mesurer la visibilité de l’IA avant la visite, je lis donc les données par couches : d’abord les canaux et interactions effectivement observés, puis les signaux spécifiques à l’IA, en séparant clairement les faits des zones non mesurées.
Comment analyser les données sans surattribuer l’IA ?
Je sépare les données directement enregistrées des indices contextuels. Une tendance ou une citation associée à l’IA peut éclairer l’analyse, mais ne prouve pas qu’un visiteur a interagi avec un assistant si cette interaction n’a pas été enregistrée.
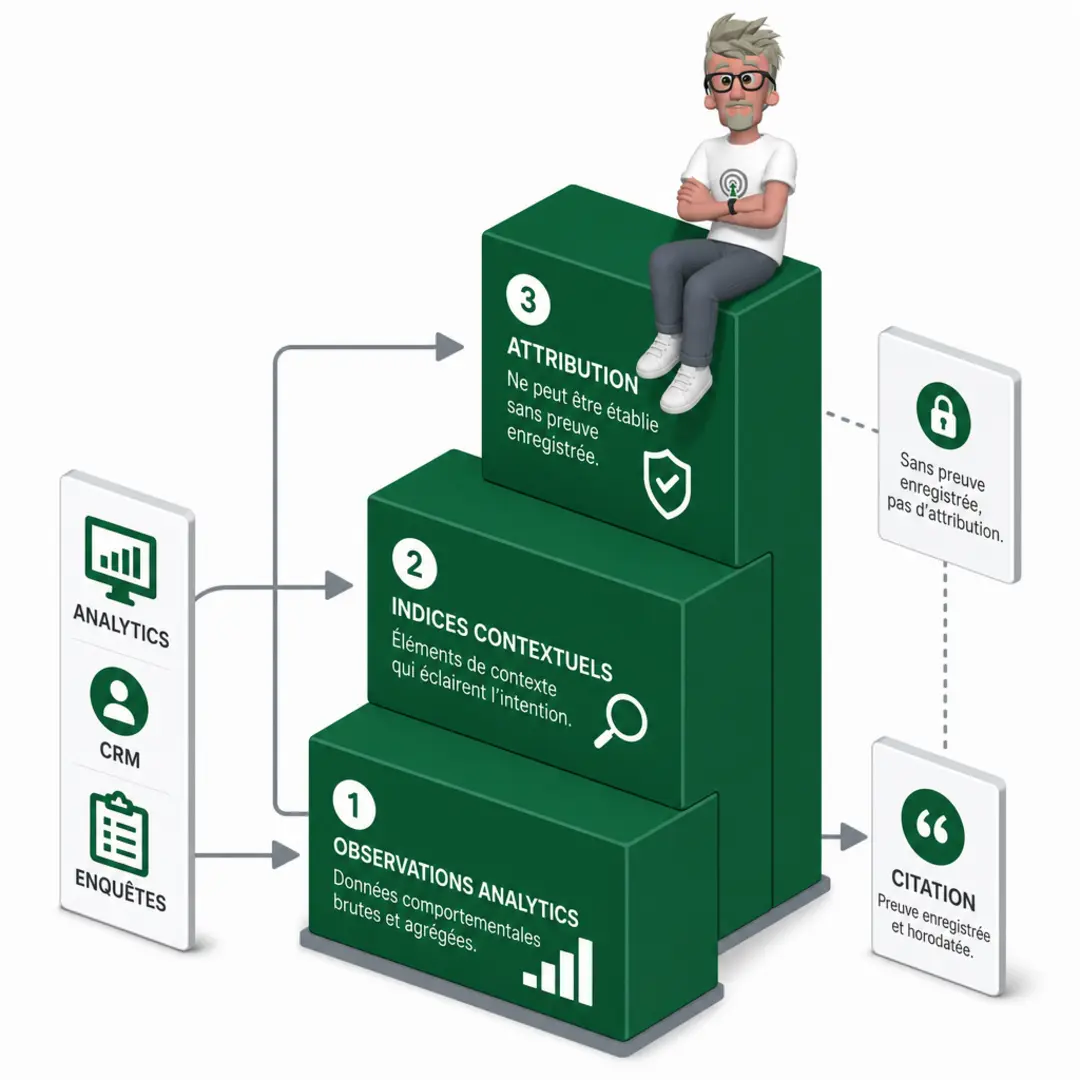
Première couche : les observations analytics. J’analyse les visites identifiables, les pages d’arrivée, le comportement observé et les conversions enregistrées. Un clic depuis un assistant avec un référent disponible peut être identifié comme tel dans les données de visite. Pour les autres parcours, l’analytics décrit ce qui est effectivement mesuré, pas nécessairement ce qui a déclenché la visite.
Deuxième couche : le contexte. Je rapproche ces observations des données CRM, des tendances de recherche de marque, des enquêtes auprès des clients et des outils de suivi des citations par l’IA. Chaque source peut aider à interpréter une évolution ou un parcours. Aucune ne prouve, à elle seule, une interaction avec un assistant si celle-ci n’a pas été enregistrée.
Je garde donc trois niveaux distincts : l’observation, c’est ce que les données enregistrent ; l’indice, c’est un signal compatible avec une influence de l’IA ; l’attribution, c’est le fait d’établir qu’un canal a contribué à une visite ou une conversion. Confondre ces niveaux conduit à surévaluer la contribution de l’IA.
| Parcours ou signal | Ce qui est observable | Ce qui reste inconnu | Sources de contexte possibles |
| Clic depuis un assistant avec référent disponible | Visite et référent, si enregistrés par l’analytics. | Le rôle exact de l’assistant dans la décision. | Données CRM, enquêtes clients. |
| Parcours organique après une interaction IA | Visite organique, page d’arrivée, comportement et conversion enregistrés. | L’interaction IA antérieure, si elle n’a pas été enregistrée. | Tendances de recherche de marque, enquêtes clients, suivi des citations par l’IA. |
| Retour direct après une découverte dans Perplexity | Visite directe et activité mesurée sur le site. | La découverte dans Perplexity, si elle n’a pas été enregistrée. | Données CRM, enquêtes clients, suivi des citations par l’IA. |
| Clic payant après une découverte avec un assistant | Clic payant et activité associée, si enregistrés. | La découverte préalable et son influence. | Données CRM, enquêtes clients. |
| Données CRM | Informations présentes dans le CRM. | Une interaction IA non consignée. | Tendances de recherche de marque, enquêtes clients. |
| Tendances de recherche de marque | Évolution des recherches de marque. | Leur origine précise. | Données CRM, enquêtes clients. |
| Enquêtes clients | Réponses déclarées par les clients. | Une interaction non mentionnée ou non mémorisée. | Données CRM. |
| Suivi des citations par l’IA | Citations détectées par l’outil. | Leur effet sur une visite ou une conversion. | Tendances de recherche de marque, enquêtes clients. |
Comment intégrer cette limite à la mesure de performance ?
La visibilité de l’IA avant la visite peut influencer un parcours sans apparaître comme un trafic attribuable dans les données disponibles. Il faut donc faire évoluer l’interprétation des performances sans confondre ce qui est mesuré et ce qui a pu contribuer à la décision.
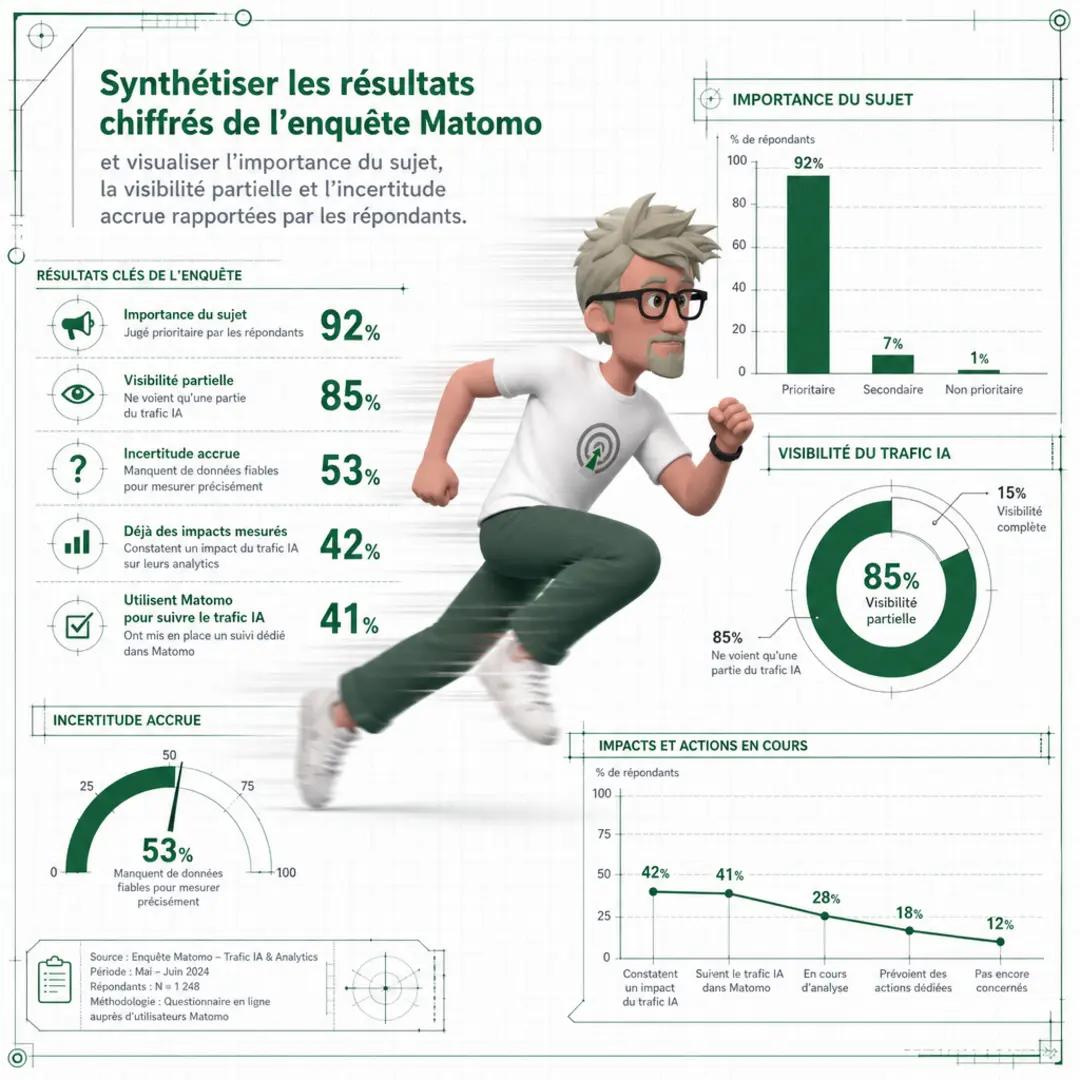
Les réponses à l’enquête confirment cette difficulté. 42,7 % des répondants disent que l’IA les oblige à repenser la mesure de la performance, et 41 % signalent une incertitude accrue dans les données. Ces constats invitent à préciser la portée des conclusions, pas à attribuer à l’IA des effets que les données ne montrent pas.
Dans l’analyse, je m’en tiens à quelques distinctions fondées sur les éléments observés :
- Je documente ce qui est directement observé, sans le compléter par une influence supposée.
- Je distingue les sources complémentaires de l’attribution. Elles peuvent apporter du contexte, mais ne prouvent pas qu’une interaction avec l’IA a généré une visite.
- Lorsqu’aucune interaction avec l’IA n’est enregistrée, je conserve le canal visible dans les données. Je ne le remplace pas par une origine IA hypothétique.
- Je signale les limites d’interprétation et sépare clairement les observations des hypothèses.
Ces principes aident à éviter les conclusions excessives. Ils ne constituent ni une méthodologie universelle ni une garantie d’attribution. Une influence potentielle avant la visite peut rester invisible dans les données disponibles ; elle ne doit pas être présentée comme un trafic mesuré.
| Ce que les données permettent d’affirmer | Les interactions et les canaux effectivement observés, ainsi que les limites des données disponibles. |
| Ce qu’elles ne permettent pas de prouver | Qu’une influence de l’IA non enregistrée a causé une visite ou une performance donnée. |
Que retenir pour mieux lire vos données ?
La visibilité de l’IA dépend d’abord des traces réellement enregistrées. Un clic provenant d’un assistant peut être analysé si son référent est disponible, mais une interaction antérieure suivie d’une visite organique, directe ou payante peut rester invisible. Je distingue donc le canal observé de l’influence supposée. Les données CRM, les recherches de marque, les enquêtes clients et le suivi des citations apportent du contexte, pas une preuve d’attribution. Cette lecture par couches évite de réécrire les parcours sans éléments mesurables. Vous pouvez ainsi interpréter vos performances avec plus de rigueur et mieux identifier ce que vos données permettent réellement d’affirmer.
FAQ
- Que signifie la visibilité de l’IA en analytics ?
Elle désigne la part des visites et interactions liées à l’IA qui sont effectivement identifiables dans les données. Une interaction antérieure non enregistrée peut rester invisible, même si une visite ultérieure est mesurée. - Comment identifier une visite provenant d’un assistant IA ?
Une visite peut être identifiée lorsqu’une personne clique sur un lien source d’un assistant et que le référent est disponible dans les données analytiques. On peut alors analyser la page d’arrivée, le comportement et les conversions observées. - Une conversion organique peut-elle avoir été influencée par ChatGPT ?
C’est possible, par exemple si une personne compare des fournisseurs dans ChatGPT puis revient via une recherche organique. Si cette interaction avec l’IA n’a pas été enregistrée, les données ne permettent pas de la prouver ni de reclasser le canal observé. - Un modèle d’attribution peut-il mesurer les interactions IA invisibles ?
Non. Un modèle multicanal peut répartir le crédit entre les interactions enregistrées, mais il ne peut pas créer un point de contact absent des données. - Quelles sources peuvent compléter l’analytics du trafic IA ?
Les données CRM, les tendances de recherche de marque, les enquêtes auprès des clients et les outils de suivi des citations par l’IA peuvent apporter du contexte. Ils ne prouvent pas à eux seuls une interaction qui n’a pas été enregistrée.
A propos de l’auteur
Je suis Franck Scandolera, expert en data engineering et en mesure de la performance digitale. J’aide les équipes à fiabiliser leurs analyses et à distinguer les signaux observables des hypothèses d’attribution, notamment face aux nouveaux parcours de recherche assistés par l’IA.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.