
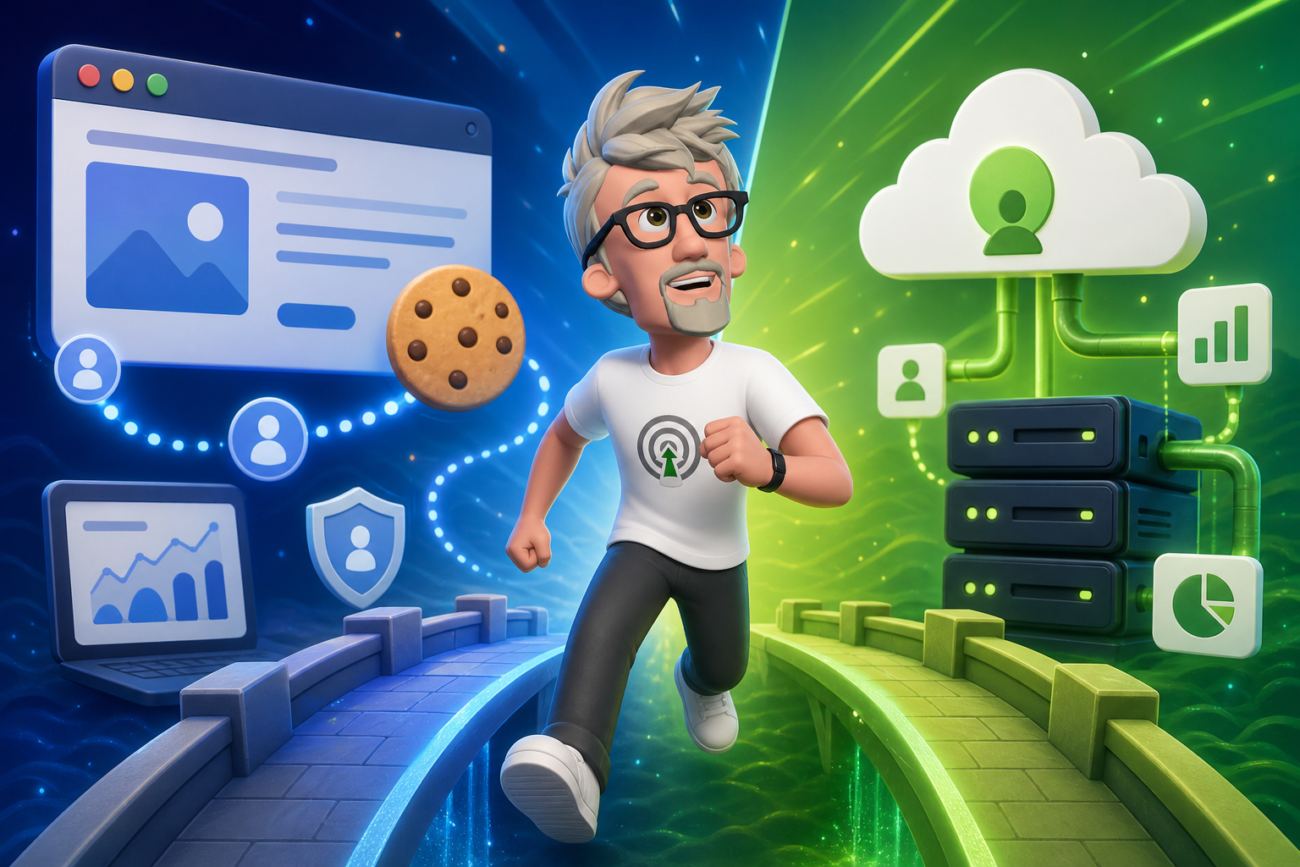





Le tracking client-side est rapide à déployer, mais dépend du navigateur et de l’implémentation des pages. Le server-side ajoute un routage contrôlé. Je compare leurs contraintes et montre pourquoi une architecture hybride, gouvernée et testable, répond souvent mieux aux besoins métier.
Besoin d'aide ? Découvrez les solutions de notre agence Tracking Server Side.
Quelles différences entre client-side et server-side ?
Le client-side collecte les interactions dans le navigateur. Le server-side ajoute une couche de routage contrôlée pour certains événements et certaines destinations. Le choix dépend des événements à mesurer, des contraintes de données et du niveau de contrôle opérationnel attendu.
En client-side, une balise ou un SDK (kit logiciel intégré à l’application) capte l’action, applique éventuellement des transformations, puis envoie l’événement aux outils d’analytics, de publicité ou d’expérimentation. Le navigateur et ses extensions peuvent bloquer ou interrompre ces envois. Les données partent aussi directement vers chaque destination configurée, ce qui multiplie les points d’intégration.
En server-side, le navigateur ou l’application transmet l’événement à un serveur de collecte. Celui-ci peut valider, enrichir ou filtrer les données, puis les router vers une ou plusieurs destinations. Le serveur peut aussi recevoir des événements de systèmes sources comme le CRM, le paiement ou le back-office. Le parcours est plus contrôlé, mais il faut exploiter cette couche : supervision, gestion des erreurs, reprises et documentation des transformations. Un serveur ne rend pas les données automatiquement fiables ni conformes.
| Critère | Client-side | Server-side |
| Fiabilité | Dépend du navigateur, du réseau et des bloqueurs. | Permet des reprises et une validation côté serveur, si elles sont mises en place. |
| Confidentialité | Les données sont envoyées depuis le navigateur aux destinations configurées. | Le routage et le filtrage sont centralisés, sans remplacer le consentement ni les règles de conservation. |
| Maintenance | Simple au départ, mais chaque outil peut ajouter ses propres balises. | Centralise les règles, au prix d’une infrastructure et d’une exploitation supplémentaires. |
| Coût et usages | Faible coût d’infrastructure. Adapté aux interactions d’interface et aux tests rapides. | Coût variable selon le volume et l’hébergement. Utile pour contrôler les flux, enrichir les événements ou intégrer des systèmes internes. |
Une architecture hybride est souvent pertinente : les interactions d’interface restent côté client, tandis que les événements sensibles ou critiques passent par le serveur. Ce n’est pas une règle universelle : une petite mesure produit peut ne pas justifier l’exploitation d’un pipeline dédié. La décision suivante consiste à identifier les événements qui nécessitent réellement ce contrôle.
Quels événements faut-il contrôler côté serveur ?
Je priorise côté serveur les événements métier qui exigent plus de contrôle ou de résilience : paiement confirmé, souscription, renouvellement, annulation ou création effective d’un compte. Le bon critère n’est pas le volume d’événements, mais le coût d’une mesure perdue, dupliquée ou falsifiée. Un clic sur un bouton reste généralement côté client ; une transaction validée par le système métier mérite une source serveur fiable.
Avant l’implémentation, je cadre chaque événement avec quatre éléments : le résultat métier attendu, le responsable fonctionnel, les systèmes dont dépend l’émission et la procédure de retour arrière. Je définis aussi les conditions d’émission, la gestion des doublons et le comportement en cas d’indisponibilité. Pour mesurer l’effet du changement, j’établis un état de référence daté : période, volumes, taux de conversion et éventuels écarts entre les sources. Après déploiement, je vérifie que l’événement permet bien de répondre à la question métier, pas seulement qu’il arrive dans l’outil analytics.
Chaque champ doit être cartographié de sa source faisant autorité jusqu’à chaque destination. Cette traçabilité évite les valeurs ambiguës et les transformations invisibles.
- Pour chaque champ, je documente le nom, le format, la source, la règle de transformation et les destinations concernées.
- Je définis les données strictement nécessaires et les identifiants autorisés, par exemple un identifiant de commande plutôt qu’une adresse e-mail si celle-ci n’est pas indispensable.
- Je conserve la provenance de chaque valeur. Si une donnée manque, je la recherche auprès de sa source faisant autorité ; je ne la déduis pas d’un texte affiché, d’une URL ou d’un élément de présentation.
Ce cadrage alimente une spécification partagée des intégrations : événements, champs, règles, responsabilités et gestion des erreurs. Elle permet aux équipes data, produit et ingénierie de livrer une mesure cohérente, vérifiable et réversible, sans faire dépendre les décisions métier d’une interprétation implicite du tracking.
Comment fiabiliser les données et le consentement ?
Pour fiabiliser les données, je trace les valeurs importantes de leur source à leur destination et je vérifie ce qui est effectivement transmis, pas seulement ce qui s’affiche dans l’interface. Un événement visible dans un outil de prévisualisation peut être absent de la requête serveur, mal typé ou envoyé avant l’obtention du consentement.
Pour chaque événement, je compare le contrat attendu avec la requête reçue. Je contrôle notamment :
- Les noms et les types : un champ doit garder le même nom et le même format partout, par exemple un montant numérique plutôt qu’une chaîne de caractères.
- La portée et le moment d’envoi : je vérifie que la valeur correspond au bon utilisateur, à la bonne session ou à la bonne transaction, et que l’événement part au bon moment, sans doublon.
- Les identifiants et la devise : les identifiants de transaction doivent rester cohérents entre les systèmes. La devise doit être explicite et au format convenu.
- Le consentement et les valeurs vides : je vérifie l’état transmis, les finalités autorisées et le comportement prévu si une valeur manque. Une valeur vide ne doit pas être transformée silencieusement en zéro ou en identifiant fictif.
L’état du consentement doit suivre l’événement tout au long du flux, du navigateur au serveur puis aux plateformes destinataires. Je conserve aussi les identifiants de corrélation, c’est-à-dire les références techniques qui permettent de relier une requête à son traitement, sans y ajouter de données personnelles inutiles. Si le consentement change, les événements suivants doivent refléter ce nouvel état ; un ancien statut ne doit pas être réutilisé par défaut.
Chaque intégration serveur doit s’appuyer sur une spécification partagée : nom du champ ou du paramètre, type, état attendu, règles de valeur absente et destination. Toute modification qui change le sens d’un champ doit être validée par la personne responsable de la donnée ou de l’implémentation, pas uniquement par l’équipe qui déploie le connecteur. La minimisation des données et les exigences de consentement se définissent dès la conception : on n’envoie que les champs nécessaires, pour une finalité autorisée. C’est souvent là que les erreurs coûteuses se préviennent le plus tôt.
Comment déployer et tester le tracking ?
Je déploie le tracking dans l’environnement sûr le plus restreint, une couche logique à la fois, avec un retour arrière défini avant chaque changement. Une préproduction représentative suffit souvent. Je limite d’abord le périmètre à un parcours et à un connecteur, puis j’élargis après validation.
Avant le déploiement, je vérifie les dépendances en amont et en aval. En amont : les événements applicatifs se déclenchent au bon moment, le consentement est respecté et les identifiants sont stables, sans exposer de données personnelles inutiles. En aval : les connecteurs reçoivent les bons événements, les champs sources sont correctement associés aux champs de destination et les règles de déduplication ne créent pas de doublons.
Je contrôle les requêtes réseau et les enregistrements effectivement transmis, puis leur interprétation dans la destination. Une interface peut afficher un événement « envoyé » alors qu’un bloqueur l’a interrompu, qu’un champ est vide ou que le connecteur l’a rejeté. C’est le payload réel — les données et paramètres transmis — qui confirme ce qui a été collecté et exploité.
Je teste aussi les parcours négatifs et connexes, pas seulement le scénario nominal :
- Répétition d’un clic, actualisation, échec de paiement, annulation et erreur de validation.
- Chargement différé, utilisateur récurrent, navigation mobile et changement de consentement en cours de session.
- Retour arrière après déploiement, avec vérification que les événements précédents restent cohérents.
Les restrictions des navigateurs et les bloqueurs peuvent supprimer ou retarder des requêtes. Une implémentation différente selon les pages, ou la multiplication des scripts et fournisseurs, crée aussi des écarts : événements doublés, ordre d’exécution instable, consentement incohérent. J’ai déjà vu un tracking correct sur la page d’accueil, mais absent après une navigation interne d’application monopage, car le changement de vue ne relançait pas l’événement.
Contrôles avant mise en production :
- Les événements, identifiants et consentements sont vérifiés.
- Les requêtes et enregistrements reçus correspondent au schéma attendu.
- Les parcours négatifs, mobiles et récurrents passent.
- Les bloqueurs, doublons et erreurs sont observés.
- Le retour arrière est testé et documenté.
Comment gouverner le routage server-side ?
Le routage server-side doit s’appuyer sur un endpoint propriétaire, des transformations documentées et une responsabilité clairement attribuée. Sans ces éléments, il devient difficile de savoir où les données sont modifiées, qui en répond et comment diagnostiquer un écart entre les systèmes.
Je commence par tenir une cartographie des points de collecte et des destinations. Pour chaque événement contrôlé, je documente son origine, les transformations appliquées et chacune de ses destinations. Cette traçabilité permet de comparer le parcours attendu au parcours réel, sans confondre collecte, traitement et transmission.
Les règles de gouvernance doivent couvrir les points suivants :
- Les points de collecte et les destinations, avec leur propriétaire et leur rôle dans le parcours.
- Les événements contrôlés, suivis de leur origine à chaque destination, ainsi que les transformations documentées.
- Les erreurs d’intégration, avec une gestion explicite : les situations prises en charge, la responsabilité du traitement et la manière de suivre leur résolution.
- Les tâches d’intégration idempotentes. Une tâche est idempotente quand son exécution répétée ne produit pas d’effets en double. C’est essentiel pour maîtriser les relances et éviter les doublons.
Je définis aussi les responsabilités liées à l’infrastructure, à la sécurité, à la supervision et aux coûts. Elles ne doivent pas rester implicites entre les équipes qui possèdent l’endpoint, exploitent le routage et administrent les destinations. Un incident ou une évolution de périmètre doit avoir un responsable identifiable.
Dans une architecture hybride, cette gouvernance donne un cadre commun aux flux client-side et server-side. Elle rend leurs rôles et leurs limites plus lisibles, et facilite les changements de destination ou de traitement sans perdre la maîtrise des parcours. C’est ce cadre qui permet de maintenir l’architecture hybride dans le temps.
Quelle approche retenir pour votre tracking ?
Le client-side reste adapté aux interactions du navigateur et se met rapidement en place, mais il dépend des pages, des restrictions du navigateur et des bloqueurs. Le server-side apporte un routage contrôlé, à condition de gérer ses transformations, ses erreurs, son infrastructure et ses coûts. Pour choisir, partez des événements métier qui exigent davantage de contrôle ou de résilience. Cartographiez chaque champ jusqu’à sa destination, minimisez les données et préservez le consentement ainsi que les identifiants de corrélation. Une architecture hybride, documentée, testée et gouvernée évite les choix par défaut. Vous obtenez un tracking plus vérifiable et mieux aligné sur vos besoins métier.
FAQ
-
Quelle est la différence entre le tracking client-side et server-side ?
Le client-side collecte les interactions directement dans le navigateur. Le server-side ajoute une couche de routage contrôlée pour certains événements et certaines destinations. -
Le tracking server-side remplace-t-il le tracking client-side ?
Pas nécessairement. Une architecture hybride peut associer la collecte navigateur au routage contrôlé des événements qui le nécessitent. -
Quels événements faut-il traiter côté serveur ?
Commencez par les événements métier qui nécessitent davantage de contrôle ou de résilience. Définissez leur résultat attendu, leurs dépendances et leur responsable. -
Que faut-il vérifier avant de déployer un changement de tracking ?
Vérifiez les champs et leurs sources, les événements applicatifs, le consentement, les identifiants, les connecteurs et les destinations. Testez aussi les répétitions, erreurs, annulations, appareils mobiles et changements de consentement. -
Comment limiter les risques liés aux données collectées ?
Définissez les données minimales nécessaires et les identifiants autorisés. Préservez l’état du consentement et tracez les valeurs de leur source jusqu’à leur destination.
A propos de l’auteur
Je suis Franck Scandolera, expert en data engineering et en performance digitale. J’aide les équipes à structurer des dispositifs de mesure fiables, à tracer les données de leur source jusqu’à leur destination et à intégrer le consentement dans leurs flux de tracking.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.