





Une architecture Server-Side GTM fiable repose sur des flux cartographiés, des données minimisées et des responsabilités définies. Je détaille comment cadrer les événements, mettre en place une collecte first-party, configurer les destinations et contrôler les transformations, avec une référence mesurable et un plan de retour arrière.
Besoin d'aide ? Découvrez les solutions de notre agence Tracking Server Side.
Quel périmètre définir avant de commencer ?
Avant toute modification, je définis les événements métier concernés et les destinations qui doivent les recevoir. Le périmètre précise le résultat observable attendu : par exemple, un événement « purchase » transmis une seule fois à une destination donnée, avec les paramètres requis et sans champ exclu.
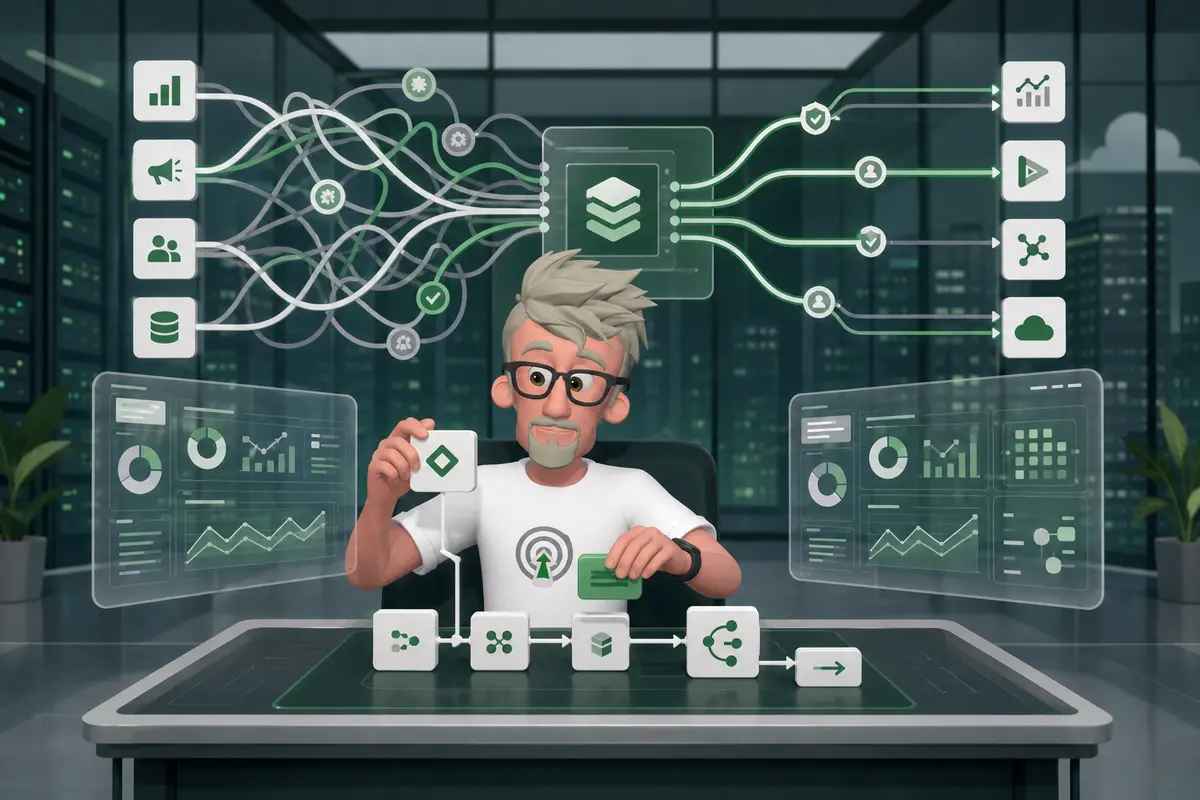
Je cartographie le flux complet, du déclenchement dans le navigateur jusqu’à chaque destination : événements entrants, transformations dans Server-Side GTM, déclencheurs, balises et réponses des services destinataires. J’y associe les dépendances qui peuvent modifier le résultat, comme les conteneurs Web et serveur, les domaines de collecte, les clés d’API, les règles de consentement et les intégrations tierces.
Pour chaque événement, la spécification doit rendre les données contrôlables. Elle indique les champs et paramètres attendus, leur format, les variantes autorisées, les valeurs obligatoires et les identifiants approuvés. Elle précise aussi les données interdites ou exclues du flux. La gouvernance fixe qui peut accéder aux données et qui valide les changements avant leur mise en production.
Je documente les responsabilités et le retour arrière avant le déploiement. La répartition doit nommer les responsables de l’infrastructure, de la sécurité, de la surveillance et des coûts, ainsi que la personne habilitée à approuver les changements. Le plan de retour arrière indique la configuration antérieure à restaurer, le responsable de l’opération et les conditions qui déclenchent cette restauration.
La référence de comparaison doit être datée et suffisamment précise pour distinguer une régression d’une variation normale. J’y consigne les événements observés, leurs paramètres, les destinations, les volumes et les résultats de transmission dans les conditions de mesure retenues.
| Élément | À consigner |
| Flux | Source, transformations, déclencheurs et destinations |
| Données | Champs requis, variantes autorisées, identifiants approuvés et exclusions |
| Référence | Date, conditions de mesure et résultats observés |
| Responsabilités | Infrastructure, sécurité, surveillance, coûts et validation |
| Retour arrière | Configuration précédente, responsable et conditions d’activation |
Comment organiser une collecte first-party ?
J’organise la collecte autour d’un point de collecte first-party, puis je réalise les changements dans l’environnement le plus sûr qui permet de vérifier le comportement réel. Je ne modifie qu’une seule couche logique à la fois : la collecte applicative, le transport ou le traitement côté serveur. Ça limite les causes possibles en cas de régression.
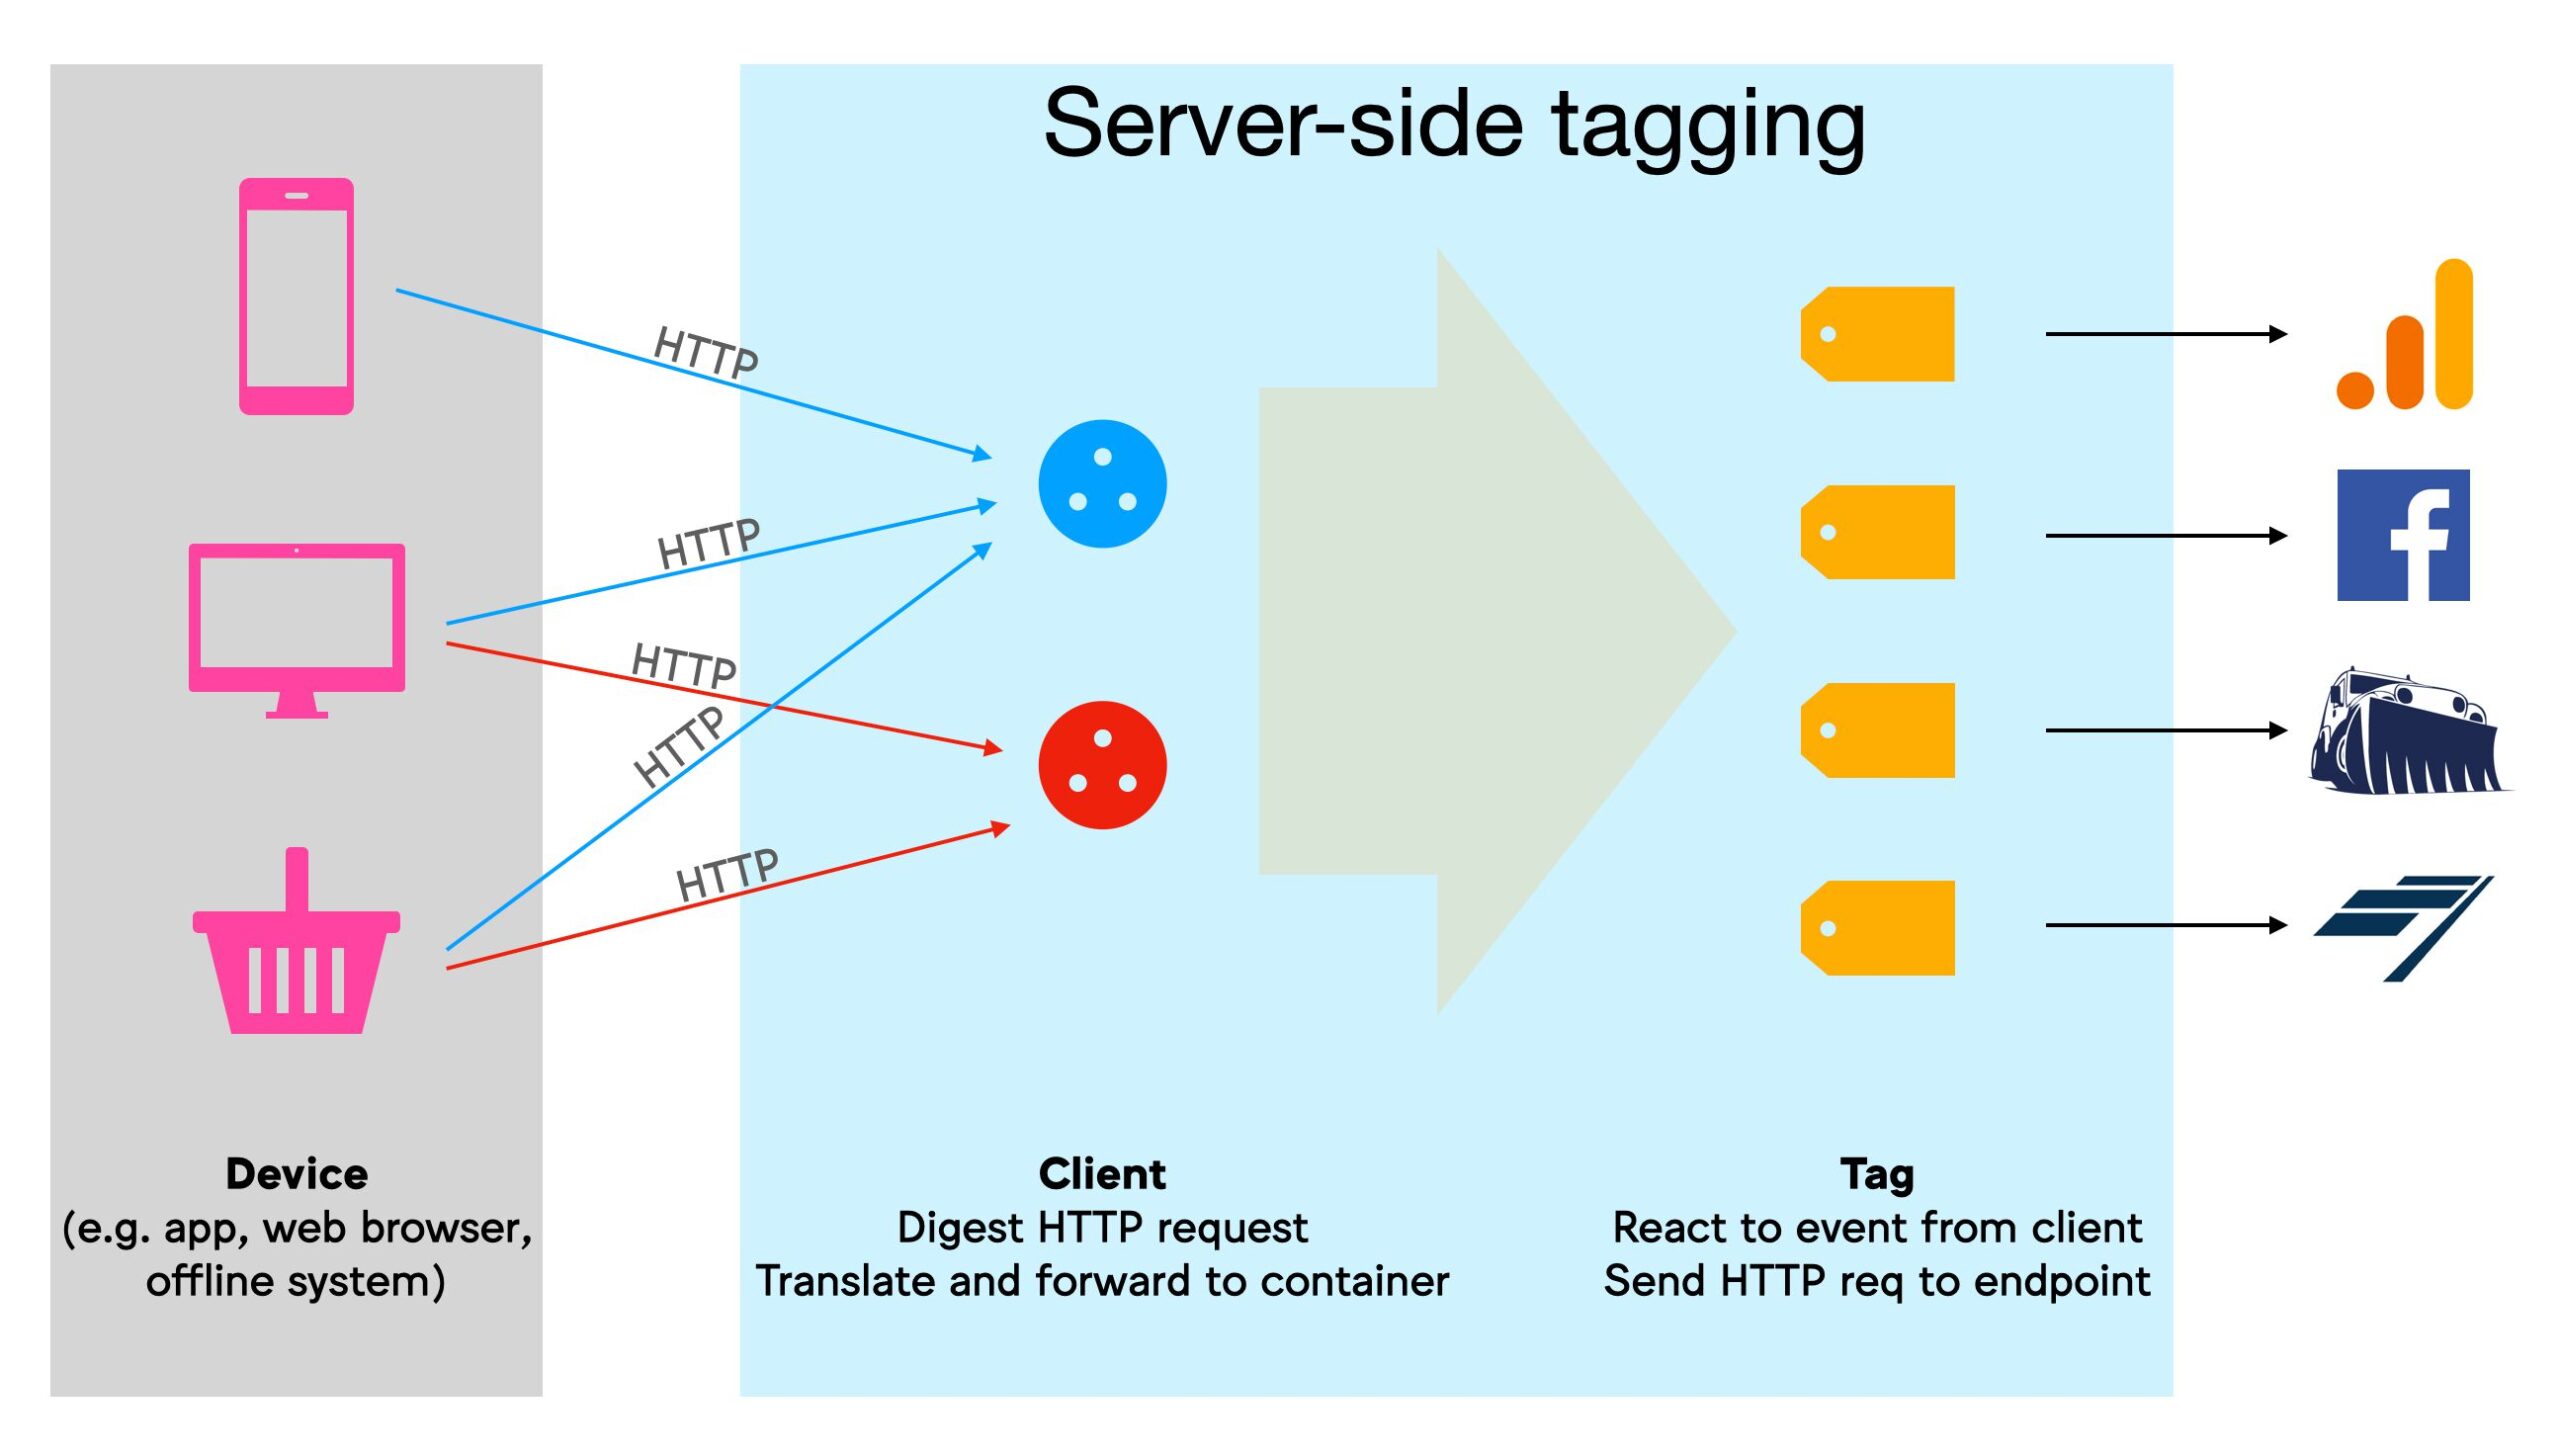
Avant toute modification, je cartographie les dépendances dans les deux sens. Je rattache cette cartographie au périmètre et à la référence définis précédemment, pour vérifier que chaque donnée et chaque destination restent dans le cadre prévu.
| Élément | À documenter |
| Événements applicatifs | Événement émis, déclencheur et champs transmis. |
| Consentement | État associé à l’événement et règles qui encadrent son usage. |
| Identifiants | Identifiants présents, origine et rôle dans la corrélation. |
| Connecteurs | Destinations concernées et données qu’elles reçoivent. |
| Champs source | Champ d’origine, transformations appliquées et champ transmis. |
Cette cartographie sert de référence pour chaque changement. Je vérifie les dépendances en amont avant de modifier la collecte, puis les dépendances en aval après le traitement. Un champ renommé ou transformé peut interrompre une destination sans que le point de collecte paraisse défaillant.
Pour garder une provenance explicite, chaque donnée doit rester rattachable à sa source et aux transformations qui l’ont affectée. Je conserve l’état du consentement avec l’événement auquel il s’applique ; je ne le remplace pas par une valeur plus simple qui ferait perdre de l’information. Je préserve aussi les identifiants de corrélation tout au long du parcours, sans en changer le rôle ni en créer de nouveaux hors du périmètre établi.
Je valide chaque couche séparément, en comparant les événements, les champs, le consentement et les identifiants avant et après le changement. Si l’écart ne s’explique pas par la modification ciblée, je ne poursuis pas le déploiement. Cette discipline évite de confondre une rupture de collecte avec un problème de consentement, de transformation ou de destination.
Quels clients et balises faut-il configurer ?
Configurez uniquement les clients et les balises nécessaires aux événements et aux destinations retenus. Chaque client doit interpréter les requêtes réellement prévues ; chaque balise doit transmettre les données utiles à une destination validée. Le reste augmente la surface de risque et complique le diagnostic.
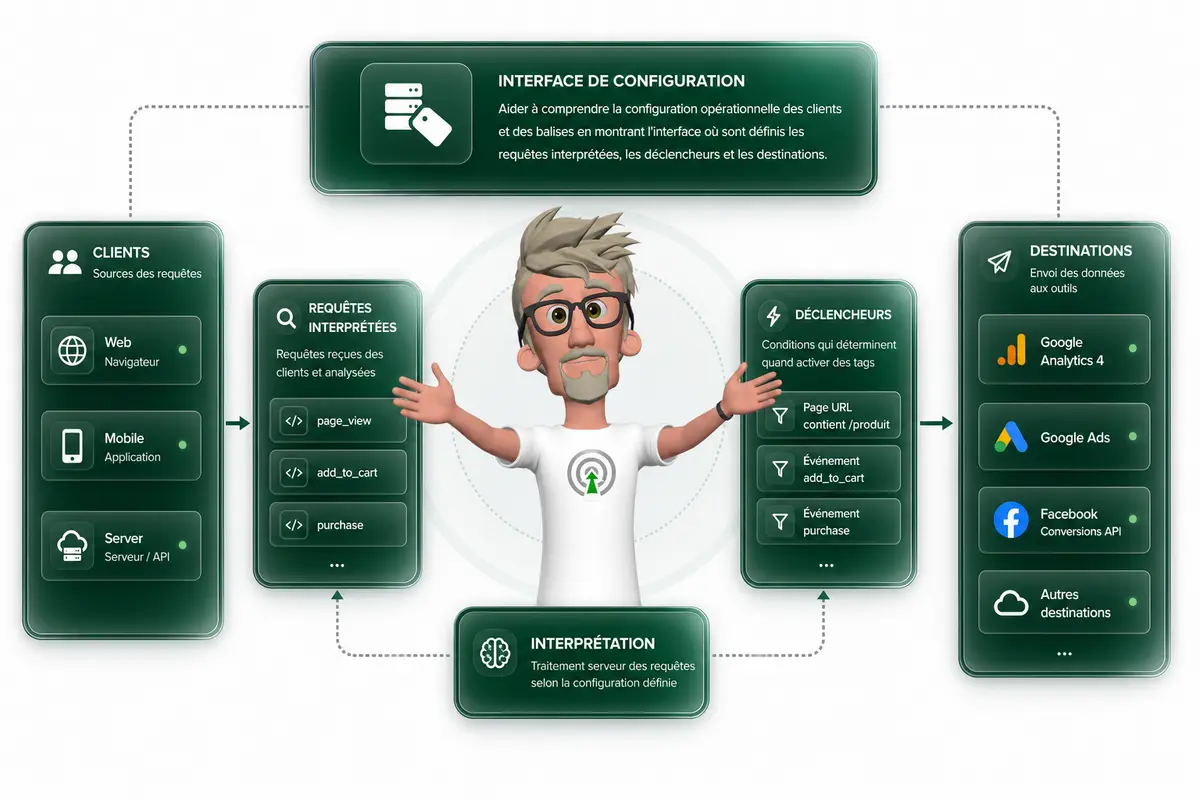
Pour chaque valeur transmise, documentez son chemin depuis la source faisant autorité jusqu’à la destination. Une source faisant autorité est le système qui détient la valeur de référence, par exemple le site ou le système transactionnel. Vérifiez que la valeur reçue par le client, transformée dans le conteneur serveur et envoyée par la balise reste cohérente.
Contrôlez les points suivants pour chaque événement et chaque champ retenu :
- Le nom correspond à celui attendu par la destination, sans ambiguïté ni doublon.
- Le type est correct : une valeur numérique ne doit pas devenir une chaîne, et une valeur booléenne doit conserver son sens.
- La portée est maîtrisée : événement, session ou utilisateur, selon le besoin réel.
- Le moment d’envoi correspond au déclenchement attendu, sans envoi prématuré ni répétition involontaire.
- Les identifiants désignent la bonne entité et ne sont pas remplacés par une valeur de test.
- Les montants et les devises sont cohérents avec la source et avec les conventions de la destination.
- Le consentement est respecté au moment de l’envoi ; l’absence d’autorisation ne doit pas être contournée par une autre balise.
- Les valeurs vides, nulles ou absentes sont traitées explicitement, plutôt que transmises comme des données valides.
La minimisation des données s’applique aussi aux champs : ne transmettez pas une valeur simplement parce qu’elle est disponible. Chaque champ doit répondre à une finalité définie et être nécessaire à la mesure ou au traitement retenu.
L’inspection visuelle du conteneur ne suffit pas. Contrôlez les requêtes sortantes ou les enregistrements effectivement reçus par la destination, en vérifiant les valeurs, leur format et leur présence selon le consentement. Comparez les résultats aux critères de référence et aux validations définis précédemment : si un écart apparaît, corrigez la configuration avant la mise en production.
Comment contrôler les données sortantes ?
J’applique des transformations aux données sortantes pour normaliser les valeurs utiles et exclure les champs qui ne doivent pas atteindre une destination. Le contrôle porte sur chaque flux réel : un client collecte les données, une balise les transmet, et la provenance permet de relier le champ envoyé à son origine.
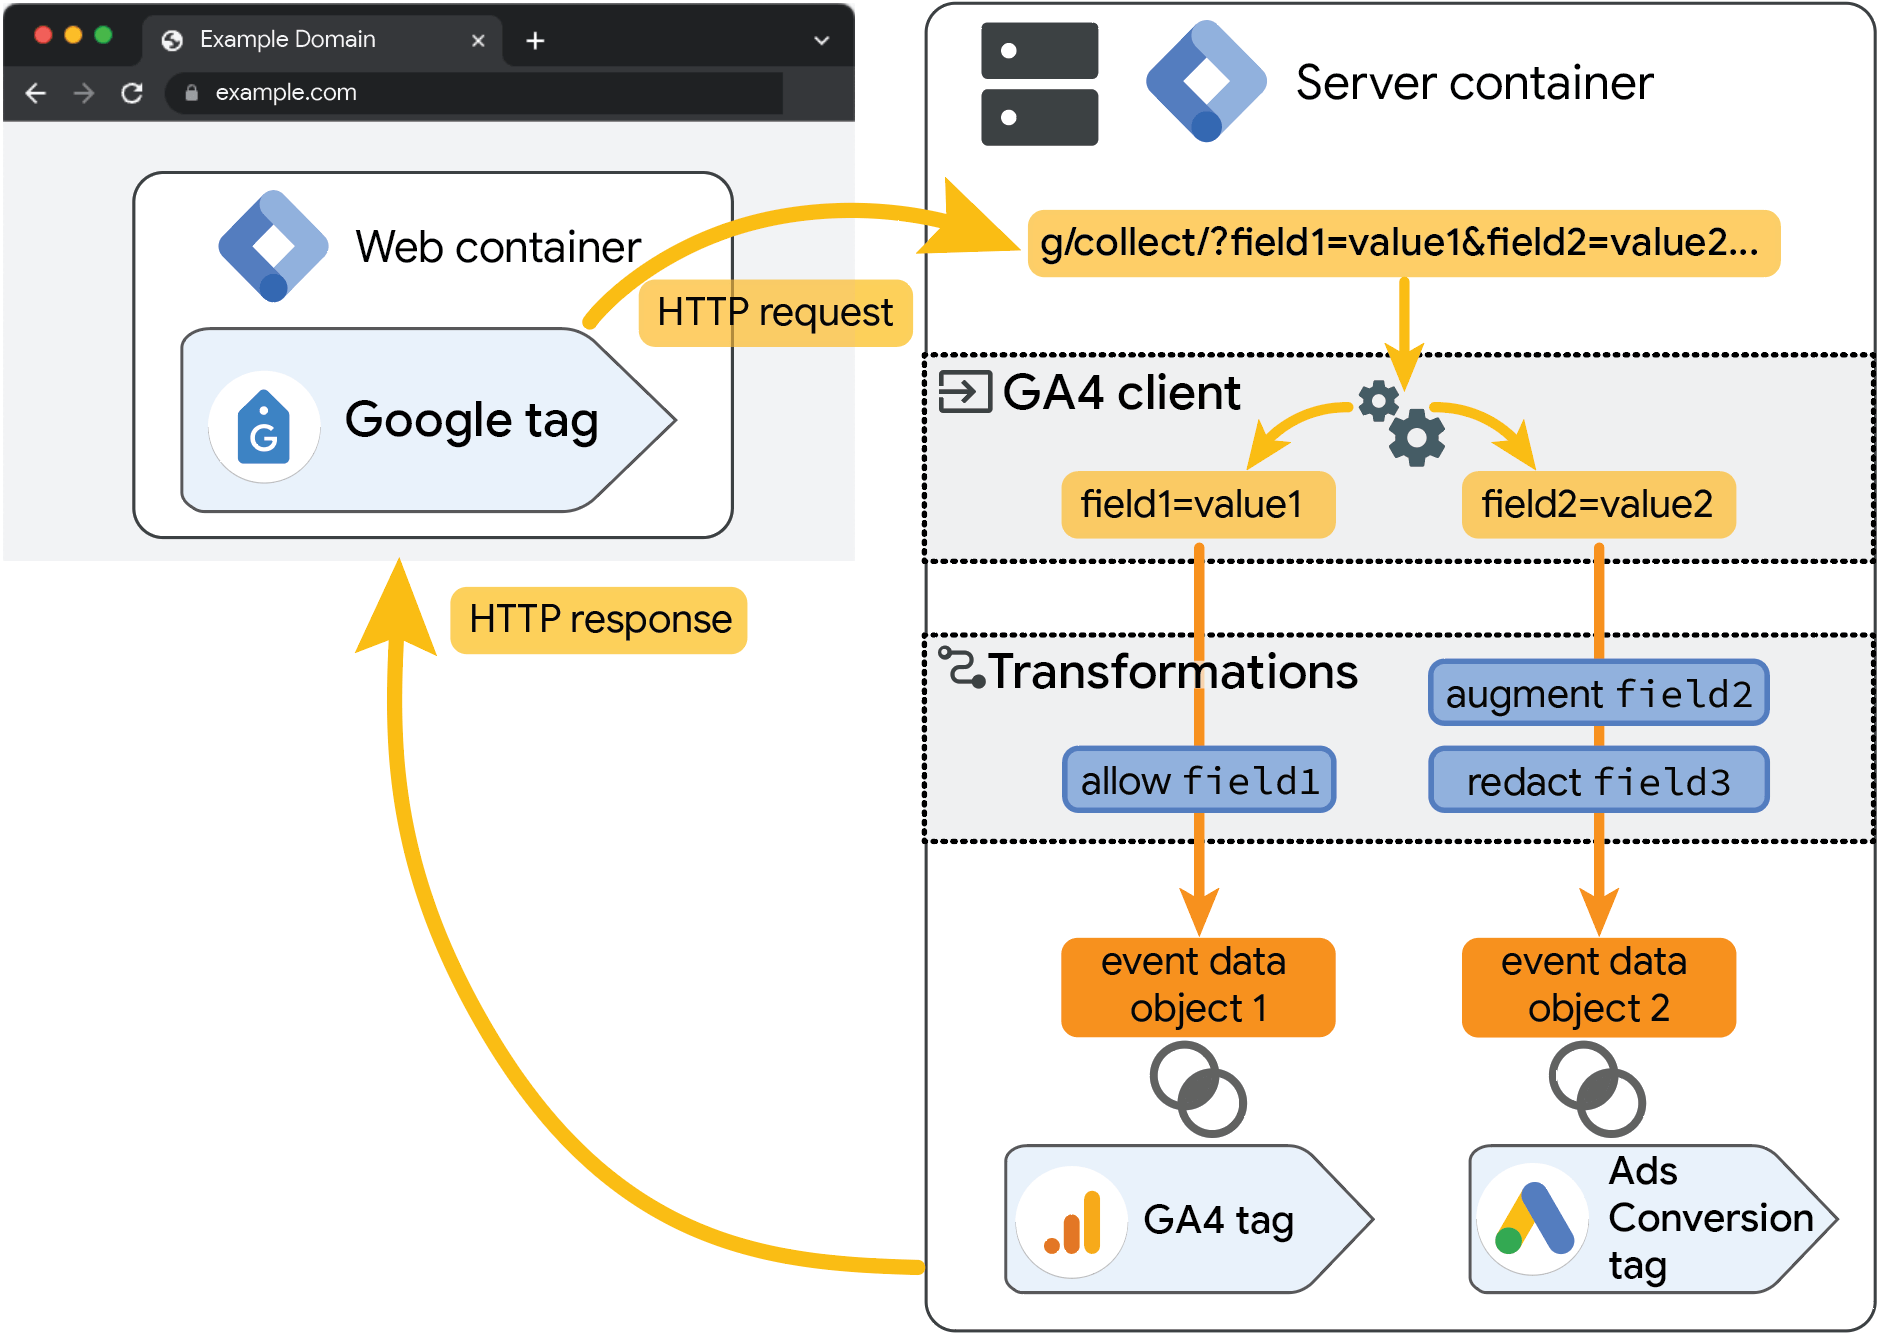
Je définis une référence attendue pour chaque destination : champs autorisés, format attendu, identifiants approuvés et conditions liées au consentement. Un identifiant approuvé est un identifiant explicitement autorisé pour cet usage, pas simplement une valeur disponible dans l’événement. La transformation doit préserver les données nécessaires sans élargir le périmètre de collecte.
Je vérifie les scénarios négatifs et les cas adjacents, pas seulement le parcours nominal. Par exemple :
- Un champ sensible ou inconnu est présent dans l’événement : il ne doit pas apparaître dans la requête sortante.
- Un identifiant manque, change de format ou ne fait pas partie des identifiants approuvés : la sortie doit rester conforme à la règle définie.
- Le consentement est refusé, absent ou modifié : les champs et les destinations concernés doivent respecter cet état.
- Une valeur vide, invalide ou inattendue arrive via un autre client : elle ne doit pas contourner les règles appliquées au parcours principal.
Je compare ensuite les données transformées à la référence, champ par champ, puis j’inspecte les requêtes réellement transmises ou les enregistrements reçus par la destination. Un test unitaire sur la transformation ne suffit pas : une balise peut ajouter, renommer ou réintroduire un champ en aval. Je vérifie donc la sortie finale, en reliant chaque donnée à son client, à la balise responsable et à sa provenance.
Sur un audit, l’écart le plus fréquent n’était pas dans la transformation prévue, mais dans une balise secondaire qui envoyait encore un identifiant non attendu. Le contrôle doit couvrir toutes les routes de sortie, y compris les chemins d’erreur et les événements moins fréquents. Je conserve les preuves de test et rejoue ces vérifications après chaque changement de client, de balise ou de règle de consentement.
Comment fiabiliser l’exploitation et les changements ?
Je fiabilise l’exploitation en définissant les responsabilités, le suivi des flux, la gestion des erreurs et le retour arrière avant chaque changement. Sans ces règles, un événement perdu ou dupliqué devient difficile à localiser, et les corrections risquent d’ajouter de l’instabilité.
Chaque événement doit pouvoir être suivi depuis son origine jusqu’à chacune de ses destinations. Je documente son point d’entrée, les transformations appliquées, les conditions de routage et le résultat attendu pour chaque système destinataire. Les journaux doivent permettre de vérifier les étapes clés, avec les horodatages et les identifiants disponibles, sans y exposer de données personnelles inutiles.
La surveillance porte sur les volumes, les erreurs et les écarts entre les étapes du flux. Je définis qui reçoit les alertes, qui qualifie l’incident et qui peut intervenir sur le conteneur, l’infrastructure ou les intégrations. Un incident doit laisser une trace exploitable : événement concerné, destination touchée, période, impact et décision prise. Dans un projet client, c’est souvent l’absence de propriétaire clairement désigné qui rallonge le diagnostic.
Pour une intégration avec un backend ou un CRM, je prévois des traitements idempotents : répéter le traitement d’un même événement ne doit pas produire plusieurs effets métier. Les erreurs doivent aussi être gérées explicitement, avec des règles définies pour les distinguer et décider du traitement à appliquer. Ces règles dépendent du système concerné ; elles doivent être validées avec son responsable.
Avant toute modification, je conserve une référence datée des volumes, taux d’erreur et résultats observés. Je change une seule couche logique à la fois — collecte, transformation, routage ou destination — puis je compare les résultats à cette référence. Le plan de retour arrière doit être prêt avant le déploiement, pas improvisé après une régression.
| Objectif | Contrôle | Responsabilité |
| Suivre chaque événement | Origine, étapes et résultat par destination | Équipe Data ou tracking |
| Détecter et traiter les incidents | Journaux, alertes, qualification et suivi | Exploitation et propriétaire du flux |
| Protéger les systèmes métier | Idempotence et règles d’erreur explicites | Responsable backend ou CRM |
| Sécuriser les changements | Référence datée, couche modifiée, retour arrière | Responsable du déploiement |
Votre architecture est-elle prête à évoluer ?
Une architecture Server-Side GTM fiable commence par un périmètre mesurable : événements métier, destinations, champs approuvés, responsables et référence datée. Le point de collecte first-party doit s’inscrire dans des flux cartographiés, avec une provenance explicite et un état de consentement préservé. Côté configuration, limitez-vous aux clients et balises utiles, puis vérifiez les valeurs réellement transmises, pas seulement l’interface. Les transformations contrôlent les champs sortants et doivent aussi être évaluées sur les scénarios négatifs. Enfin, documentez la surveillance, la journalisation, les erreurs et le retour arrière. Vous obtenez ainsi une collecte plus maîtrisée, vérifiable et exploitable sans transmettre de données superflues.
FAQ
- À quoi sert une architecture Server-Side GTM ?
Elle organise la collecte et l’acheminement des événements vers les destinations retenues, avec des contrôles sur les champs transmis, le consentement et les transformations. - Que faut-il définir avant de modifier le conteneur ?
Le périmètre d’événements et de destinations, les flux et dépendances, les champs attendus, les responsables, une référence datée et un plan de retour arrière. - Pourquoi utiliser un point de collecte first-party ?
Il constitue le point de collecte de l’architecture. Sa mise en œuvre doit préserver la provenance des données, le consentement et les identifiants de corrélation, tout en vérifiant les dépendances en amont et en aval. - Comment vérifier les données envoyées aux destinations ?
Tracez chaque valeur de sa source faisant autorité à sa destination. Contrôlez les noms, types, portées, identifiants, devises, consentement et valeurs vides, puis vérifiez les requêtes ou enregistrements transmis. - Quels contrôles prévoir pour une intégration backend ou CRM ?
Prévoyez des traitements idempotents et une gestion explicite des erreurs. Définissez aussi la journalisation, la surveillance, les responsabilités et le retour arrière associé aux changements.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Analytics, Data engineering et automatisation IA. J’accompagne les équipes dans la conception de dispositifs de collecte, la gouvernance des données et la fiabilisation des flux entre les outils d’analyse et les systèmes métier.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.