
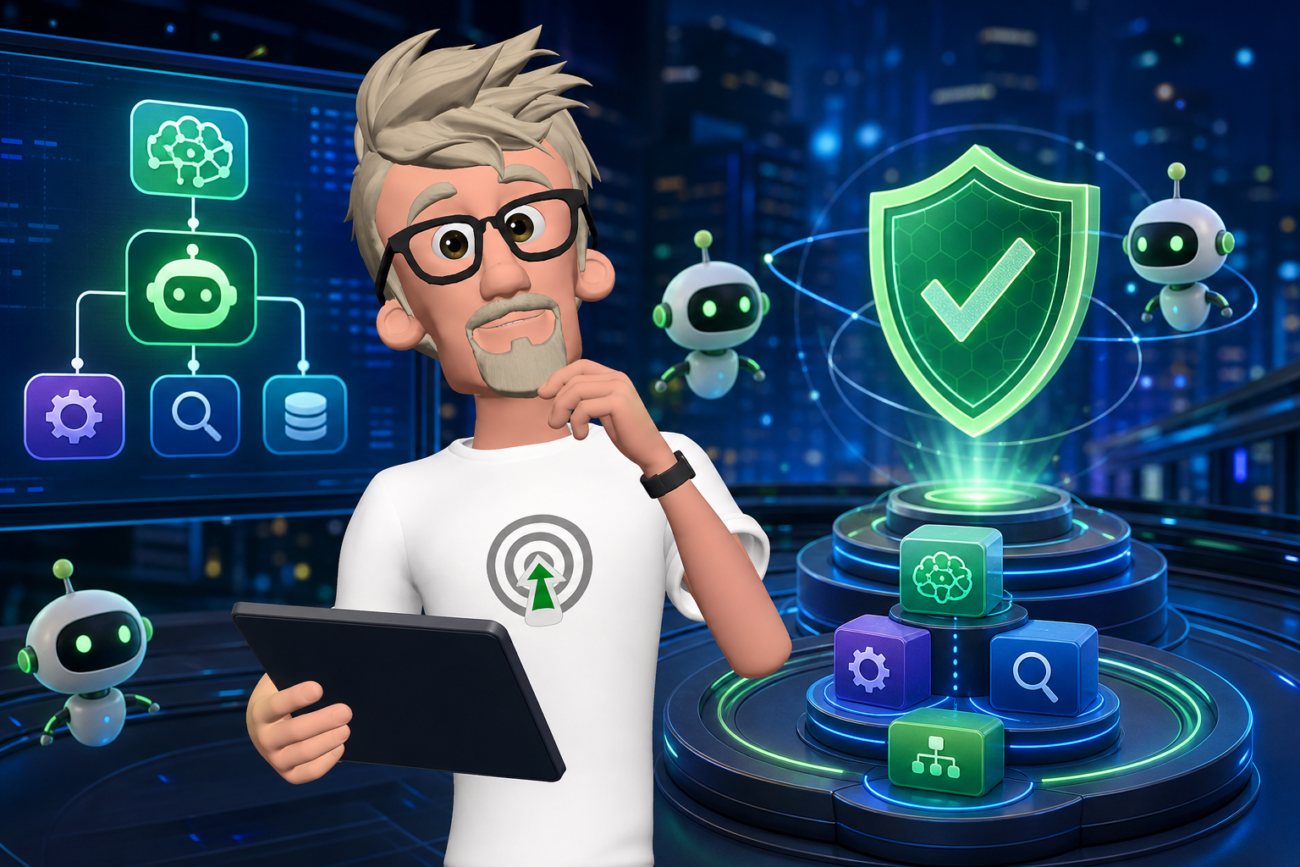





Un agent d’IA autonome poursuit un objectif, planifie des actions et utilise des outils avec peu d’intervention humaine. Cette capacité accélère les opérations, mais augmente aussi les risques. Je décris son architecture, ses niveaux d’autonomie et les garde-fous nécessaires pour mieux maîtriser son déploiement.
Besoin d'aide ? Découvrez les solutions de notre agence d'agents IA.
Qu’est-ce qu’un agent d’IA autonome ?
Un agent d’IA autonome poursuit un objectif, perçoit son environnement, agit et peut adapter son comportement avec peu d’intervention humaine. Son autonomie ne signifie pas qu’il agit sans limites : elle décrit sa capacité à avancer vers un résultat en ajustant ses actions à ce qu’il observe.
L’objectif définit ce que l’agent doit accomplir. L’adaptation lui permet de modifier son comportement lorsque les informations disponibles ou l’état de la tâche évoluent. La persistance signifie qu’il peut poursuivre une tâche dans le temps, en enchaînant plusieurs actions plutôt qu’en exécutant une seule instruction isolée.
Ce fonctionnement diffère d’une automatisation classique à règles fixes. Celle-ci suit des conditions et des étapes prédéfinies ; elle ne réévalue pas spontanément son comportement en fonction d’un objectif. Un agent peut, lui, choisir ou ajuster ses actions pour poursuivre cet objectif. Les deux approches ne sont donc pas interchangeables.
Cette autonomie peut améliorer la productivité en prenant en charge des tâches qui demandent plusieurs actions. Elle peut aussi accélérer leur exécution et rendre le traitement plus cohérent d’une occurrence à l’autre. Ces gains restent potentiels : ils dépendent de la tâche et du comportement de l’agent.
La même capacité d’agir avec peu d’intervention humaine augmente les risques. Plus l’agent est indépendant, plus ses actions peuvent se poursuivre sans validation humaine immédiate. Comprendre son objectif, sa capacité d’adaptation et sa persistance est donc un préalable pour déterminer le niveau de contrôle adapté.
Comment fonctionne l’architecture d’un agent autonome ?
Un agent autonome combine des entrées, un cœur de raisonnement généralement fondé sur un modèle de langage, une mémoire et des outils. Cette architecture lui permet de transformer une demande en actions, puis d’ajuster son comportement selon les résultats obtenus.
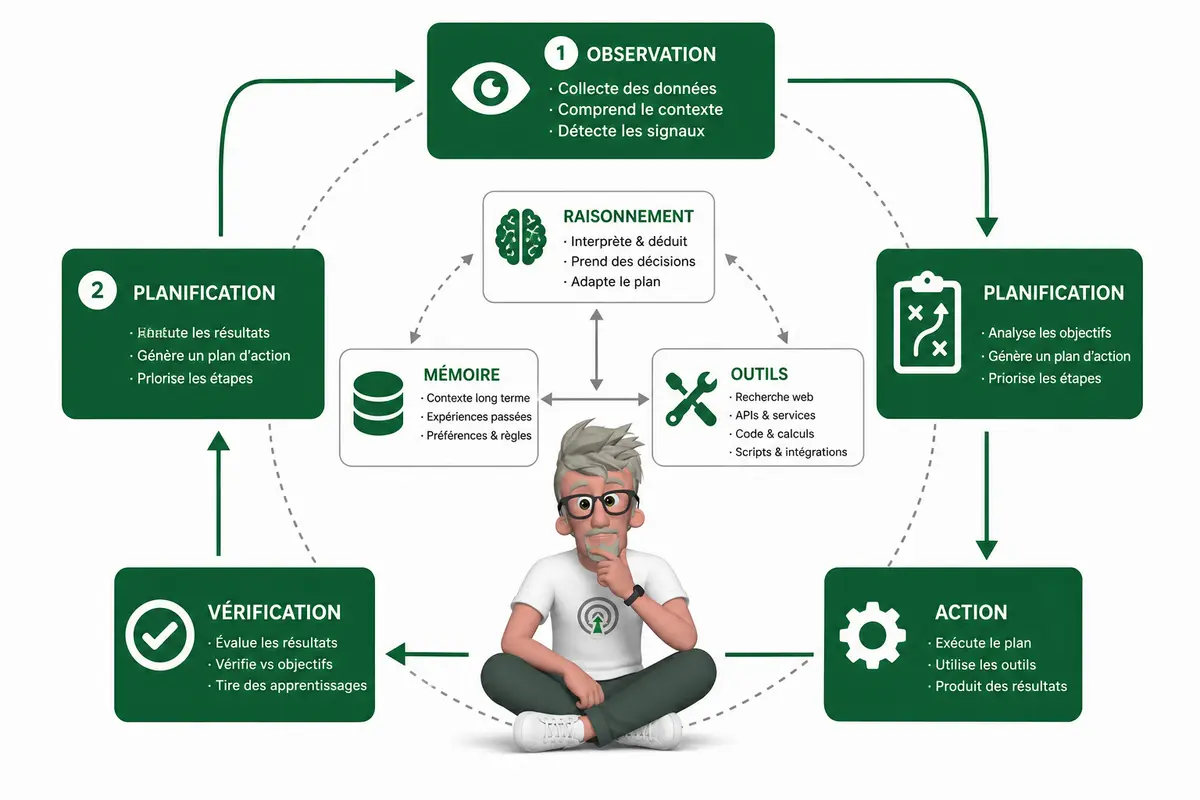
La boucle de fonctionnement suit trois phases : observation, planification et action. L’agent observe les données disponibles, comme une question, un fichier ou le résultat d’un outil. Il planifie ensuite les étapes nécessaires pour atteindre son objectif, puis exécute une action : appeler une API, interroger une base de données ou lancer un traitement.
Après chaque action, il observe le résultat et le compare à l’objectif. Si la réponse est incomplète ou si une étape échoue, il peut modifier son plan et recommencer. Cette boucle se poursuit avec peu d’intervention humaine, tant que les outils, les permissions et les critères d’arrêt ont été définis. En pratique, la vérification doit être explicite : un agent ne sait pas toujours distinguer une réponse plausible d’un résultat réellement correct.
La mémoire conserve le contexte utile entre les étapes. Elle peut rester temporaire, limitée à une tâche, ou s’appuyer sur un stockage externe pour retrouver des informations ultérieurement. Les outils donnent à l’agent des capacités d’action concrètes. Une API lui permet, par exemple, de créer un ticket ; une base de données lui permet de rechercher ou de mettre à jour des enregistrements.
Dans un système multi-agents, plusieurs agents se répartissent le travail : l’un collecte des données, un autre les analyse, un troisième vérifie le résultat. Cette répartition peut accélérer les tâches complexes, mais elle multiplie aussi les risques d’erreurs en chaîne. Une donnée erronée transmise par un agent peut contaminer toutes les étapes suivantes.
Les composants principaux et leur rôle :
| Composant | Rôle |
| Entrées | Fournir la demande et les données à traiter. |
| Cœur de raisonnement | Interpréter le contexte et choisir les prochaines étapes. |
| Mémoire | Conserver le contexte et les informations utiles. |
| Outils | Exécuter des actions via des API, des bases de données ou d’autres services. |
| Vérification | Comparer les résultats à l’objectif et décider de poursuivre ou de s’arrêter. |
| Système multi-agents | Répartir les tâches entre agents, avec un risque accru de propagation d’erreurs. |
Quels sont les niveaux d’autonomie des agents d’IA ?
L’autonomie d’un agent d’IA va des automatisations à règles fixes aux agents partiellement autonomes, puis aux agents pleinement autonomes. Plus sa marge d’action augmente, moins chaque étape dépend d’une validation humaine — et plus les conséquences d’une erreur peuvent être importantes.
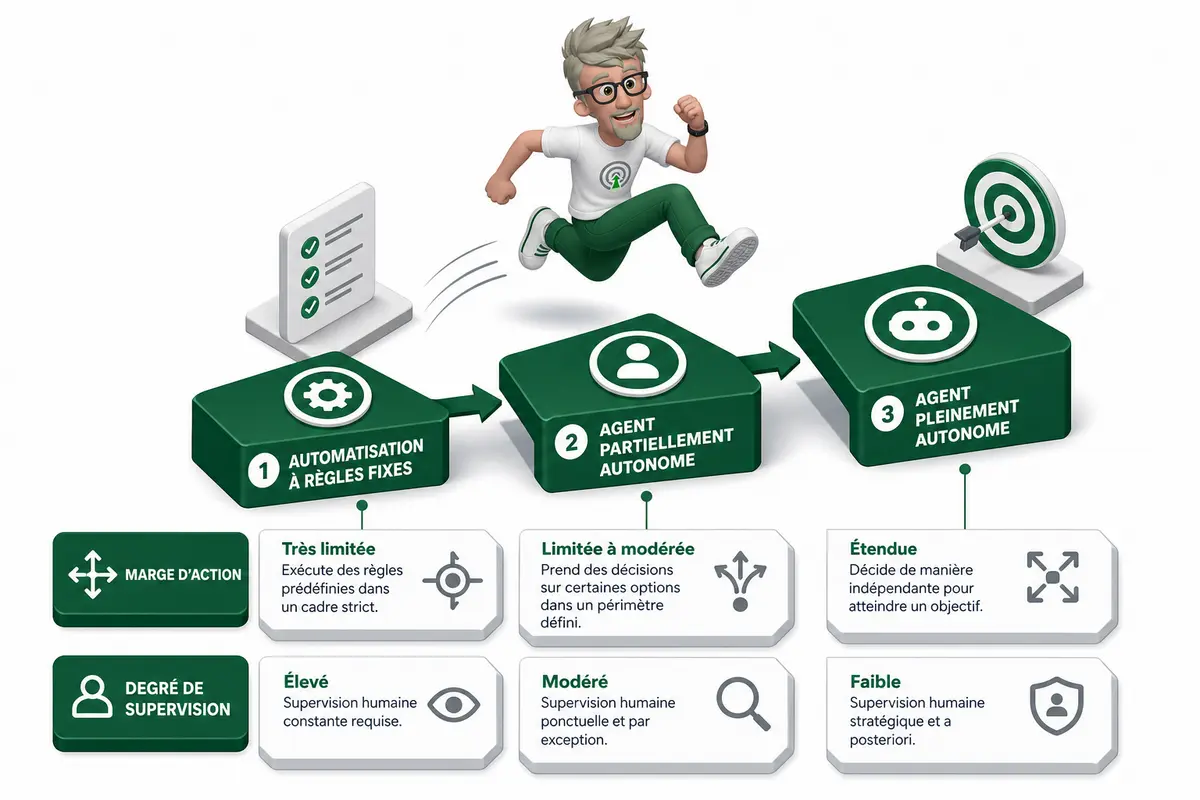
| Niveau | Marge d’action | Supervision |
| Automatisation à règles fixes | Exécute des actions prédéfinies selon des règles explicites. Elle ne choisit pas elle-même son objectif ni une stratégie alternative. | La supervision porte surtout sur la configuration des règles, les entrées et les résultats. |
| Agent partiellement autonome | Interprète une demande et choisit certaines actions dans un périmètre défini. Des décisions ou opérations sensibles restent soumises à validation humaine. | Une personne contrôle les étapes critiques, les exceptions ou les actions à fort impact. |
| Agent pleinement autonome | Enchaîne ses décisions et ses actions sans validation humaine systématique, dans les limites des accès et des règles qui lui sont accordés. | La supervision est moins présente dans chaque action, mais doit rester active au niveau du système. |
Cette distinction décrit le mode de fonctionnement, pas une catégorie de produit. Je n’attribue donc pas un niveau d’autonomie à un outil sans éléments documentés sur son déploiement et ses paramètres. Un même système peut être configuré avec des marges d’action très différentes.
Les agents pleinement autonomes demandent des garde-fous et une surveillance renforcés : périmètre d’accès limité, actions irréversibles bloquées ou soumises à approbation, journalisation et mécanisme d’arrêt. Le point décisif, c’est ce que l’agent peut réellement modifier dans son environnement, pas seulement la qualité de ses réponses.
Hermes et OpenClaw sont des exemples de systèmes ayant un accès direct à leur environnement d’exécution. Cet accès augmente les risques : une décision erronée peut se traduire par une action réelle. Il faut donc évaluer et contrôler les permissions accordées avant de les laisser agir sans validation.
Quels bénéfices attendre des agents autonomes ?
Les agents autonomes peuvent réduire certains coûts, prendre en charge des tâches répétitives ou décisionnelles, réagir rapidement et maintenir un service continu. Ces bénéfices dépendent toutefois de la qualité des données, des règles d’exécution et du niveau de supervision. Ils ne sont pas garantis : une automatisation mal cadrée peut aussi créer des erreurs ou des coûts supplémentaires.
Leur intérêt varie selon les domaines, mais repose sur les mêmes capacités : traiter des demandes, appliquer des règles, enchaîner des actions et intervenir sans attendre une instruction humaine à chaque étape.
- Service client : Un agent peut traiter des demandes récurrentes et répondre rapidement, y compris en dehors des horaires habituels. Les cas complexes doivent pouvoir être transmis à une personne.
- Opérations informatiques : Il peut surveiller des événements, appliquer des procédures définies et accélérer le traitement de tâches opérationnelles répétitives. Les actions sensibles nécessitent des contrôles adaptés.
- Développement logiciel : Il peut contribuer à des tâches répétitives du cycle de développement et aider à traiter certaines décisions selon des critères établis. Les résultats restent à vérifier avant leur utilisation.
- Logistique : Il peut traiter des informations opérationnelles et réagir rapidement à des situations prévues par les règles métier, ce qui peut faciliter la continuité des opérations.
- Finance : Il peut prendre en charge des traitements répétitifs et appliquer des règles de décision prédéfinies. La supervision reste importante dès qu’une décision a des conséquences financières ou réglementaires.
- Marketing : Il peut automatiser des tâches récurrentes et accélérer le traitement d’informations utiles aux activités marketing, dans le cadre des objectifs et des règles définis.
- Ventes : Il peut soutenir le traitement de tâches commerciales répétitives et réagir rapidement aux informations disponibles, tout en laissant aux équipes les décisions qui demandent du jugement.
Le bénéfice réel se mesure donc à l’adéquation entre la tâche confiée, le risque accepté et les contrôles en place. Un agent autonome est surtout utile quand il agit dans un périmètre clair et que ses résultats peuvent être vérifiés.
Comment réduire les risques des agents autonomes ?
Pour réduire les risques d’un agent autonome, j’adapte les garde-fous et la supervision à son niveau d’autonomie et à ses accès. Plus il agit indépendamment, plus une erreur peut se propager avant qu’une personne puisse intervenir.
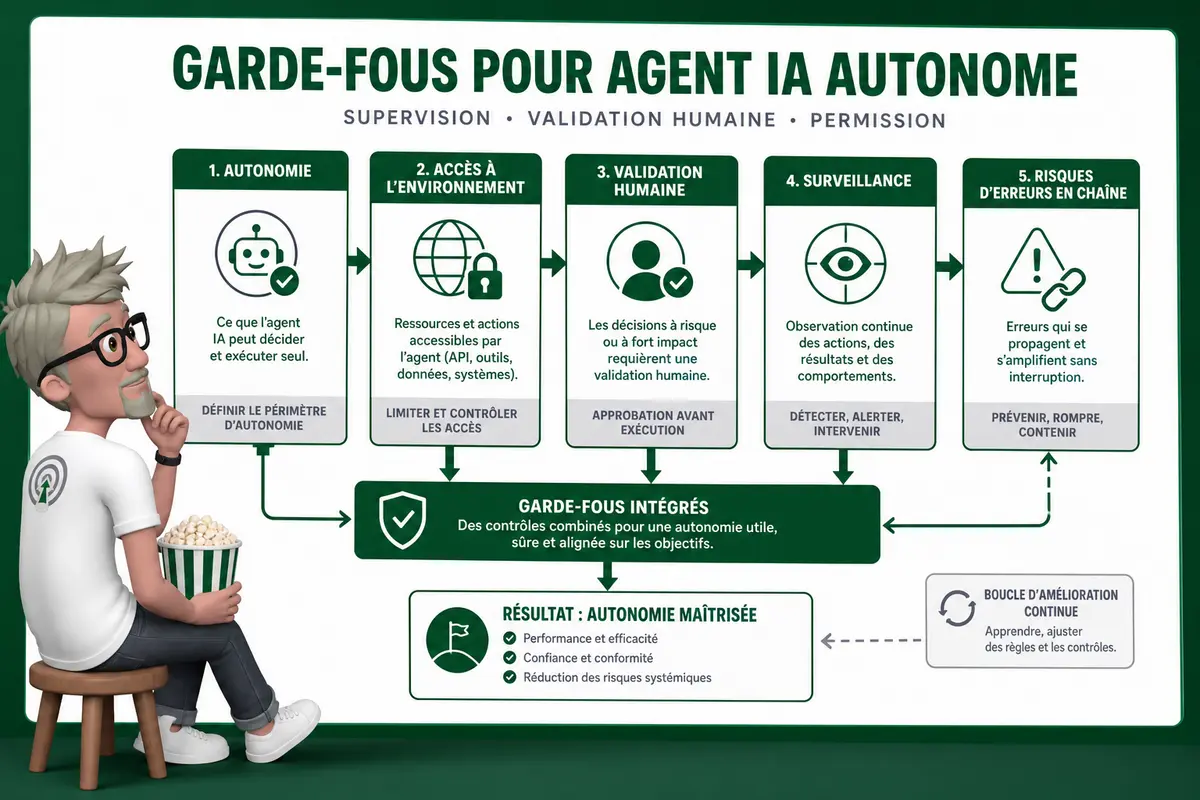
L’indépendance augmente le risque parce que l’agent peut enchaîner des décisions et des actions sans validation humaine entre chaque étape. Une erreur d’interprétation, de planification ou d’exécution peut alors produire des conséquences plus larges que dans un système qui demande confirmation. L’accès direct à l’environnement d’exécution accroît aussi le niveau de risque : l’agent peut agir dans son contexte opérationnel, et pas seulement proposer une réponse. Cet accès doit donc être pris en compte dans l’évaluation de son autonomie.
Pour un agent partiellement autonome, je relie les actions importantes à une validation humaine. L’agent peut préparer ou recommander une action, mais une personne vérifie le résultat avant sa mise en œuvre. Cette approche est particulièrement utile lorsque l’action peut affecter des données, un service ou un processus métier.
Un agent pleinement autonome nécessite une surveillance renforcée, car il peut agir sans approbation à chaque étape. La supervision doit tenir compte de ses capacités réelles et de son accès à l’environnement. Dans un système multi-agents, le risque ne se limite pas à une erreur isolée : un agent peut transmettre une information erronée à un autre, qui l’utilise à son tour. Ces erreurs en chaîne peuvent amplifier l’impact initial.
Synthèse
| Niveau d’autonomie | Supervision adaptée | Risque à surveiller |
| Partielle | Validation humaine des actions importantes | Action incorrecte exécutée sans vérification |
| Complète | Surveillance renforcée | Propagation d’une erreur avant détection |
| Multi-agents | Supervision tenant compte des interactions | Erreurs en chaîne entre agents |
Comment déployer ces agents avec discernement ?
Les agents d’IA autonomes associent raisonnement, mémoire et outils pour observer, planifier et agir vers un objectif. Cette architecture peut accélérer les tâches, améliorer la continuité du service et soutenir plusieurs fonctions métier. Mais plus l’agent dispose d’autonomie et d’accès à son environnement, plus les risques d’erreurs et d’actions non maîtrisées augmentent. Le niveau de supervision doit donc suivre le niveau d’autonomie : validation humaine pour les agents partiellement autonomes, garde-fous et surveillance renforcés pour les systèmes pleinement autonomes. En évaluant les capacités et les risques ensemble, vous pouvez mieux cibler les usages et tirer parti de l’IA sans perdre de vue le contrôle opérationnel.
FAQ
- Qu’est-ce qu’un agent d’IA autonome ?
C’est un système qui poursuit un objectif, perçoit son environnement et agit avec peu d’intervention humaine. Il peut adapter ses actions au fil de la tâche. - Quelle différence avec une automatisation classique ?
Une automatisation classique suit des règles fixes. Un agent autonome peut raisonner sur un objectif, planifier des étapes et s’adapter à son environnement. - Quels sont les composants d’un agent autonome ?
Il s’appuie sur des entrées, un cœur de raisonnement généralement fondé sur un modèle de langage, une mémoire et des outils comme des API ou des bases de données. - Quels sont les principaux risques des agents autonomes ?
Leur indépendance peut entraîner des actions non maîtrisées. Les erreurs peuvent aussi se propager dans un système multi-agents, et l’accès direct à un environnement d’exécution augmente les risques. - Comment superviser un agent d’IA autonome ?
La supervision doit être adaptée à son niveau d’autonomie. Les agents partiellement autonomes peuvent nécessiter une validation humaine ; les agents pleinement autonomes demandent des garde-fous et une surveillance renforcés.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Analytics, Data Engineering et automatisation IA. J’accompagne les équipes dans la conception et l’intégration de systèmes data et IA, avec une attention particulière portée à leur architecture, à leur usage opérationnel et à leur maîtrise.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.