
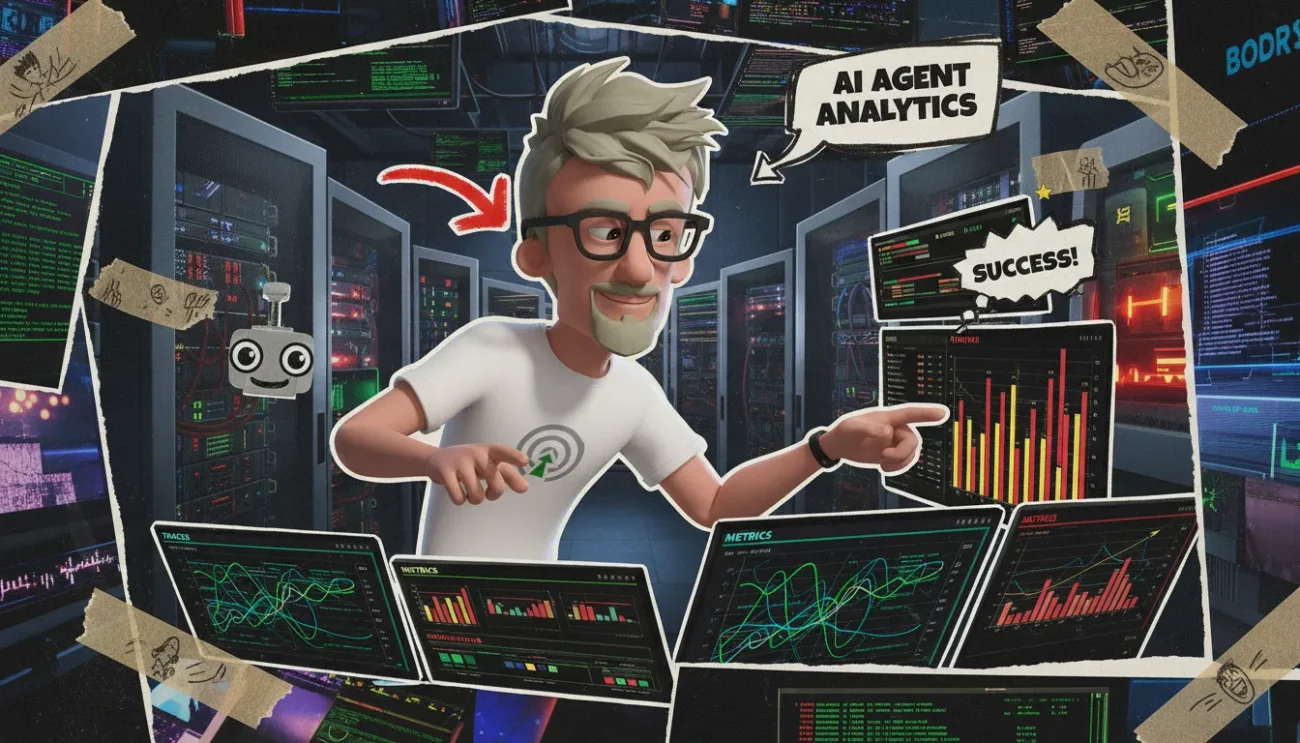




On fiabilise des agents IA en cadrant leur comportement, puis en traçant, testant, mesurant et surveillant chaque exécution. Le vrai sujet, c’est pas juste le prompt. C’est tout le cycle de vie autour de l’agent, surtout quand il tourne déjà en production.
Besoin d'aide ? Découvrez les solutions de notre agence d'agents IA.
Par où commencer ?
Je commence toujours par installer des contrôles avant de chercher à optimiser quoi que ce soit. C’est moins sexy qu’un nouveau modèle ou qu’un prompt plus malin, mais c’est ce qui évite de piloter à l’aveugle. Si le sujet vous interesse, je propose une formation n8n pour apprendre à assembler un système agentique avec règles, limites, validations et traces .
Un agent IA fiable, ce n’est pas un agent qui “répond bien” trois fois en démo. C’est un agent qu’on sait cadrer, observer, corriger et améliorer dans le temps. La fiabilité, c’est une boucle de travail, pas une case à cocher.
L’ordre compte vraiment. Si je surveille un agent mal cadré, je vais juste regarder des problèmes arriver en temps réel. Si je mesure sans savoir quoi mesurer, je vais produire du bruit avec de beaux graphiques inutiles. Si je teste sans traces, je vais perdre du temps à deviner pourquoi l’agent a pris une mauvaise décision.
Chez les clients, je vois souvent la même chose. L’agent marche bien en démo, puis il devient fragile dès qu’on ajoute des cas réels, des utilisateurs pressés, des données sales ou des outils externes. Ce n’est pas une surprise. C’est juste le passage normal entre prototype et production.
| Étape | Objectif | Signal à surveiller |
| Rendre l’agent plus fiable | Clarifier son rôle, ses limites, ses outils et les cas où il doit refuser ou demander de l’aide. | Réponses hors périmètre, appels d’outils inutiles, décisions trop confiantes. |
| Déboguer les échecs | Comprendre pourquoi l’agent s’est trompé, avec des traces lisibles de ses entrées, sorties et actions. | Erreurs répétées, étapes manquantes, mauvais choix d’outil, contexte mal utilisé. |
| Évaluer les performances | Tester l’agent sur des cas représentatifs, pas seulement sur les exemples qui arrangent tout le monde. | Taux de réussite, qualité des réponses, robustesse sur les cas limites. |
| Suivre les métriques utiles | Mesurer ce qui aide vraiment à décider, sans transformer le projet en usine à dashboards. | Coût, latence, taux d’échec, satisfaction utilisateur, escalades humaines. |
| Surveiller en production | Détecter les dérives, les pannes d’outils, les changements de comportement et les nouveaux cas non prévus. | Alertes, anomalies, hausse des erreurs, baisse de qualité perçue. |
Je préfère avancer comme ça. D’abord je cadre, puis je rends visible, puis je mesure, puis j’améliore. Sinon on confond activité et fiabilité, et en production ça se paie vite.
Comment cadrer le comportement ?
Je cadre le comportement d’un agent IA à trois niveaux : le modèle, les outils et les prompts. Si un agent part dans tous les sens, ce n’est presque jamais “l’IA qui est nulle”. C’est souvent le cadre qui est trop flou.
Côté modèle, les paramètres du LLM, le grand modèle de langage, influencent directement la cohérence des réponses. La température, par exemple, joue sur la créativité. Plus elle est haute, plus l’agent varie ses réponses. Plus elle est basse, plus il reste stable. Le but n’est pas de trouver une réponse magique. Le but, c’est de réduire la variabilité quand le cas business demande de la stabilité. Pour un résumé libre, on peut accepter un peu de variation. Pour qualifier une demande client ou décider d’une escalade support, je préfère quelque chose de beaucoup plus cadré.
Côté outils, je les vois comme des capacités limitées et contrôlées. Pas comme un buffet ouvert. Un agent ne devrait pas avoir accès à tout votre CRM, vos emails, votre base de données et vos webhooks “au cas où”. Il doit utiliser uniquement les outils utiles à l’étape en cours du workflow. J’ai déjà vu un agent avec trop d’outils appeler le mauvais service, juste parce que le nom semblait proche. Ce n’est pas un bug spectaculaire, c’est pire : c’est silencieux.
Côté prompts, je structure toujours avec un contexte clair, un objectif explicite, des contraintes, des exemples si besoin, et des règles de refus ou d’escalade. Si l’agent ne sait pas, il doit le dire. Si la demande est risquée, il doit passer la main. Si la réponse doit alimenter une autre automatisation, je force un schéma de sortie prédictible, par exemple avec des champs fixes comme “categorie”, “niveau_confiance”, “action_recommandee” et “raison”.
Dans n8n, ça se traduit très concrètement. Je configure le nœud AI Agent avec un modèle adapté, une température basse pour les décisions stables, et seulement les tools nécessaires à cette étape. Je mets des garde-fous avant l’agent avec des nœuds IF ou Switch pour filtrer les demandes hors périmètre. Je remets des garde-fous après l’agent pour vérifier le niveau de confiance, le format de sortie ou la présence d’un risque. Les décisions critiques ne doivent pas dépendre d’un simple texte généré. Elles doivent passer par des conditions explicites, vérifiables, traçables.
Mini check-list
- Le modèle est réglé pour la stabilité attendue.
- Les outils accessibles sont limités à l’étape du workflow.
- Le prompt contient contexte, objectif, contraintes et règles d’escalade.
- La sortie suit un schéma prévisible si elle est réutilisée ensuite.
- Les nœuds IF ou Switch valident les cas sensibles avant et après l’agent.
- Les décisions critiques sont séparées du texte généré.
Comment trouver les erreurs ?
Je ne cherche jamais une erreur dans un agent IA au hasard. Je remonte l’exécution exacte, puis je regarde ce que l’agent a reçu, ce qu’il a décidé, et ce qu’il a renvoyé à chaque étape. C’est souvent là que la vérité sort. Pas dans “l’IA bug”, mais dans “l’agent a reçu une donnée ambiguë”, “il a choisi le mauvais outil”, ou “il a répondu dans un format que le système suivant ne sait pas lire”.
La première technique, c’est de retrouver la bonne exécution parmi des centaines. Et là, le filtrage et le tagging changent tout. Un tag propre sur le type de demande, le client, le canal, le statut, ou le cas business permet de retrouver vite les vrais problèmes. C’est sous-estimé parce que ça paraît administratif. En pratique, c’est ce qui évite de perdre 45 minutes à fouiller des logs au hasard.
Dans n8n, j’utilise souvent le node Execution Data pour enrichir les exécutions avec des infos utiles. Par exemple : client_id, type_demande, source, statut_agent, outil_appelé. Ensuite, quand une erreur remonte, je filtre. Je peux retrouver toutes les demandes “support”, venues de “WhatsApp”, pour un client précis, avec un statut “tool_error”. Ça devient beaucoup plus simple.
La deuxième technique, c’est de tracer les entrées, les sorties et les décisions. Je veux voir le prompt reçu, les données disponibles, l’outil choisi, les paramètres envoyés, puis la réponse finale. Dans n8n, l’inspection des logs et des exécutions permet déjà de comprendre le chemin complet du workflow. On voit vite si le problème vient du modèle, d’un mauvais mapping, d’un outil externe, ou d’une donnée absente.
La troisième technique, c’est d’aller plus loin avec des plateformes externes quand le sujet devient fin : latence, coût, consommation en tokens, qualité des réponses, comparaison entre prompts. Les tokens, ce sont les morceaux de texte que le modèle lit et génère. Plus il y en a, plus ça coûte cher et plus ça peut ralentir.
Un agent qui choisit le mauvais outil ne se corrige pas comme un agent qui produit un JSON invalide. Et un agent trop lent, ce n’est pas forcément un problème de modèle. J’ai vu un client accuser GPT alors que 80% du temps partait dans un appel API mal optimisé.
| Symptôme | Où regarder | Correction probable |
| Agent choisit le mauvais outil | Prompt système, description des tools, décision intermédiaire | Clarifier les règles de choix et réduire les outils disponibles |
| Format invalide en sortie | Sortie brute du modèle, parser, schéma attendu | Imposer un schéma strict et ajouter une validation avant l’étape suivante |
| Réponse trop lente | Temps par node, appels API, nombre de tokens | Réduire le contexte, optimiser l’API, mettre du cache si possible |
Comment tester les performances ?
Je teste les performances d’un agent IA avec un jeu de cas représentatifs, puis je relance ces tests à chaque changement de prompt, d’outil ou de modèle. C’est simple à dire, mais c’est souvent là que les problèmes commencent. Beaucoup d’équipes testent vite fait avec trois questions dans le chat, trouvent que “ça a l’air bon”, puis découvrent les vrais bugs en production.
Le premier dataset de test doit rester petit, mais utile. Je préfère dix bons cas bien choisis à cent cas décoratifs qui ne protègent rien. Ces cas doivent couvrir les chemins critiques de l’agent : les demandes simples, les cas limites, les erreurs fréquentes, les demandes ambiguës, les formats attendus, les refus et les escalades vers un humain.
Un bon cas de test ressemble à une situation réelle. Pas à une phrase parfaite écrite par quelqu’un qui connaît déjà le système. Si l’agent doit répondre en JSON, je teste le JSON. Si l’agent doit refuser une demande risquée, je teste le refus. Si l’agent doit appeler un outil, je vérifie qu’il appelle le bon outil avec les bons paramètres.
| Niveau | Usage |
| Contrôles ad hoc | Je teste manuellement quelques cas après un changement rapide. |
| Dataset versionné | Je garde une liste stable de cas critiques et je compare les résultats dans le temps. |
| Évaluation automatisée | Je lance les tests à chaque modification de prompt, modèle ou outil. |
| Pipeline CI | Je bloque une mise en production si les scores ou règles minimales ne passent pas. |
Le dataset ne reste pas figé. Je l’enrichis avec les échecs réels observés en production. Chaque bug important devient un test de non-régression, c’est-à-dire un test qui vérifie que le même problème ne revient pas plus tard. J’ai vu ça chez un client avec un agent support : un seul cas mal géré sur les remboursements revenait régulièrement. On l’a ajouté au dataset, et ça a évité plusieurs régressions après changement de modèle.
Les évaluations offline servent à détecter les dérives après modification. On rejoue les mêmes cas, dans un environnement contrôlé. Les évaluations online servent à repérer les nouveaux problèmes face à de vrais utilisateurs, avec leurs formulations bizarres, leurs contextes incomplets et leurs demandes imprévues.
Tout le monde n’a pas besoin d’une usine à gaz dès le début. Mais tout agent sérieux doit avoir une méthode de test reproductible. Avant de valider une mise en production, je me pose toujours ces questions :
- Est-ce que les cas critiques métier sont couverts ?
- Est-ce que les cas limites et ambiguës sont testés ?
- Est-ce que les formats de sortie attendus sont vérifiés ?
- Est-ce que les refus et escalades sont testés ?
- Est-ce que les anciens bugs importants sont devenus des tests de non-régression ?
- Est-ce que les tests sont relancés après chaque changement de prompt, d’outil ou de modèle ?
- Est-ce que j’ai un suivi online pour détecter les problèmes que le dataset ne couvre pas encore ?
Quelles métriques surveiller ?
Je surveille seulement les métriques qui déclenchent une décision. Si une courbe ne change aucune action, elle encombre le dashboard. C’est tentant de tout afficher, surtout avec des agents IA, mais en production je préfère peu de signaux, bien choisis, que cinquante graphes que personne ne regarde.
Je classe les métriques utiles en quatre familles.
- Exécution. Je regarde si l’agent va au bout de sa tâche. Taux de réussite, erreurs techniques, abandons utilisateur, chemins bloqués, appels d’outils échoués. Ça dit si le système fonctionne vraiment, pas juste s’il répond.
- Qualité. Je mesure si la réponse est correcte et exploitable. Scores d’évaluation, formats JSON valides, réponses acceptées, réponses corrigées par un humain. Un score d’évaluation, c’est une note donnée par un test automatique ou humain sur un critère précis.
- Efficacité. Je suis la latence, la consommation de tokens et le coût. Un token, c’est un petit morceau de texte traité par le modèle. Plus l’agent consomme de tokens, plus il coûte cher et plus il peut devenir lent.
- Sécurité. Je surveille les comportements indésirables, les réponses hors cadre, les tentatives d’actions non autorisées ou les usages anormaux. C’est là qu’on voit si l’agent commence à sortir de son rôle.
Chaque métrique doit avoir une définition claire, un seuil d’alerte, un propriétaire et une action associée. Sinon, le dashboard devient décoratif. Par exemple, si le taux d’erreur dépasse 5 %, qui reçoit l’alerte ? Qui regarde les logs ? Qui rollback le prompt ou désactive un outil ? Sans ça, on a juste une jolie courbe rouge.
En production, je veux des tableaux de bord opérationnels. Pas des écrans pour impressionner en réunion. Je compare les périodes, je regarde les dérives dans le temps, je repère les changements soudains après une modification de modèle, de prompt ou d’outil. Chez un client, une simple mise à jour de prompt avait doublé la latence. La qualité semblait meilleure, mais le coût explosait. Sans métrique d’efficacité, personne ne l’aurait vu avant la facture.
Le plus dur, honnêtement, ce n’est pas d’afficher des courbes. C’est de choisir peu de métriques, de les garder propres, et de les maintenir quand le produit évolue.
| Famille | Exemple de métrique | Ce que ça révèle | Action possible |
| Exécution | Taux de réussite des tâches | Si l’agent termine vraiment ce qu’on lui demande | Corriger un outil, un workflow ou un chemin bloqué |
| Qualité | Réponses acceptées sans correction | Si la sortie est fiable et utilisable | Revoir le prompt, les exemples ou l’évaluation |
| Efficacité | Coût moyen par exécution | Si l’agent reste rentable à l’usage | Réduire les appels modèle ou optimiser le contexte |
| Sécurité | Actions non autorisées détectées | Si l’agent dépasse son cadre | Bloquer l’action, renforcer les permissions ou alerter |
Alors, votre agent IA est-il vraiment pilotable ?
La fiabilité d’un agent IA ne vient pas d’un meilleur prompt posé à la va-vite. Je la construis avec des contrôles clairs, des outils bien délimités, des traces exploitables, des tests réguliers, des métriques utiles et une vraie surveillance en production. C’est moins spectaculaire qu’une démo, mais c’est ce qui fait la différence quand l’agent commence à traiter de vrais cas business. Mon conseil simple : commencez petit, instrumentez proprement, puis améliorez à partir des échecs réels. Le bénéfice pour vous, c’est un agent plus stable, plus compréhensible et beaucoup plus facile à faire évoluer.
FAQ
- Qu’est-ce qui rend un agent IA fiable en production ?
Un agent IA fiable en production a un comportement cadré, des outils limités à ce dont il a besoin, des sorties prévisibles, des garde-fous, des traces exploitables, des tests réguliers et des métriques suivies dans le temps. Ce n’est pas juste une affaire de modèle ou de prompt. - Pourquoi un agent IA fonctionne en test mais échoue en production ?
Parce qu’en production il rencontre des cas plus variés, des données imparfaites, des demandes ambiguës, des contraintes de latence, des coûts réels et parfois des outils externes instables. La démo valide une possibilité. La production demande un système observable et maintenable. - Comment déboguer un agent IA dans n8n ?
Je commence par retrouver l’exécution concernée, idéalement avec du tagging via l’Execution Data node. Ensuite j’inspecte les logs, les entrées, les sorties, les décisions de l’agent et les outils appelés. Le but est de comprendre où la chaîne a dévié : prompt, outil, routage, format ou modèle. - Quelles métriques suivre pour un agent IA ?
Les métriques les plus utiles sont généralement le taux de réussite, les erreurs, les scores de qualité, les formats valides, la latence, la consommation de tokens, les coûts et les comportements indésirables. Je garde seulement les métriques liées à une décision ou une action claire. - Faut-il tester un agent IA à chaque modification ?
Oui, surtout après un changement de prompt, d’outil ou de modèle. Un petit jeu de tests bien choisi permet de détecter les régressions rapidement. Les échecs réels observés en production doivent ensuite enrichir ce jeu de tests pour éviter que le même problème revienne.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent industrialiser leurs workflows data et IA sans perdre le contrôle sur la qualité, les coûts et la mesure. Avec webAnalyste et Formations Analytics, j’ai travaillé pour des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez rendre vos agents IA plus fiables en production, vous pouvez me contacter.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.