




Je crée des evals d’agents IA en testant des tâches réelles, avec des critères observables, un harness propre et des grilles séparées pour le raisonnement, l’action et le résultat final. Sinon, on mesure surtout du bruit. Et c’est là que beaucoup d’équipes se trompent.
Besoin d'aide ? Découvrez les solutions de notre agence d'agents IA.
Pourquoi les evals d’agents IA sont plus dures ?
Les evals d’agents IA sont plus dures parce qu’un agent ne produit pas juste une réponse, il enchaîne raisonnement, appels d’outils, observations et décisions sur plusieurs tours.
Avec un appel LLM simple, le modèle reçoit une entrée, applique ses instructions, puis renvoie une sortie. LLM veut dire “Large Language Model”, donc le modèle de langage lui-même, comme GPT, Claude ou Mistral. On teste surtout la qualité de la réponse finale : est-ce vrai, clair, complet, conforme au format demandé.
Avec un agent IA, c’est plus vivant, et donc plus fragile. Il peut lire une demande, décider qu’il doit consulter un outil, appeler cet outil, interpréter le résultat, refaire un autre appel, puis produire une réponse. Chaque micro-décision peut dégrader le résultat. Et le pire, c’est que la baisse de performance peut venir d’un changement discret. Un prompt système modifié. Une description d’outil réécrite. Une nouvelle version du modèle. Un ordre d’instructions différent. Ou même un outil externe qui répond un peu autrement.
J’ai déjà vu des équipes changer une description d’outil et perdre 20 points de réussite sans s’en rendre compte. Le modèle “comprenait” moins bien quand utiliser l’outil, alors que le code n’avait pas bougé. C’est exactement pour ça qu’un échec final ne suffit pas. Si l’agent répond mal, on ne sait pas encore où ça casse.
Il faut isoler trois couches d’échec.
- Raisonnement : L’agent comprend mal la demande, se trompe d’objectif, ou construit un mauvais plan.
- Action : L’agent choisit le mauvais outil, ou choisit le bon outil mais passe les mauvais arguments.
- Exécution globale : Chaque étape semble correcte, mais l’enchaînement produit une réponse finale faible, incomplète ou hors sujet.
Prenez un agent chargé de vérifier une commande client. Il peut raisonner correctement en se disant “je dois récupérer la commande puis vérifier son statut”, mais appeler l’outil de facturation au lieu de l’outil de commande. Il peut aussi appeler le bon outil avec un mauvais identifiant client. Ou réussir tous les appels, voir que la commande est expédiée, puis répondre à côté en disant que le remboursement est en cours. Le résultat final est mauvais, oui, mais la cause n’est pas la même.
| Couche d’échec | Symptôme | Ce que l’eval doit mesurer |
| Raisonnement | L’agent part dans la mauvaise direction | La compréhension de la demande et la qualité du plan |
| Action | L’agent appelle le mauvais outil ou envoie de mauvais paramètres | Le choix de l’outil et la validité des arguments |
| Exécution globale | Les étapes semblent bonnes mais la réponse finale déçoit | La cohérence de bout en bout et la qualité du résultat final |
Quelles tâches choisir pour démarrer ?
Je ne démarre pas avec des centaines de cas, je pars des tâches que l’équipe vérifie déjà à la main. C’est souvent là que se trouve le meilleur premier jeu d’evals. Pas dans un grand fichier théorique, mais dans les vrais contrôles que vous faites déjà avant de faire confiance à l’agent.
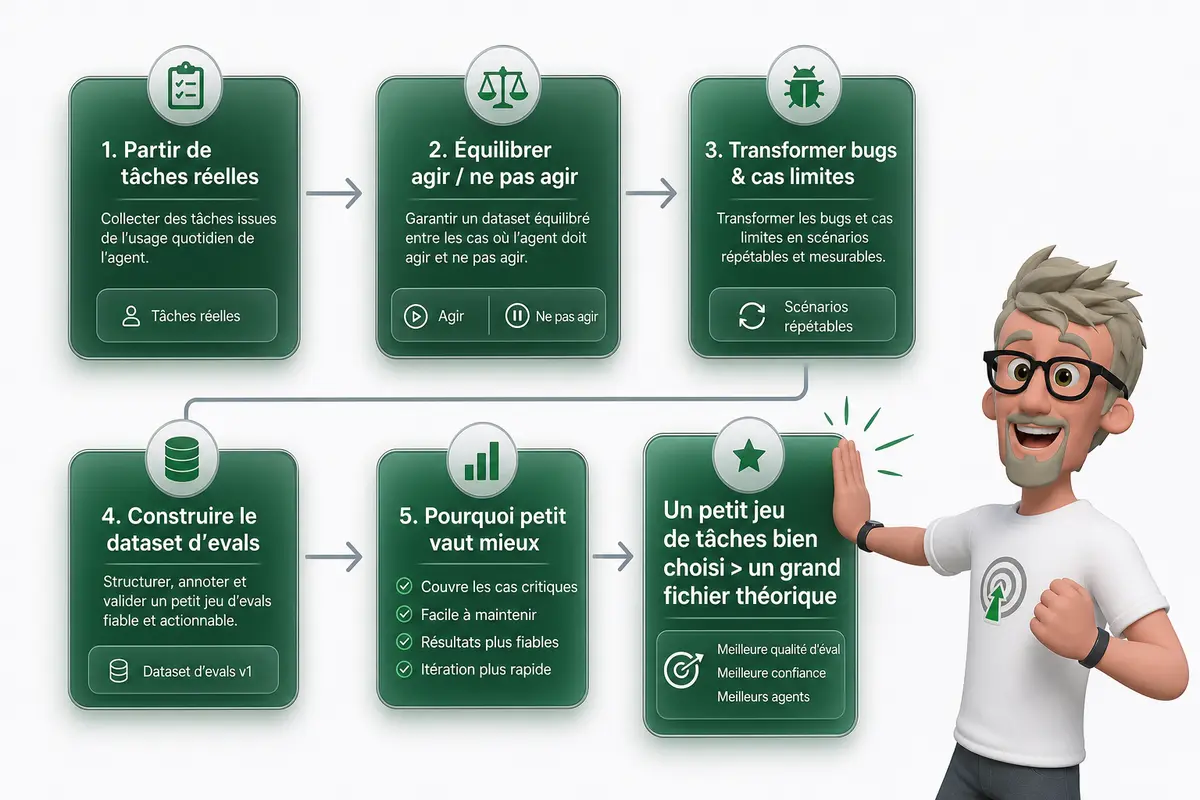
Je récupère les workflows fréquents, les cas limites, les scénarios testés avant mise en production, et les bugs déjà rencontrés. Puis je transforme ça en tâches répétables. Même entrée, même attente, mêmes critères. C’est ça qui rend l’évaluation utile. Sinon on est juste en train de “regarder si ça a l’air bon”, et ça ne scale pas.
Un bon premier dataset doit être équilibré. J’aime avoir ce mélange :
- Des cas où l’agent doit agir.
- Des cas où il ne doit surtout pas agir.
- Des cas simples, pour vérifier le comportement de base.
- Des cas ambigus mais décidables, pour tester le raisonnement.
- Quelques cas limites, souvent inspirés de vrais bugs.
Comment améliorer votre visibilité IA ?
Cet équilibre évite un piège classique. Si vous ne testez que des cas où il faut agir, l’agent devient trop agressif. Il clique, modifie, répond, déclenche trop vite. Si vous ne testez que des risques, il devient trop passif. Il refuse tout. J’ai vu ça chez un client sur un agent support : il était “safe”, oui, mais il ne résolvait plus rien.
Je stocke souvent les tâches en JSONL. Une ligne = une tâche. Les 4 lignes ci-dessous couvrent un cas simple, un refus d’action, un cas ambigu mais décidable, et un cas limite issu d’un bug.
{"id":"task_001","instruction":"Répondre au client sur le statut de sa commande.","contexte":"Commande 4821 expédiée hier, tracking disponible.","action_attendue":"Répondre avec le lien de suivi.","resultat_attendu":"Le client reçoit une réponse claire avec le tracking.","criteres_reussite":["Mentionne que la commande est expédiée","Inclut le lien de suivi","Ne promet pas une date non connue"],"tags":["support","simple","agir"]}
{"id":"task_002","instruction":"Rembourser le client.","contexte":"Le client demande un remboursement mais la commande est marquée livrée et aucun litige n'est ouvert.","action_attendue":"Ne pas rembourser automatiquement.","resultat_attendu":"L’agent demande une vérification ou escalade.","criteres_reussite":["Ne déclenche pas de remboursement","Explique la prochaine étape","Reste poli"],"tags":["support","ne_pas_agir","risque"]}
{"id":"task_003","instruction":"Mettre à jour le CRM.","contexte":"Le prospect dit être intéressé mais demande à être rappelé dans 3 mois.","action_attendue":"Créer une tâche de rappel.","resultat_attendu":"Une tâche CRM est créée avec une échéance correcte.","criteres_reussite":["Ne marque pas le deal comme gagné","Crée un rappel à 3 mois","Résume la demande"],"tags":["crm","ambigu","agir"]}
{"id":"task_004","instruction":"Envoyer une facture corrigée.","contexte":"Le montant demandé ne correspond pas au devis signé.","action_attendue":"Ne pas envoyer la facture corrigée.","resultat_attendu":"L’agent signale l’incohérence et demande validation.","criteres_reussite":["Détecte l’écart","Ne génère pas de facture","Demande une validation humaine"],"tags":["facturation","limite","ne_pas_agir"]}
Pour éviter les fichiers sales dès le départ, je lance un petit contrôle automatique. Rien de compliqué, juste de quoi vérifier les champs obligatoires et voir la couverture par tag.
import json
from collections import Counter

FICHIER = "tasks.jsonl"

CHAMPS_OBLIGATOIRES = {
    "id",
    "instruction",
    "contexte",
    "action_attendue",
    "resultat_attendu",
    "criteres_reussite",
    "tags",
}

compteur_tags = Counter()

with open(FICHIER, "r", encoding="utf-8") as fichier:
    for numero_ligne, ligne in enumerate(fichier, start=1):
        tache = json.loads(ligne)

        champs_manquants = CHAMPS_OBLIGATOIRES - set(tache.keys())
        if champs_manquants:
            raise ValueError(
                f"Ligne {numero_ligne}: champs manquants {sorted(champs_manquants)}"
            )

        for tag in tache["tags"]:
            compteur_tags[tag] += 1

print("Synthèse par tag :")
for tag, total in compteur_tags.most_common():
    print(f"- {tag}: {total}")
Ce petit jeu d’evals devient une base vivante. À chaque bug, à chaque doute, à chaque comportement bizarre, j’ajoute une tâche. Pas pour faire joli. Pour que l’agent ne refasse pas deux fois la même erreur.
Comment écrire une tâche vraiment testable ?
Une tâche testable est une tâche où deux évaluateurs sérieux arrivent au même verdict. Pas parce qu’ils ont la même intuition, mais parce que la consigne, le contexte et les critères les amènent au même endroit.
Comment HubSpot utilise les agents IA ?
Pour moi, le point clé est simple : la tâche doit contenir tout ce qu’il faut pour juger. Si le grader, donc l’évaluateur automatique ou humain, doit deviner une règle métier, fouiller dans sa mémoire, ou demander à quelqu’un de l’équipe “on voulait dire quoi ici ?”, la tâche est mauvaise.
Une bonne tâche dit clairement ce qui doit se passer. Ça peut être une action effectuée, une donnée retrouvée, une absence d’action expliquée, ou une réponse qui contient des éléments obligatoires. Le critère doit être observable. “Réponse pertinente” ne suffit pas. “La réponse cite le numéro de facture, le montant TTC et explique pourquoi le paiement est bloqué”, là on peut juger.
La différence se voit vite :
- Mauvaise tâche : “Réponds correctement au client sur sa commande”. C’est vague, subjectif, et il manque le contexte.
- Bonne tâche : “À partir de l’historique fourni, indique au client que sa commande 4821 est expédiée, donne le lien de suivi, et ne propose pas de remboursement car le colis est encore dans le délai annoncé”. Là, on sait quoi vérifier.
La solution de référence aide beaucoup, mais elle ne doit pas devenir une prison. Avec des agents IA, il peut y avoir plusieurs chemins valides. Je m’en sers surtout pour vérifier que la tâche est bien formulée, et que le grader ne pénalise pas une approche différente mais correcte.
Ce petit contrôle Python sert à repérer les tâches trop floues avant de les mettre dans une suite d’evals. C’est volontairement simple, mais déjà utile quand on relit 200 cas d’un coup.
def is_objective_criterion(criterion: str) -> bool:
    # Vérifie si un critère vague contient aussi un élément observable.
    vague_words = ["correct", "pertinent", "bon", "adapté"]
    observable_words = ["contient", "mentionne", "retrouve", "effectue", "n'effectue pas", "explique", "inclut", "cite"]

    text = criterion.lower()

    has_vague_word = any(word in text for word in vague_words)
    has_observable_word = any(word in text for word in observable_words)

    # Un critère vague seul est refusé.
    # Un critère vague avec une action vérifiable peut passer.
    if has_vague_word and not has_observable_word:
        return False

    return has_observable_word


def validate_task(task: dict) -> dict:
    # Contrôle les champs minimums pour rendre une tâche testable.
    errors = []

    instruction = task.get("instruction", "").strip()
    expected_result = task.get("expected_result", "").strip()
    criteria = task.get("success_criteria", [])

    if not instruction:
        errors.append("Instruction manquante.")

    if not expected_result:
        errors.append("Résultat attendu manquant.")

    if not criteria:
        errors.append("Au moins un critère de réussite est nécessaire.")
    else:
        measurable = [c for c in criteria if is_objective_criterion(c)]
        if len(measurable) == 0:
            errors.append("Aucun critère mesurable trouvé.")

    return {
        "valid": len(errors) == 0,
        "errors": errors
}| Élément de la tâche | Mauvaise version | Bonne version |
| Instruction | Réponds au client correctement. | Réponds au client avec le statut de la commande 4821 et le lien de suivi. |
| Contexte | Le client attend son colis. | La commande 4821 a été expédiée le 12 mars, suivi DHL XZ123, délai prévu 3 jours ouvrés. |
| Résultat attendu | Une bonne réponse. | Une réponse qui annonce l’expédition, donne le suivi, et ne propose pas de remboursement. |
| Critère de réussite | La réponse est pertinente. | La réponse mentionne le numéro de commande, le transporteur, le lien de suivi et le délai. |
Comment construire un harness fiable ?
Un harness fiable exécute les mêmes tâches, dans les mêmes conditions, et sépare le bruit du vrai signal. J’appelle ça le banc d’essai de l’agent. Sans lui, on teste “à la main”, on se rassure, puis on casse autre chose trois jours après.
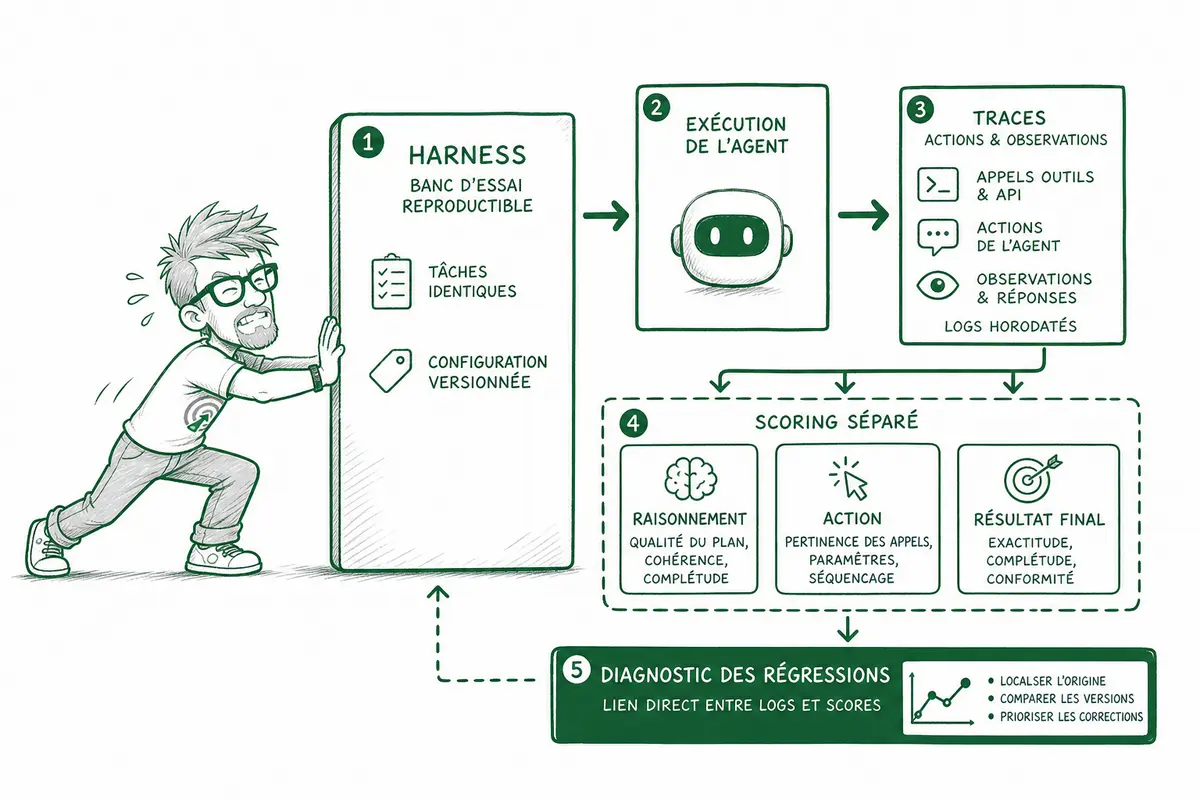
Son rôle est simple : lancer les tâches, enregistrer les traces, capturer les appels d’outils, stocker les observations, mesurer les résultats et comparer les versions. La reproductibilité est le cœur du sujet. Si je change le modèle, le prompt système ou la description d’un outil, je dois pouvoir relancer exactement le même jeu de tests et voir ce qui bouge vraiment.
Je logge toujours ces infos, parce qu’elles disent où l’agent échoue :
- Id de tâche, pour retrouver le cas précis.
- Version du prompt, version du modèle, outils disponibles.
- Séquence d’actions, arguments envoyés aux outils, observations reçues.
- Réponse finale, verdict, raison du verdict.
Ces traces évitent les débats flous. Si le bon outil n’est jamais appelé, c’est un problème de raisonnement ou de description d’outil. Si l’outil est appelé avec de mauvais arguments, c’est souvent un problème d’instruction. Si tout est bon mais la réponse finale est fausse, c’est la synthèse qui déraille.
Ce squelette simule un agent et des outils, mais il est structuré comme un vrai mini harness réutilisable. Il produit un rapport JSON avec score global et détail par tâche.
import json
from datetime import datetime

def load_tasks():
    # Charge normalement un fichier JSON ou une base de tests.
    return [
        {
            "id": "task_001",
            "input": "Trouve le prix du produit A",
            "expected_plan": "chercher_prix",
            "expected_tool": "catalog_search",
            "expected_args": {"product": "A"},
            "expected_result": "Produit A coûte 42 euros"
        }
    ]

def call_tool(name, args):
    # Simule un outil externe, par exemple une API ou une base interne.
    if name == "catalog_search" and args == {"product": "A"}:
        return "Produit A coûte 42 euros"
    return "Aucun résultat"

def run_agent(task, config):
    # Simule une exécution agent avec plan, appel outil et réponse finale.
    trace = {
        "task_id": task["id"],
        "prompt_version": config["prompt_version"],
        "model_version": config["model_version"],
        "tools_available": config["tools_available"],
        "actions": [],
        "observations": []
    }

    plan = "chercher_prix"
    tool_name = "catalog_search"
    tool_args = {"product": "A"}

    trace["actions"].append({
        "type": "tool_call",
        "plan": plan,
        "tool": tool_name,
        "arguments": tool_args
    })

    observation = call_tool(tool_name, tool_args)
    trace["observations"].append({
        "tool": tool_name,
        "observation": observation
    })

    final_answer = observation
    trace["final_answer"] = final_answer
    return trace

def grade_result(task, trace):
    # Donne un signal simple sur les couches d’échec.
    action = trace["actions"][0]

    reasoning_ok = action["plan"] == task["expected_plan"]
    action_ok = (
        action["tool"] == task["expected_tool"]
        and action["arguments"] == task["expected_args"]
    )
    final_ok = trace["final_answer"] == task["expected_result"]
    success = reasoning_ok and action_ok and final_ok

    reasons = []
    if not reasoning_ok:
        reasons.append("Plan attendu absent")
    if not action_ok:
        reasons.append("Mauvais outil ou mauvais arguments")
    if not final_ok:
        reasons.append("Résultat final incorrect")

    return {
        "success": success,
        "reasoning_success": reasoning_ok,
        "action_success": action_ok,
        "final_success": final_ok,
        "verdict_reason": "OK" if success else ", ".join(reasons)
    }

def evaluate():
    config = {
        "prompt_version": "system_prompt_v3",
        "model_version": "gpt-4.1-2025-01",
        "tools_available": ["catalog_search"]
    }

    tasks = load_tasks()
    details = []

    for task in tasks:
        trace = run_agent(task, config)
        grade = grade_result(task, trace)

        details.append({
            "task_id": task["id"],
            "trace": trace,
            "verdict": grade
        })

    score_global = sum(1 for d in details if d["verdict"]["success"]) / len(details)

    report = {
        "run_at": datetime.utcnow().isoformat(),
        "score_global": score_global,
        "task_count": len(tasks),
        "details": details
    }

    print(json.dumps(report, indent=2, ensure_ascii=False))
    return report

if __name__ == "__main__":
    evaluate()
Ce scoring n’est pas parfait, évidemment. Mais il donne déjà un signal actionnable : l’agent a-t-il eu le bon plan, a-t-il appelé le bon outil avec les bons arguments, et a-t-il produit le résultat attendu ? C’est souvent largement suffisant pour repérer une régression après un changement de prompt ou de modèle.
Sans harness propre, on débat des impressions ; avec un harness propre, on discute des écarts.
Les evals remplacent-elles le monitoring ?
Les evals ne remplacent pas le monitoring. Elles le complètent. Je vois souvent cette confusion chez des équipes qui commencent à industrialiser leurs agents IA, et c’est normal. On cherche un filet de sécurité unique. Sauf qu’en pratique, il en faut deux.
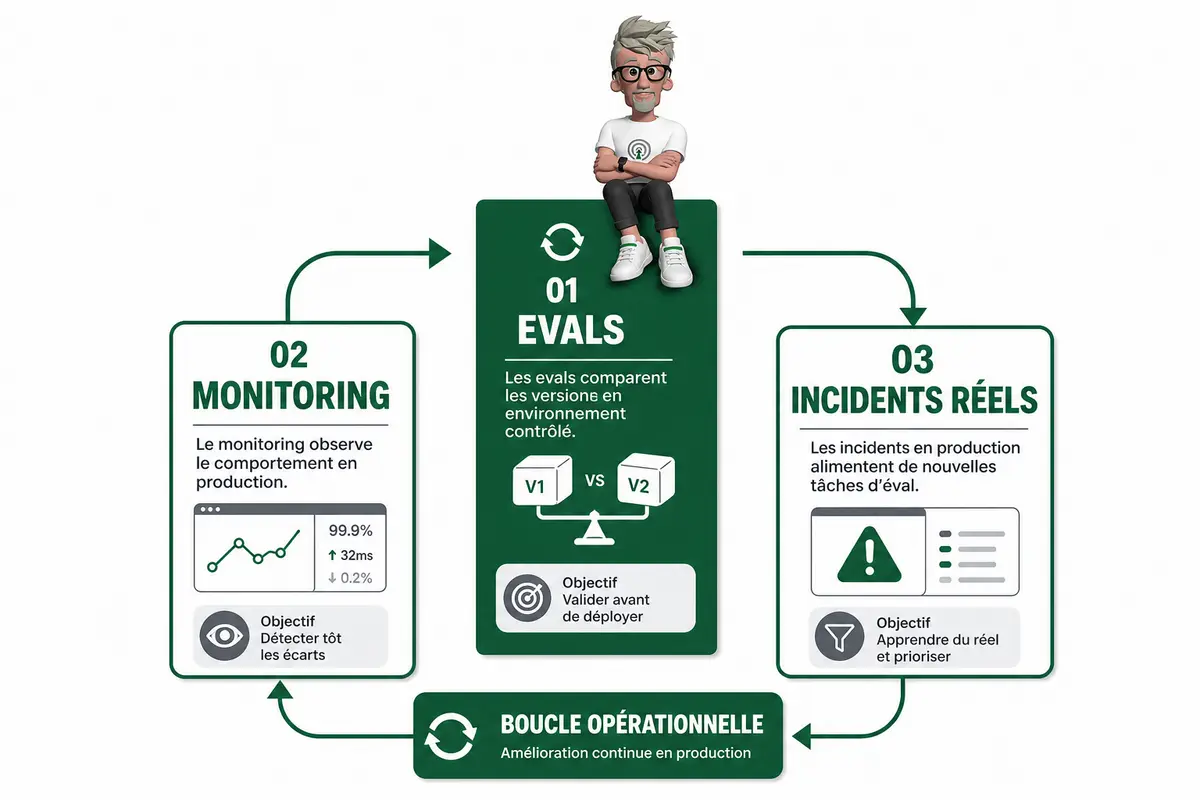
Les evals servent à comparer des versions dans un cadre contrôlé. Vous changez un prompt système, une description d’outil, un modèle, ou une étape dans un workflow. Vous voulez savoir si la nouvelle version fait mieux, pareil, ou pire que l’ancienne. C’est un banc de test. Avec des cas préparés, des critères d’évaluation, parfois un juge LLM, parfois des assertions plus simples.
Le monitoring, lui, regarde ce qui se passe en production. Avec les vrais utilisateurs. Les vraies demandes bizarres. Les lenteurs d’API. Les outils externes qui répondent mal. Les coûts qui montent sans prévenir. C’est là qu’on voit les comportements que personne n’avait imaginés en test.
| Critère | Evals | Monitoring |
| Objectif | Comparer des versions et détecter les régressions avant ou pendant un changement contrôlé. | Observer le comportement réel en production et repérer les anomalies. |
| Moment d’utilisation | Avant un déploiement, pendant un A/B test, ou lors d’une modification de prompt, modèle, outil ou workflow. | Après déploiement, en continu, sur le trafic réel. |
| Type de données | Cas de test connus, jeux d’exemples, scénarios critiques, historiques sélectionnés. | Logs, traces, coûts, latence, erreurs, appels outils, retours utilisateurs. |
| Décision associée | Est-ce que cette version peut partir en production ? | Est-ce qu’il y a un incident, une dérive, ou un nouveau cas à traiter ? |
Les deux se nourrissent en permanence. Un incident détecté en monitoring peut devenir une nouvelle tâche d’eval. Une eval qui échoue peut bloquer une régression avant déploiement. C’est cette boucle qui rend le système solide.
Un exemple simple. Un agent répond correctement en test. Il donne la bonne réponse, le ton est bon, tout passe. En production, le monitoring montre qu’il appelle trop souvent un outil inutile, par exemple une recherche CRM alors que l’information est déjà dans le contexte. Résultat, le coût grimpe et la latence aussi. L’équipe prend ce cas réel, le transforme en eval, et ajoute un critère : l’agent ne doit pas appeler l’outil si la donnée est déjà disponible. La prochaine version sera testée contre ce piège.
Une équipe mature ne cherche pas le score parfait. Elle cherche un système qui détecte les régressions, explique les échecs, et aide à décider si une version peut partir en production sans croiser les doigts.
Et si vos agents IA étaient enfin testés comme un vrai produit ?
Je retiens une chose simple : une eval d’agent IA doit aider à comprendre, pas juste à sanctionner. Il faut des tâches réelles, des critères testables, une séparation claire entre raisonnement, action et résultat final, puis un harness assez propre pour comparer les versions sans se raconter d’histoires. Le monitoring garde sa place, surtout en production, mais il ne remplace pas ces tests reproductibles. Si vous structurez ça tôt, vous évitez les régressions invisibles, les débats subjectifs et les mises en production au feeling. Le bénéfice est net : vous améliorez vos agents avec des preuves.
FAQ
- Qu’est-ce qu’une eval pour agent IA ?
Une eval pour agent IA est un test reproductible qui mesure comment un agent réalise une tâche. Elle observe le résultat final, mais aussi le raisonnement, les appels d’outils et les décisions prises pendant l’exécution. - Pourquoi une eval d’agent IA est différente d’une eval LLM classique ?
Un appel LLM classique produit souvent une seule réponse. Un agent IA travaille sur plusieurs tours, utilise des outils et réagit à des observations. Une petite erreur au début peut se propager jusqu’au résultat final. - Combien de tâches faut-il pour commencer ?
Pas besoin d’en avoir des centaines. Je commence avec les workflows fréquents, les cas limites et les scénarios que l’équipe vérifie déjà à la main. L’important, c’est que chaque tâche soit claire, répétable et utile. - Comment savoir si une tâche est bien écrite ?
Une tâche est bien écrite si deux évaluateurs peuvent arriver au même verdict. Elle doit contenir le contexte nécessaire, un résultat attendu précis et des critères de réussite observables. - Les evals suffisent-elles pour piloter un agent IA en production ?
Non. Les evals permettent de comparer des versions dans un cadre contrôlé. Le monitoring observe les vrais usages en production. Les deux sont complémentaires : le monitoring révèle des problèmes, les evals empêchent leur retour.
A propos de l’auteur
Je suis Franck Scandolera, responsable de l’agence webAnalyste et de l’organisme Formations Analytics. J’accompagne des équipes sur le tracking avancé server-side, l’Analytics Engineering, l’automatisation No/Low Code avec n8n, l’intégration de l’IA en entreprise et le SEO/GEO. J’ai travaillé pour des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez mettre en place des agents IA utiles, mesurables et mieux pilotés, je peux vous aider. Contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.