
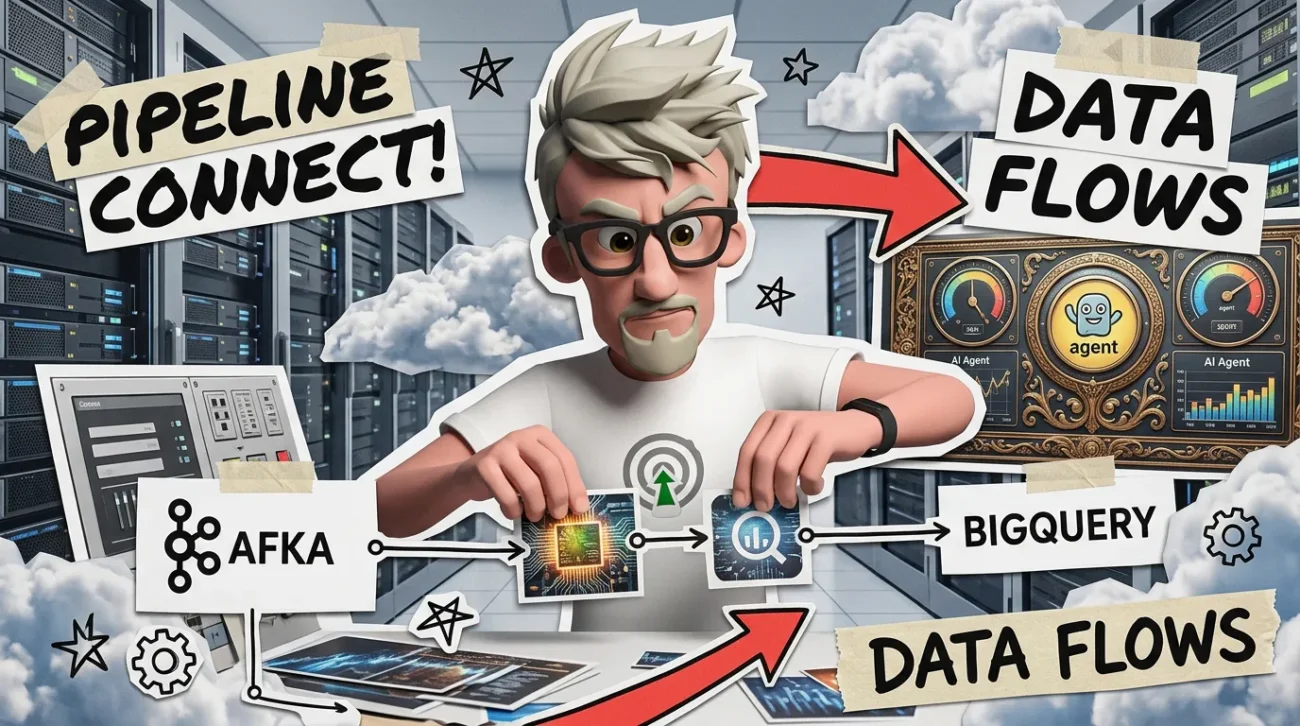




Google Data Cloud rend les pipelines data plus simples, plus fiables et plus utiles pour l’IA. Le vrai sujet, c’est moins la nouveauté produit que l’impact concret sur l’ingestion, le streaming, BigQuery, Iceberg et les bases NoSQL qui alimentent vos agents.
Qu’est ce qui fiabilise l’ingestion data ?
Les nouveautés Google Data Cloud fiabilisent surtout l’ingestion en réduisant les ruptures entre sources, streaming, batch et IA. C’est moins spectaculaire qu’une démo d’agent autonome, mais sur le terrain, c’est souvent là que tout se joue.
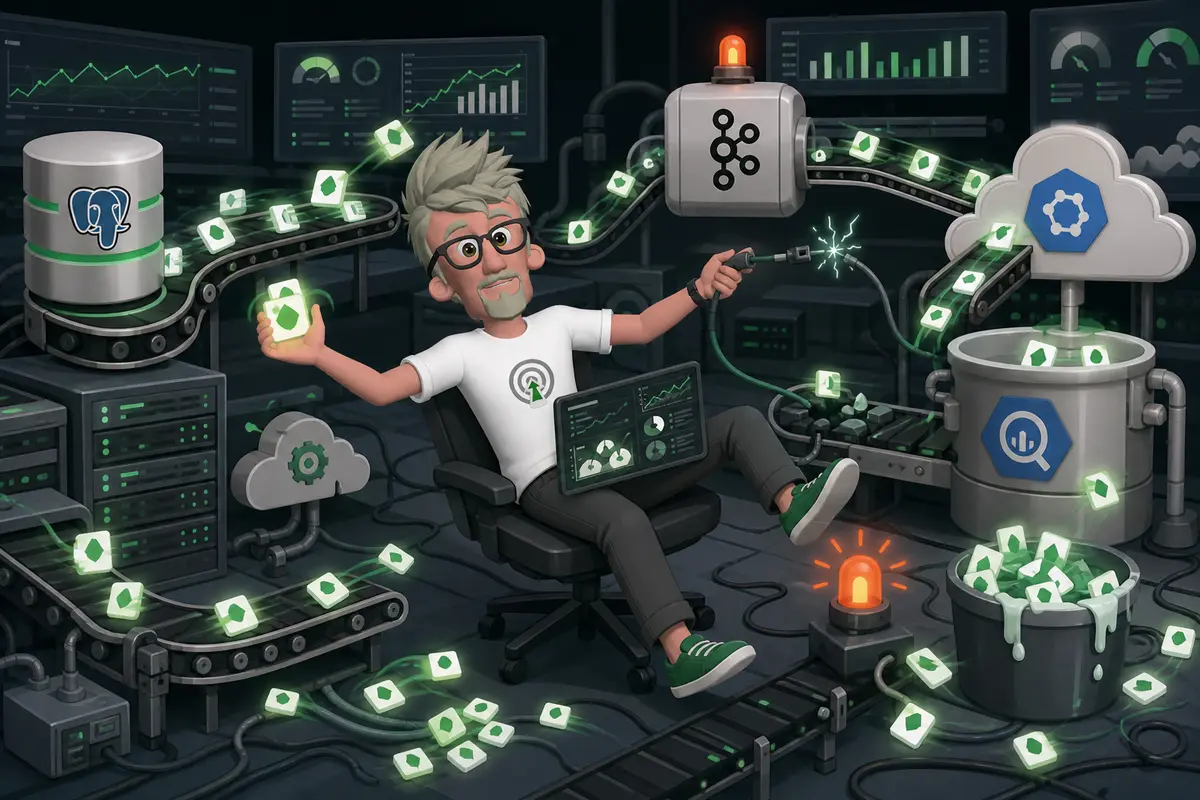
Pub/Sub sert à absorber des événements en temps réel, par exemple une commande, un clic, une alerte ou un message applicatif. Managed Service for Apache Kafka joue le rôle de bus streaming managé, utile quand vous avez déjà des usages Kafka ou des équipes habituées à cet écosystème. Dataflow traite les flux ou les lots, avec de la transformation, du filtrage, de l’agrégation. BigQuery devient la zone analytique où la donnée est requêtable, historisée et exploitable par les équipes data, IA ou métier.
Les Pub/Sub SMTs, pour Single Message Transformations, servent à transformer les messages pendant leur transit. Avec Gemini Enterprise Agent Platform, l’inférence IA peut enrichir un message directement dans le flux, par exemple classer une demande, détecter une intention ou ajouter un résumé. L’intérêt business est simple : Rapprocher la donnée exploitable du moment où elle est produite, sans empiler trois services intermédiaires juste pour ajouter un champ.
Le connecteur PostgreSQL généralement disponible pour Managed Service for Apache Kafka est aussi une brique importante. Il aide à relier une base transactionnelle à un pipeline streaming managé. Je reste prudent sur les promesses, ce n’est pas magique. Mais ça réduit la complexité opérationnelle. J’ai souvent vu des équipes perdre plus de temps sur les connecteurs, les offsets et les reprises d’erreurs que sur l’analyse elle-même.
Dataflow ajoute aussi pause-on-failure pour les jobs batch. Quand un job échoue, on évite de continuer à consommer inutilement, on garde un meilleur contrôle sur la reprise, et on limite les surprises de coût. Côté BigQuery, l’évolution de l’ancienne logique insertAll vers BigQuery Storage Write API REST va dans le même sens : Plus de robustesse, tout en gardant une logique de compatibilité pour les pipelines existants.
Exemple conceptuel de pipeline :
PostgreSQL
  -> Managed Service for Apache Kafka
  -> Dataflow
  -> BigQuery

Pub/Sub SMT + Gemini Enterprise Agent Platform
-> Enrichissement IA des messages pendant le flux| Nouveauté | Problème résolu | Impact opérationnel |
| Pub/Sub SMTs avec Gemini | Enrichissement IA trop tardif ou trop dispersé | Donnée plus exploitable dès sa production |
| Connecteur PostgreSQL pour Kafka managé | Lien fragile entre base transactionnelle et streaming | Moins de plomberie à maintenir |
| Pause-on-failure dans Dataflow batch | Jobs en échec qui consomment encore | Meilleur contrôle des reprises et des coûts |
| BigQuery Storage Write API REST | Écritures moins robustes ou héritées via insertAll | Ingestion BigQuery plus fiable et plus moderne |
BigQuery devient il plus temps réel ?
BigQuery devient plus adapté au temps réel analytique. Pas au sens où il remplace tous les moteurs de streaming du jour au lendemain, mais les continuous queries changent clairement la donne, surtout avec le traitement stateful en preview.
Stateful, ça veut dire que la requête ne traite pas juste un événement isolé, comme “un clic vient d’arriver”. Elle garde un contexte. Elle peut compter, comparer, joindre avec d’autres données, travailler sur une fenêtre de temps. C’est exactement ce qu’il faut pour du scoring de leads, de la détection d’anomalies, du monitoring produit, de l’activation marketing, ou pour alimenter un agent IA avec des signaux frais plutôt qu’avec une donnée qui date de la veille.
Les continuous queries rapprochent SQL et streaming. Et ça, c’est intéressant pour les équipes qui connaissent déjà BigQuery. Elles peuvent produire des agrégats en continu sans reconstruire toute une stack Kafka, Flink, jobs maison, observabilité custom, juste pour savoir combien d’actions un utilisateur a faites sur les 10 dernières minutes.
SELECT user_id, COUNT(*) AS events_count FROM stream_table WHERE event_time >= TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 10 MINUTE) GROUP BY user_id.
L’exemple est volontairement simplifié. Dans la vraie vie, l’implémentation dépend des tables, des formats, du mode d’ingestion et des options BigQuery disponibles. Et il faut garder une nuance importante : preview veut dire test sérieux avant production critique. Je regarderais de près les garanties de traitement, les coûts, les limites de requêtes, la latence réelle et le comportement quand le volume monte.
Le générateur de données synthétiques pour Managed Service for Apache Kafka, maintenant généralement disponible, aide beaucoup à faire ces tests. C’est pratique pour charger un cluster, valider un pipeline, simuler des événements réalistes sans attendre qu’une vraie source métier soit prête. J’ai vu des équipes perdre des semaines juste parce que “la donnée arrive bientôt”. Là, on peut avancer avant.
Les mises à jour Dataflow vont dans le même sens. Les remplacements de pipelines deviennent plus rapides et plus flexibles, avec du remplacement parallèle et une meilleure gestion des drains. Un drain, c’est l’arrêt propre d’un pipeline pour finir de traiter ce qui est déjà en cours. Bien géré, ça évite de payer trop longtemps deux traitements en parallèle.
| Use case | Brique Google Data Cloud | Point de vigilance |
| Scoring de leads frais | BigQuery continuous queries | Tester la latence et le coût par volume |
| Détection d’anomalies | BigQuery stateful processing | Valider les fenêtres temporelles et les doublons |
| Tests de charge événementiels | Managed Service for Apache Kafka avec données synthétiques | Simuler des scénarios proches du réel |
| Remplacement de pipelines | Dataflow | Surveiller les drains et les coûts pendant la transition |
| Agents IA avec signaux récents | BigQuery plus ingestion streaming | Contrôler la fraîcheur et la qualité des données |
Pourquoi Iceberg simplifie le lakehouse ?
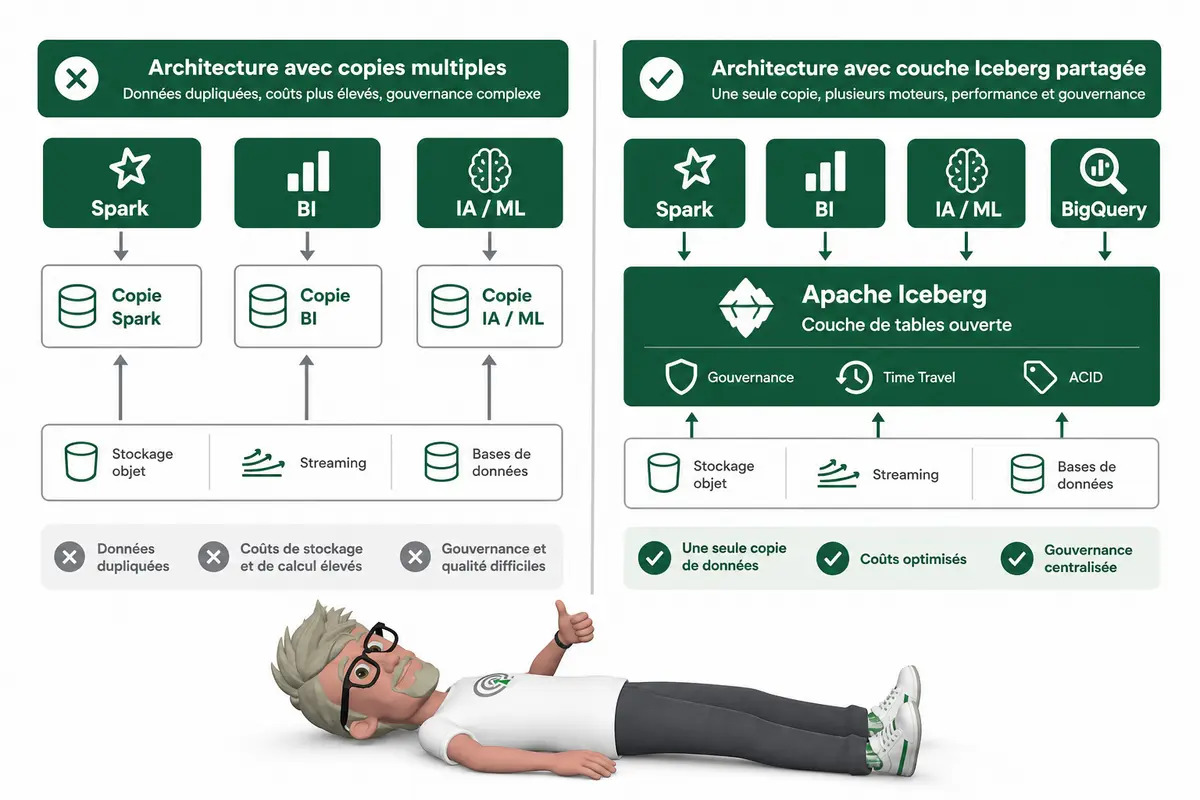
Les tables managées Lakehouse pour Apache Iceberg simplifient le lakehouse parce qu’elles évitent de copier la même donnée partout. On garde une couche de stockage partagée, propre, et plusieurs moteurs peuvent venir travailler dessus sans reconstruire leur propre version du monde.
Apache Iceberg, dit simplement, c’est un format de table ouvert pour les gros volumes analytiques. Il ne stocke pas juste des fichiers. Il gère aussi les métadonnées, l’évolution de schéma, les snapshots, et des lectures fiables par différents moteurs compatibles. Quand une colonne change, quand une table grossit, quand plusieurs traitements lisent la même donnée, Iceberg apporte un cadre plus solide qu’un simple dossier rempli de fichiers Parquet.
La preview des tables managées Lakehouse pour Apache Iceberg dans Google Data Cloud répond à un problème que je vois tout le temps chez les clients. Une équipe copie les données pour Spark. Une autre les recharge dans BigQuery. Une troisième les prépare pour l’IA. La BI garde parfois sa propre version aussi. Au bout d’un moment, personne ne sait vraiment quelle table fait foi.
Cette duplication a trois effets assez pénibles :
- Du coût, parce qu’on stocke et retraite les mêmes données plusieurs fois.
- De la latence, parce que chaque copie ajoute un délai avant que la donnée soit exploitable.
- De la confusion, parce que deux tableaux de bord peuvent raconter deux histoires différentes.
L’intérêt du managé, c’est aussi la maintenance. Google pousse ici l’idée d’une optimisation automatique des tables. Ça veut dire moins de travail manuel sur la compaction, donc le regroupement de petits fichiers en fichiers plus efficaces. Ça veut dire aussi une meilleure organisation des fichiers, de meilleures performances de lecture, et moins de scripts maison pour garder le lakehouse en état.
Ça ne veut pas dire que tout disparaît comme par magie. Il faut toujours gouverner les accès, surveiller les coûts, choisir les bons patterns de stockage, et éviter de transformer le lakehouse en décharge bien nommée. Mais on enlève une bonne partie de la friction opérationnelle.
Dans la logique des chapitres précédents, ça s’emboîte bien. L’ingestion devient plus fiable, le streaming devient plus analytique, et le lakehouse donne une couche de stockage réutilisable pour la BI, l’IA et les traitements data.
- Événements vers Pub/Sub ou Kafka.
- Traitement avec Dataflow pour nettoyer, enrichir et structurer.
- Stockage dans des tables Iceberg managées.
- Requêtes depuis BigQuery sans recopier inutilement.
- Exploitation IA pour entraîner, enrichir ou servir des cas d’usage métier.
| Approche copiée partout | Approche lakehouse partagée |
| Plusieurs copies pour Spark, BI, IA et SQL. | Une couche Iceberg partagée par plusieurs moteurs. |
| Coûts de stockage et de traitement plus élevés. | Moins de duplication, meilleure réutilisation. |
| Source de vérité floue. | Source plus claire, gouvernance plus simple. |
| Maintenance manuelle fréquente. | Optimisation managée et moins de plomberie. |
Que changent les bases NoSQL pour l’IA ?
Bigtable, Firestore et Memorystore changent surtout une chose pour l’IA : la manière de servir la donnée aux applications et aux agents. Google Data Cloud ne se limite pas à l’entrepôt analytique. Un agent IA a besoin de contexte utilisateur, d’historique, de cache, de données opérationnelles rapides, parfois avec une latence très faible. Une requête SQL seule ne suffit pas toujours.
Bigtable, c’est la base NoSQL “wide-column” de Google. Ça veut dire qu’elle stocke les données par grandes familles de colonnes, avec une organisation très efficace pour lire vite de très gros volumes. Je la vois bien quand on manipule des séries temporelles, des événements, des logs, des historiques d’activité ou des signaux utilisateurs massifs. Typiquement, quand l’agent doit retrouver “ce qui s’est passé” sur des millions ou milliards d’événements.
Firestore joue un autre rôle. C’est une base document serverless, donc sans serveur à gérer, pratique pour stocker des objets JSON proches de ce que manipule une application. Profils utilisateurs, préférences, configuration produit, état d’un parcours client, données qui évoluent vite. Pour une équipe produit qui itère beaucoup, c’est souvent plus naturel qu’un modèle relationnel rigide.
Memorystore, lui, sert surtout à aller vite. C’est une couche mémoire managée, basée sur Redis ou Memcached selon le besoin. Je l’utilise pour du cache, des sessions, des états temporaires, ou pour éviter de recalculer toujours les mêmes réponses. Ce n’est pas là qu’on met toute la vérité métier, mais c’est souvent ce qui empêche une application IA de devenir lente.
La série Beyond the Query pousse une idée simple : on ne construit pas un agent IA sérieux uniquement avec une belle requête SQL. Il faut une architecture où l’agent récupère le bon contexte, au bon moment, avec un temps de réponse acceptable.
Un exemple concret : un agent support client lit le profil du client dans Firestore, récupère son historique d’événements dans Bigtable, utilise Memorystore pour accélérer les questions fréquentes, puis s’appuie sur BigQuery pour l’analyse globale et les tendances. Là, on commence à avoir quelque chose de robuste.
Dans les projets IA, je vois souvent des prototypes impressionnants qui ralentissent dès qu’on les branche sur les vraies données. Le modèle n’est pas toujours le problème. Le choix de la base, du mode d’accès et du cache devient vite aussi important.
| Base NoSQL | Rôle principal | Exemple d’usage IA | Risque si mal utilisée |
| Bigtable | Gros volumes et faible latence | Historique d’événements client | Modèle de clés mal pensé, lectures coûteuses |
| Firestore | Données applicatives et documents | Profil utilisateur et contexte produit | Données trop dispersées, requêtes limitées |
| Memorystore | Cache et états temporaires | Réponses fréquentes ou sessions d’agent | Données périmées ou perte d’état mal gérée |
Alors on change quoi en premier ?
Google Data Cloud avance dans une direction assez claire : moins de bricolage entre les briques, plus de streaming exploitable, plus de fiabilité dans Dataflow, plus d’ouverture avec Iceberg, et des bases NoSQL mieux positionnées pour les agents IA. Ce que je retiens surtout, c’est que ces nouveautés ne servent pas à empiler des produits. Elles servent à raccourcir le chemin entre la donnée produite, la donnée analysée et la donnée utilisée par une application ou une IA. Si vous priorisez bien, vous gagnez en simplicité, en contrôle des coûts et en vitesse d’exécution.
FAQ
- Qu’est ce que Google Data Cloud apporte aux pipelines IA ?
Google Data Cloud rapproche l’ingestion, le traitement, l’analyse et les bases applicatives. Pour l’IA, l’intérêt est clair : les agents et applications peuvent s’appuyer sur des données plus fraîches, mieux structurées et plus faciles à exploiter. - BigQuery continuous queries remplace t il une plateforme streaming ?
Pas forcément. Les continuous queries rendent BigQuery plus pratique pour certains traitements analytiques en continu, surtout avec le stateful en preview. Pour des besoins streaming très spécialisés, Kafka, Pub/Sub ou Dataflow gardent leur place. - Pourquoi le traitement stateful est important ?
Parce qu’il permet de travailler avec du contexte. Au lieu de traiter chaque événement seul, on peut faire des agrégations, des jointures et des fenêtres temporelles. C’est souvent ce qui manque pour passer d’un flux brut à un signal vraiment utile. - Apache Iceberg sert à quoi dans Google Data Cloud ?
Iceberg aide à gérer de grandes tables analytiques dans un format ouvert. Les tables managées Lakehouse pour Iceberg visent à réduire la duplication des pipelines, faciliter l’interopérabilité entre moteurs et simplifier la maintenance des données. - Bigtable Firestore et Memorystore ont quel rôle pour les agents IA ?
Bigtable peut servir des historiques massifs à faible latence, Firestore stocke facilement du contexte applicatif ou utilisateur, Memorystore accélère les accès via le cache ou l’état temporaire. Pour un agent IA, ces briques peuvent être aussi importantes que le modèle lui-même.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. Avec webAnalyste et Formations Analytics, j’accompagne des équipes data, marketing et produit sur des sujets très concrets : pipelines fiables, mesure propre, activation des données et automatisation. J’ai travaillé avec Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football, Texdecor et d’autres. Si vous voulez structurer vos données pour l’IA et le business, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.