




Je les choisis quand mes services doivent arrêter de se bloquer entre eux. Les event-driven microservices rendent l’architecture plus souple, mais ils ajoutent aussi de la complexité. Je vais poser le vrai arbitrage entre API synchrones, événements, modèle hybride et contraintes de production.
C’est quoi les event-driven microservices ?
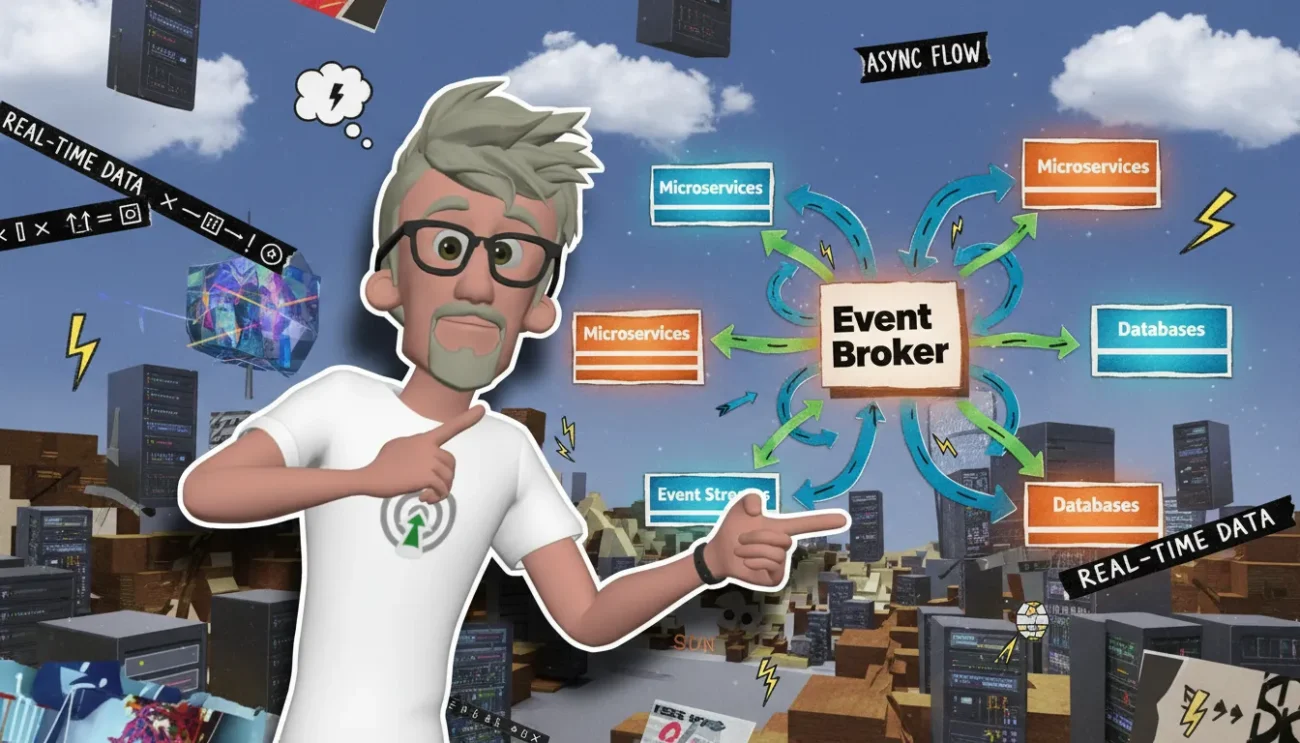
Les event-driven microservices sont des services indépendants qui communiquent en publiant des événements plutôt qu’en s’appelant directement à chaque action.
Pour moi, c’est surtout ça le point important. Un microservice définit une frontière fonctionnelle. Par exemple, le service commande gère les commandes, le service paiement gère les paiements, le service notification gère les messages envoyés aux clients. Chacun a son périmètre, ses données, sa logique.
L’event-driven architecture, elle, définit plutôt une façon de communiquer. Au lieu de dire “Service commande appelle directement service facturation, puis service email, puis service analytics”, on dit “Service commande publie un fait, et ceux qui sont intéressés réagissent”. Les deux notions se complètent très bien, mais elles ne veulent pas dire la même chose.
Un événement, ce n’est pas une demande vague. C’est un fait déjà arrivé. Une commande a été créée. Un paiement a été accepté. Un utilisateur a modifié son profil. C’est important, parce qu’on ne publie pas “merci de créer une facture”, on publie “commande créée”, et le service facturation décide quoi faire avec cette information.
Dans une architecture event-driven, on retrouve souvent trois éléments simples :
- Producteurs d’événements : Ils publient les faits métier quand quelque chose arrive.
- Consommateurs : Ils écoutent certains événements et déclenchent leur propre traitement.
- Broker : Il transporte les événements entre producteurs et consommateurs. Ça peut être Kafka, RabbitMQ, Google Pub/Sub, AWS SNS/SQS, peu importe l’outil au départ.
Prenons un e-commerce. Le service commande crée une commande, puis publie l’événement “Commande créée”. Le service facturation le consomme pour générer une facture. Le service notification le consomme pour envoyer un email. Le service analytics le consomme pour mettre à jour les tableaux de bord. Chaque service avance de son côté, sans bloquer les autres.
| Élément | Rôle | Exemple |
| Producteur | Publie un événement après un fait métier | Le service commande publie “Commande créée” |
| Consommateur | Réagit à un événement qui l’intéresse | Le service notification envoie un email |
| Broker | Diffuse les événements entre services | Kafka, RabbitMQ, Pub/Sub |
Chez un client, le vrai déclic n’a pas été le choix du broker. Franchement, on peut passer des semaines à comparer Kafka et RabbitMQ. Le déclic est venu quand les équipes ont arrêté de faire dépendre chaque service de la disponibilité immédiate des autres. Là, l’architecture a commencé à respirer.
Quand faut-il éviter les appels synchrones ?
Il faut éviter les appels synchrones quand une action peut continuer sans attendre immédiatement la réponse d’un autre service. C’est vraiment le critère simple que j’utilise. Si l’utilisateur n’a pas besoin de la réponse maintenant, je préfère découpler.
Le modèle request-driven fonctionne avec un appel et une réponse immédiate. Un service appelle un autre service, attend sa réponse, puis décide quoi faire. C’est très utile quand on doit répondre tout de suite à l’utilisateur, par exemple pour une authentification, un paiement, un checkout ou une vérification de stock avant validation.
Sa limite arrive quand le service appelé ralentit ou tombe. Le service appelant attend. Puis il échoue. Puis il réessaie parfois. Et si plusieurs services dépendent les uns des autres, on peut créer des ralentissements en cascade. Rien de magique là-dedans, c’est juste une chaîne trop serrée. J’ai déjà vu un simple service d’email mal configuré ralentir une inscription complète. Pas parce que l’inscription était cassée, mais parce qu’elle attendait trop de choses inutiles.
Le modèle event-driven prend le problème autrement. Un service annonce un fait au broker, par exemple “Utilisateur inscrit”, puis il continue son travail. Le broker, c’est l’intermédiaire qui reçoit les événements et les distribue aux services intéressés. Le service email, l’analytics ou le CRM peuvent traiter l’événement à leur rythme.
C’est plus résilient, parce qu’un service secondaire peut être temporairement indisponible sans bloquer le parcours principal. C’est aussi plus scalable, parce qu’on peut ajouter plusieurs consommateurs pour absorber plus de volume. Mais ce n’est pas gratuit. Il faut gérer explicitement l’ordre des événements, les retries, les délais et les erreurs. Sinon on déplace juste le chaos ailleurs.
Un bon exemple, c’est l’inscription utilisateur. Le compte doit être créé rapidement. Mais l’email de bienvenue, l’envoi dans l’analytics et la synchronisation CRM ne devraient pas forcément bloquer la réponse affichée à l’utilisateur.
| Cas d’usage | Synchrone | Event-driven | Pourquoi |
| Authentification | Oui | Non | L’utilisateur doit savoir immédiatement s’il peut entrer. |
| Paiement | Oui | Partiellement | La validation doit être immédiate, mais les notifications peuvent être asynchrones. |
| Inscription utilisateur | Pour créer le compte | Pour email, analytics, CRM | Le parcours principal ne doit pas attendre les tâches secondaires. |
| Notification email | Rarement | Oui | Un retard email ne doit pas bloquer l’action métier. |
| Synchronisation CRM | Rarement | Oui | Le CRM peut se mettre à jour avec quelques secondes de délai. |
Comment construire une architecture hybride ?
Je choisis rarement le tout event-driven par principe. La bonne architecture est souvent hybride. Des API synchrones pour les interactions immédiates, et des événements asynchrones pour tout ce qui peut vivre en arrière-plan sans bloquer l’utilisateur.
Si votre client valide une commande, il attend une réponse claire. Paiement accepté ou refusé. Commande créée ou erreur. Là, une API checkout synchrone reste logique, parce qu’on veut une réponse fiable et rapide. Pour la notification, la facturation secondaire, l’analytics, l’enrichissement CRM ou la mise à jour d’un moteur de recherche, l’asynchrone est souvent plus propre. J’ai vu des équipes rendre leur checkout fragile juste parce qu’elles voulaient tout brancher en direct. Au moindre service lent, toute l’expérience client tombait avec.
Le flux simple ressemble à ça : le client valide sa commande, l’API checkout répond immédiatement, puis elle publie un événement OrderCreated. Les services aval écoutent cet événement et font leur travail chacun de leur côté.
import { Kafka } from "kafkajs";
import crypto from "crypto";

const kafka = new Kafka({ clientId: "shop", brokers: ["localhost:9092"] });

// Producteur côté API checkout
async function publishOrderCreated(order) {
  const producer = kafka.producer();
  await producer.connect();

  const event = {
    specversion: "1.0",
    id: crypto.randomUUID(), // Identifiant unique de l'événement
    type: "OrderCreated", // Type d'événement métier
    source: "checkout-api",
    time: new Date().toISOString(), // Horodatage
    correlationId: order.requestId, // Identifiant pour suivre tout le parcours
    data: { // Payload métier
      orderId: order.id,
      customerId: order.customerId,
      amount: order.amount
    }
  };

  await producer.send({
    topic: "orders",
    messages: [{ key: order.id, value: JSON.stringify(event) }]
  });

  await producer.disconnect();
}

// Consommateur billing
async function startBillingConsumer() {
  const consumer = kafka.consumer({ groupId: "billing-service" });
  const processed = new Set(); // En production, utilisez Redis ou une table dédiée

  await consumer.connect();
  await consumer.subscribe({ topic: "orders" });

  await consumer.run({
    eachMessage: async ({ message }) => {
      const event = JSON.parse(message.value.toString());
      if (processed.has(event.id)) return; // Idempotence simple

      console.log("Billing invoice for", event.data.orderId);
      processed.add(event.id);
    }
  });
}

// Consommateur notification séparé
async function startNotificationConsumer() {
  const consumer = kafka.consumer({ groupId: "notification-service" });
  const processed = new Set();

  await consumer.connect();
  await consumer.subscribe({ topic: "orders" });

  await consumer.run({
    eachMessage: async ({ message }) => {
      const event = JSON.parse(message.value.toString());
      if (processed.has(event.id)) return;

      console.log("Send confirmation for", event.data.customerId);
      processed.add(event.id);
    }
  });
}
J’utilise Kafka ici parce qu’il parle à beaucoup de monde, mais le raisonnement reste le même avec RabbitMQ, NATS ou un service managé cloud comme EventBridge, Pub/Sub ou Service Bus.
Une structure inspirée de CloudEvents aide beaucoup. Pas besoin d’en faire une religion, mais standardiser id, type, source, time et correlationId rend l’observabilité et le debugging moins pénibles. Quand un paiement a déclenché trois effets de bord, vous êtes content de pouvoir suivre le fil sans ouvrir quinze dashboards au hasard.
Quels gains peut-on attendre ?
Les gains principaux que j’attends d’une architecture event-driven, c’est la scalabilité, la résilience, l’autonomie des équipes et parfois une meilleure maîtrise des coûts. Je dis “parfois” parce que ce n’est pas magique. Un broker mal exploité, des événements mal conçus, ou un monitoring absent, et on remplace juste un problème simple par un problème distribué.
Le premier vrai gain, c’est la scalabilité autonome. Chaque service consommateur peut grossir selon sa propre charge, sans obliger toute l’application à scaler. Prenez un checkout e-commerce. Le service de paiement publie un événement “CommandeValidée”. Derrière, vous avez un service de notifications, un service analytics, un service facturation. Si un soir vous avez un gros pic de notifications, parce qu’une campagne marketing part d’un coup, vous scalez seulement le consommateur notifications. Le checkout, lui, continue de faire son boulot. Il ne devrait pas ralentir juste parce que les emails ou les SMS prennent du retard.
Le deuxième gain, c’est le confinement des pannes. Si le service analytics tombe, l’action principale peut continuer. L’événement reste dans le broker, par exemple Kafka, RabbitMQ ou Google Pub/Sub, puis il sera traité plus tard. C’est très confortable quand c’est bien fait. Mais je reste prudent là-dessus. Ça dépend de la configuration du broker, de la durée de rétention, des retries, et de la gestion des erreurs. Si vous gardez les événements 10 minutes et que le service tombe 2 heures, vous n’avez pas gagné grand-chose.
Il y a aussi un gain de vitesse côté développement. Une équipe peut ajouter un nouveau consommateur sans modifier le service producteur, tant que le contrat d’événement reste stable. C’est puissant. J’ai vu des équipes ajouter de la fraude, du reporting ou du CRM sans toucher au cœur transactionnel. Mais il faut une vraie gouvernance des schémas. Un schéma, c’est la structure officielle d’un événement. Sinon, au bout de six mois, personne ne sait quels champs sont fiables, lesquels sont obsolètes, et chaque consommateur interprète l’événement à sa sauce.
Côté coûts, c’est intéressant aussi. On scale là où il y a besoin, pas partout. Mais ce n’est pas automatique. Le broker coûte, le monitoring coûte, l’exploitation coûte, et les compétences aussi.
| Bénéfice | Ce que ça change | Condition pour que ça marche |
| Scalabilité | Chaque consommateur scale selon sa charge réelle. | Avoir des services découplés et des files bien dimensionnées. |
| Résilience | Une panne secondaire ne bloque pas forcément l’action principale. | Configurer rétention, retries et gestion des erreurs. |
| Autonomie des équipes | Une équipe ajoute un consommateur sans modifier le producteur. | Maintenir un contrat d’événement stable et documenté. |
| Coûts | On évite de scaler toute l’application inutilement. | Mesurer le coût réel du broker, du monitoring et de l’exploitation. |
Quels pièges surveiller en production ?
Les pièges à surveiller en production, je les vois toujours revenir au même endroit : la cohérence éventuelle, l’observabilité, le debugging et la surcharge d’infrastructure. Sur le papier, les event-driven microservices sont élégants. En vrai, si on ne cadre pas bien ces points, on remplace un problème de couplage par un problème de brouillard.
La cohérence éventuelle, c’est simple : les données ne sont pas alignées partout au même instant, mais elles finissent par converger. Une commande peut être confirmée dans le service Order, pendant que la facture est encore en cours de génération et que la notification client part trois secondes plus tard. Ce n’est pas un bug. C’est le modèle.
Ça change complètement la façon de concevoir l’UX et les écrans internes. Il faut arrêter de penser uniquement en “fait” ou “pas fait”. On doit afficher des statuts intermédiaires : “paiement validé”, “facture en attente”, “notification à envoyer”, “traitement en reprise”. J’ai vu des équipes paniquer parce qu’un back-office affichait une commande sans facture pendant quelques secondes. Le système marchait très bien, mais l’écran racontait mal la réalité.
L’observabilité devient non négociable. Sans correlation ID, c’est-à-dire un identifiant partagé entre tous les services pour suivre une même action, sans event ID, sans logs propres et sans timestamps cohérents, retrouver le parcours d’un événement devient vite pénible. Le traçage distribué aide beaucoup, parce qu’il montre le chemin entre services. Les métriques de lag consommateur aussi : elles indiquent si un consommateur prend du retard sur les événements à traiter.
Le debugging est plus subtil. Une erreur n’est plus seulement une stack trace dans un service. Elle peut venir d’un événement ancien rejoué, traité deux fois, consommé dans le mauvais ordre ou bloqué dans une dead-letter queue, une file où l’on met les messages impossibles à traiter après plusieurs essais.
Et il faut être franc : l’infrastructure coûte cher en attention. Broker, monitoring, gestion des schémas, retries, DLQ, sécurité, droits d’accès… Pour une petite architecture avec peu de flux, c’est parfois trop tôt.
- Idempotence : Un même événement peut être reçu deux fois sans casser les données.
- Retries : Les erreurs temporaires sont rejouées proprement.
- Dead-letter queue : Les messages en échec sont isolés et analysables.
- Schema versioning : Les formats d’événements évoluent sans casser les consommateurs.
- Correlation ID : Chaque action métier est traçable de bout en bout.
- Monitoring du lag : Les retards de consommation sont visibles.
- Alerting : Les anomalies déclenchent une alerte avant le client.
Alors, on passe à l’événementiel ?
Je ne choisirais pas les event-driven microservices juste parce que c’est élégant sur un schéma d’architecture. Je les choisirais quand les services doivent évoluer sans se bloquer, quand les traitements aval peuvent être différés, et quand l’équipe est prête à gérer la complexité qui vient avec. Le bon réflexe, dans la vraie vie, c’est souvent l’hybride : synchrone pour ce qui demande une réponse immédiate, événementiel pour ce qui peut vivre en arrière-plan. Si vous posez bien les contrats, l’observabilité et les retries, vous gagnez en résilience, en scalabilité et en vitesse d’évolution.
FAQ
- Qu’est-ce qu’un event-driven microservice ?
C’est un microservice qui communique en publiant ou en consommant des événements. Au lieu d’appeler directement un autre service à chaque action, il annonce qu’un fait s’est produit. D’autres services peuvent ensuite réagir à cet événement. - Quelle différence avec une API synchrone classique ?
Une API synchrone attend une réponse immédiate. C’est pratique pour une connexion, un paiement ou une validation utilisateur. L’event-driven fonctionne plutôt en arrière-plan : le service publie un événement, puis les consommateurs le traitent sans bloquer l’action principale. - Pourquoi utiliser une architecture hybride ?
Parce que tout ne mérite pas d’être asynchrone. Une bonne architecture garde les API synchrones pour les interactions temps réel et utilise les événements pour les traitements secondaires comme les notifications, l’analytics, la facturation ou la synchronisation avec d’autres outils. - Quels sont les principaux risques en production ?
Les risques principaux sont la cohérence éventuelle, les événements traités plusieurs fois, les erreurs difficiles à tracer, les problèmes d’ordre et le coût d’exploitation du broker. Il faut prévoir des IDs de corrélation, de l’idempotence, des retries, une dead-letter queue et un monitoring sérieux. - Quel broker choisir pour des event-driven microservices ?
Il n’y a pas de meilleur choix universel. Kafka est souvent utilisé pour des flux durables et volumineux, RabbitMQ pour des files et du routage plus classique, NATS pour des échanges légers et rapides. Le bon choix dépend du volume, de la latence, de la rétention, des compétences de l’équipe et du niveau d’exploitation accepté.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes sur des sujets où la donnée, les événements, les API et l’automatisation doivent tenir en production, pas seulement en démo. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez structurer une architecture data, IA ou event-driven proprement, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.