
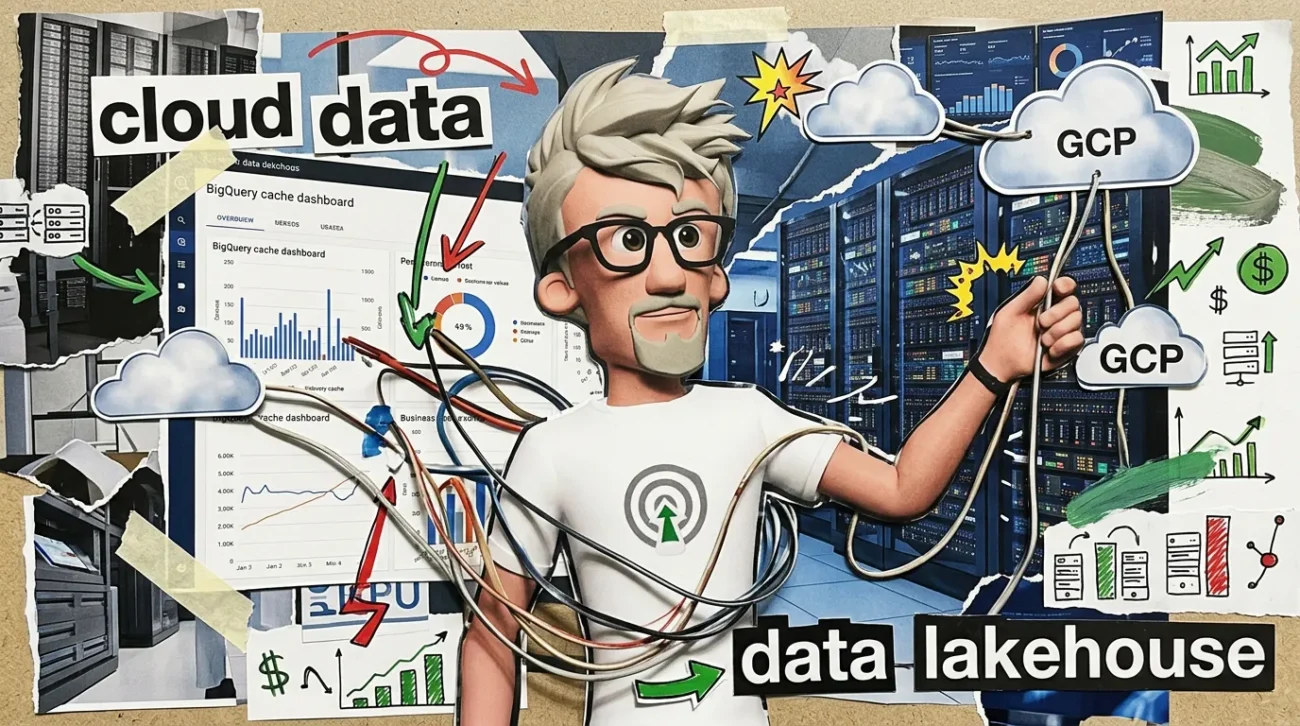




Le cross-cloud caching accélère BigQuery en rapprochant les données consultées souvent, sans forcer leur copie complète. Le vrai sujet, c’est moins de transferts intercloud, moins d’ETL fragiles, et des requêtes plus rapides sur des données gouvernées là où elles vivent.
Besoin d'aide ? Découvrez les solutions de notre agence BigQuery .
Pourquoi le lakehouse devient-il borderless ?
Le lakehouse devient borderless parce que les données ne vivent plus dans un seul cloud, ni dans un seul outil.
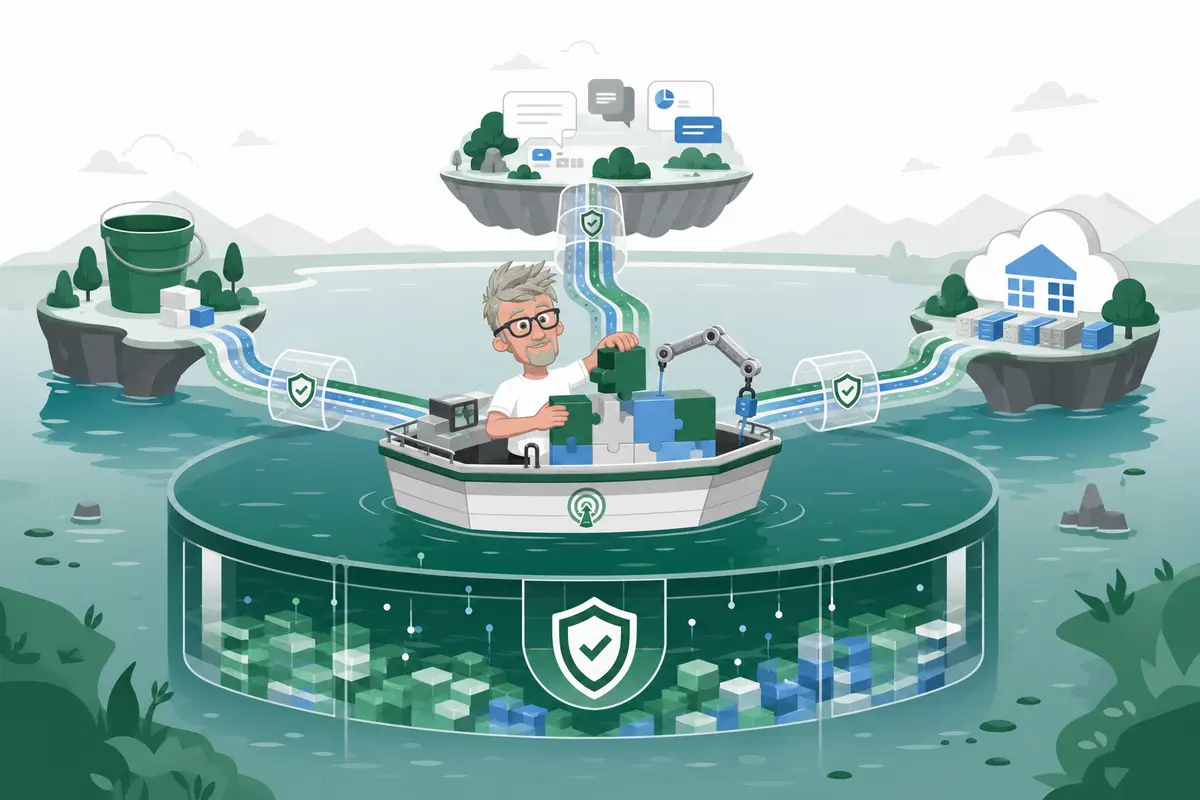
Je le vois chez presque tous les clients : une partie des fichiers est dans Amazon S3, une autre dans ADLS côté Azure, quelques datasets dans Google Cloud Storage, les données fraîches dans des bases opérationnelles, et le reste éparpillé dans des SaaS. Salesforce, ServiceNow, HubSpot, Stripe, peu importe. Le patrimoine data ressemble rarement à un joli schéma propre.
Le problème, c’est que les équipes data, les métiers, et maintenant les agents IA, doivent interroger tout ça comme si c’était un seul environnement logique. Pas pour le plaisir. Pour répondre vite à une question business, alimenter un modèle, vérifier un risque, ou construire un dashboard fiable.
Les approches classiques ont longtemps consisté à copier les données. On extrait, on transforme, on recharge. C’est l’ETL, pour Extract, Transform, Load. Ça marche, mais ça casse souvent quand les sources changent, ça coûte cher quand on traverse les clouds, et ça multiplie les versions d’une même donnée. À la fin, quelqu’un demande “c’est quoi la bonne table ?” et là, on sait que la gouvernance a pris un coup.

Le vrai objectif du borderless lakehouse, c’est plus simple : interroger des données gouvernées là où elles résident. Sans tout déplacer par réflexe. Sans recréer dix copies. Sans perdre les règles d’accès, les métadonnées, le lignage, c’est-à-dire l’historique de ce qui est arrivé à la donnée.
Les briques qui vont dans ce sens deviennent importantes :
- Le support du catalogue Apache Iceberg REST, pour accéder à des tables ouvertes sans rester enfermé dans un moteur unique.
- Les connexions fédérées vers Databricks Unity Catalog, pour lire des actifs déjà gouvernés côté Databricks.
- Les connexions vers AWS Glue et Snowflake Horizon, pour retrouver les métadonnées et les permissions là où elles existent déjà.
- L’interconnect privé intercloud, pour réduire les coûts réseau et éviter de faire circuler les données sur des chemins publics quand ce n’est pas nécessaire.
Ce n’est pas magique. Il faut quand même penser sécurité, droits, performance, formats de table, et coûts de requêtes. Mais le gain est très concret : moins de friction, moins de duplication, plus de contrôle. Et quand BigQuery peut interroger plus facilement cet écosystème dispersé, le caching cross-cloud devient beaucoup plus intéressant, parce qu’on accélère l’accès sans forcément déplacer tout le lac de données.
Que change le cross-cloud caching ?
Le cross-cloud caching change surtout la vitesse et le coût des requêtes BigQuery sur des données situées dans d’autres clouds.
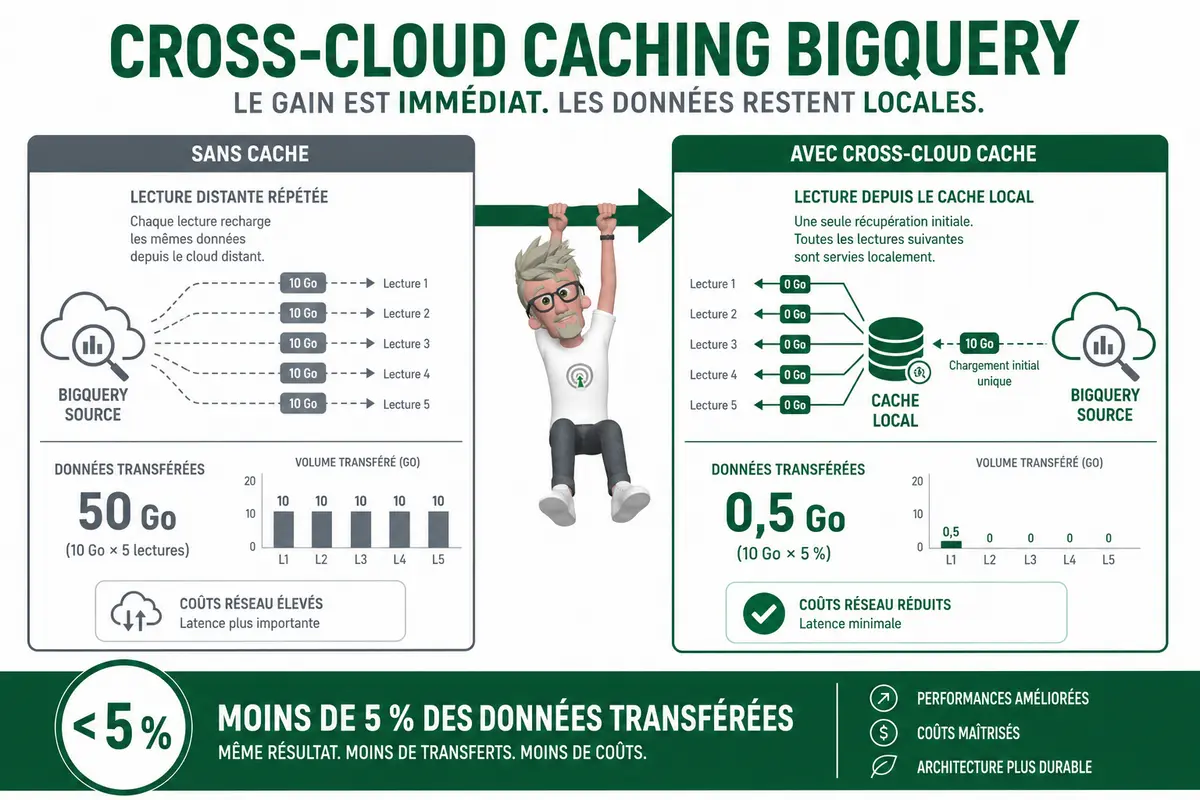
La nouveauté principale, disponible en preview pour Lakehouse, c’est que BigQuery peut mettre en cache localement dans Google Cloud les données intercloud fréquemment consultées. Dit simplement, si vos données sont dans AWS ou Azure, BigQuery n’a pas forcément besoin de les retransférer encore et encore à chaque requête.
C’est important parce que BigQuery sait déjà exécuter des analyses sur des données qui restent dans leur cloud d’origine. On garde donc l’idée du lakehouse distribué, sans copier tout le lac de données dans Google Cloud. Mais avec le cache, on évite un piège classique : relire les mêmes blocs distants à chaque tableau de bord, chaque job SQL, chaque analyse métier.
Le point fort annoncé est assez parlant : avec la compression colonne d’Iceberg et le cache, il est souvent nécessaire de transférer moins de 5 % des données traitées. Iceberg, pour faire simple, organise les données en tables ouvertes avec des métadonnées propres, ce qui aide les moteurs comme BigQuery à lire uniquement les colonnes et les fichiers utiles. Donc on ne déplace pas tout le lac. On ramène seulement ce qui sert vraiment.
Sur le terrain, je vois souvent le même sujet revenir. Les coûts cachés dans les projets data ne viennent pas seulement du calcul. Ils viennent aussi des mouvements de données répétés. Un export par-ci, une réplication par-là, une requête distante relancée toutes les heures. Au début ça passe inaperçu. Puis la facture réseau et la latence deviennent un vrai sujet.
Ça se connecte aussi aux BigQuery cross-cloud connections, également en preview, qui permettent d’interroger des données non-Iceberg situées dans d’autres clouds. C’est utile parce que tout le monde n’a pas encore standardisé son lakehouse sur Iceberg. Vous pouvez donc avancer progressivement, sans devoir tout migrer avant de commencer à analyser.
| Sans cache | Avec cross-cloud caching |
| Les mêmes données distantes peuvent être relues plusieurs fois. | Les blocs fréquemment consultés sont gardés localement dans Google Cloud. |
| Plus de latence sur les requêtes répétées. | Les analyses récurrentes répondent plus vite. |
| Les coûts de transfert peuvent grimper discrètement. | Moins de mouvements réseau, donc un coût mieux maîtrisé. |
| On subit davantage la distance entre clouds. | BigQuery rapproche les données utiles sans déplacer tout le lac. |
Comment le cache reste-t-il fiable ?
Le cache reste fiable parce qu’il ne se contente pas de stocker des copies, il contrôle aussi ce qui est lu, où c’est isolé, et si les données sont fraîches.
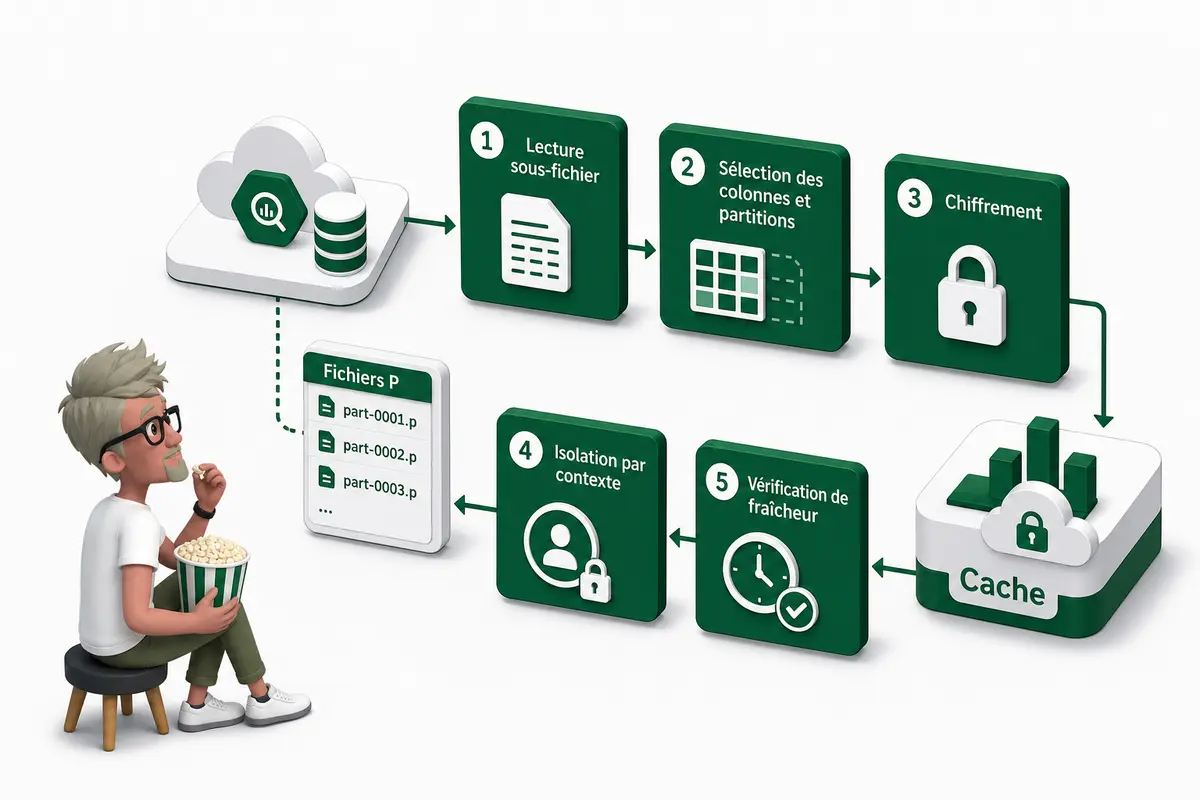

Le point important, c’est que le cache cross-cloud ne fonctionne pas comme un gros tiroir où BigQuery déposerait des fichiers entiers au hasard. Il travaille à une granularité plus fine, souvent sous-fichier. Dit simplement, si une table externe repose sur des fichiers Parquet, BigQuery ne va pas forcément rapatrier tout le fichier si seules certaines plages internes sont utiles.
C’est un peu comme ouvrir un livre directement aux pages qui parlent du sujet, au lieu de photocopier tout le bouquin. Avec Parquet, les données sont organisées en blocs et en colonnes. Si votre requête lit seulement trois colonnes et filtre une période précise, BigQuery peut limiter les lectures. Ça rejoint deux optimisations classiques : le partition pruning, qui évite de lire les partitions hors sujet, et la projection de colonnes, qui évite de charger les colonnes inutiles.
Voici un exemple conceptuel. Il sert juste à montrer l’idée : moins de colonnes, moins de périodes, donc moins de blocs à transférer et à mettre en cache.
-- Lecture ciblée : seules les colonnes utiles sont demandées
-- Le filtre temporel permet d'éviter les partitions hors période

SELECT
  customer_id,
  event_date,
  amount
FROM
  external_sales_table
WHERE
  event_date BETWEEN DATE '2025-01-01' AND DATE '2025-01-31';
Le cache reste aussi fiable côté sécurité. Les données mises en cache sont chiffrées au repos par défaut avec GMEK, c’est-à-dire des clés gérées par Google. Pour être clair, ça veut dire que les données stockées temporairement dans l’environnement Google ne restent pas en clair sur disque.
L’autre garde-fou, c’est l’isolation. Le cache est strictement séparé par projet, région et catalogue. Une donnée mise en cache pour un projet ne devient pas visible depuis un autre projet. Même logique pour la région et le catalogue. J’ai déjà vu des équipes confondre cache et partage de données, et c’est là que les mauvaises surprises arrivent. Ici, le cache accélère l’accès, il ne change pas les droits.
Dernier point clé : la fraîcheur. BigQuery vérifie si les données sources ont changé avant de réutiliser le cache. Si le cache est obsolète, il ne doit pas servir une vieille version comme si de rien n’était. C’est ce contrôle qui évite les lectures périmées.
| Mécanisme | Rôle | Bénéfice |
| Granularité sous-fichier | Lire seulement les blocs utiles dans les fichiers, par exemple Parquet | Moins de données transférées, moins de latence |
| Projection de colonnes et partition pruning | Limiter les colonnes et les partitions lues | Requêtes plus rapides et coûts mieux maîtrisés |
| Chiffrement GMEK | Chiffrer les données au repos avec des clés gérées par Google | Protection par défaut des données mises en cache |
| Isolation par projet, région et catalogue | Séparer strictement les contextes d’accès | Pas de fuite entre environnements |
| Vérifications de fraîcheur | Contrôler si la source a changé avant lecture | Moins de risque de lire des données obsolètes |
Quel scénario tester en premier ?
Le bon premier test, c’est une table Iceberg volumineuse déjà consultée souvent, mais stockée hors de Google Cloud.
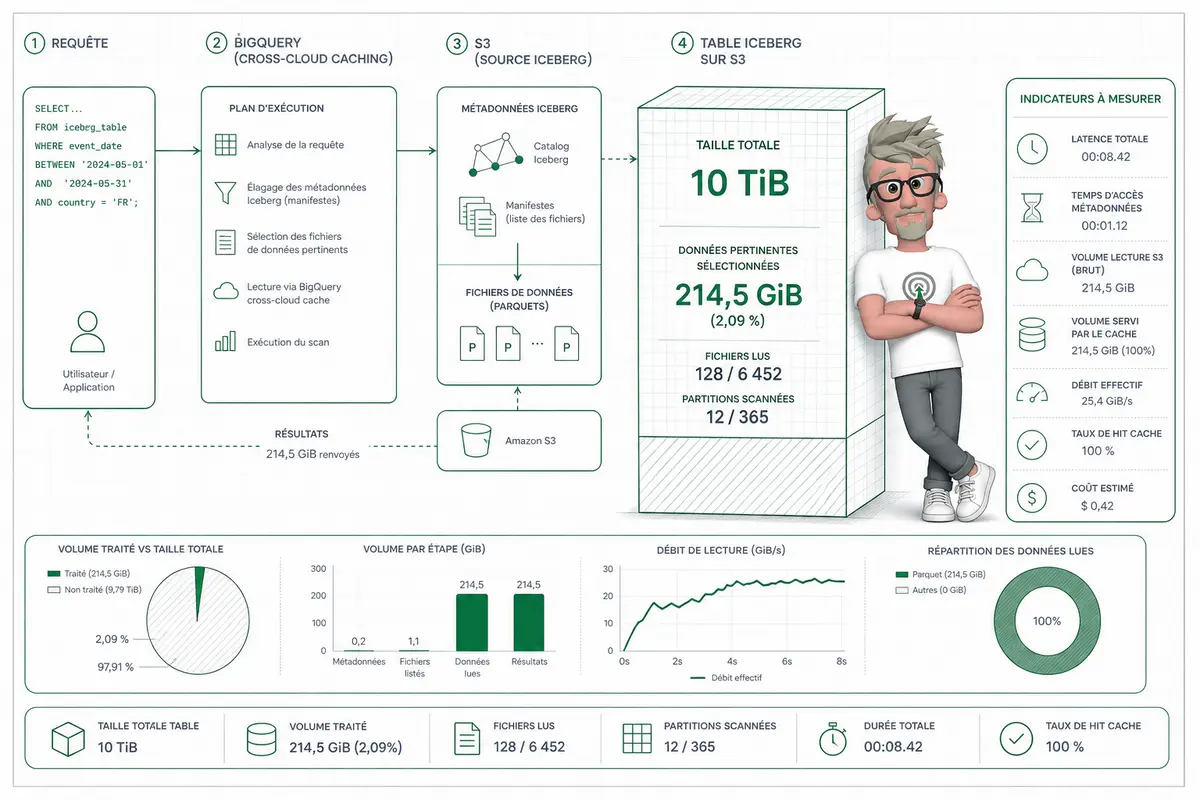
Je prendrais l’exemple e-commerce tel quel. Une équipe analyse une table Iceberg de 10 TiB stockée dans Amazon S3, et cette table est fédérée depuis Databricks Unity Catalog. Iceberg, c’est le format de table qui garde les métadonnées, les partitions et les fichiers Parquet organisés proprement. Unity Catalog, c’est la couche de gouvernance Databricks qui dit qui a le droit de voir quoi.
La première requête est une requête à froid. Le cache cross-cloud n’a pas encore servi. BigQuery doit donc aller lire les données nécessaires côté S3. Mais il ne lit pas bêtement les 10 TiB. Il utilise le partition pruning, donc il ignore les partitions inutiles, et la projection de colonnes, donc il ne récupère que les colonnes demandées. En clair, si votre requête filtre sur une période et ne demande que 5 colonnes, BigQuery ne transfère que les plages Parquet utiles.
Dans l’exemple, on parle de 214,5 GiB traités sur l’ensemble du jeu de données. Je resterais strict là-dessus. Je n’extrapole pas un gain magique sur tous les workloads, parce que ça dépend trop des filtres, des colonnes, des partitions et de la répétition des requêtes.
Dans un test réaliste, je surveille surtout ces points :
- Le volume traité, pour savoir ce que BigQuery analyse vraiment.
- Le volume réellement transféré, parce que c’est là que le cross-cloud peut coûter cher.
- La répétition des requêtes, car un cache devient intéressant quand les accès se ressemblent.
- La fraîcheur des données, pour vérifier que le cache ne gêne pas les besoins métier.
- La séparation par projet et région, parce qu’un bon test doit éviter les mélanges impossibles à interpréter.
| Je teste si | Pourquoi |
| Les requêtes sont répétitives | Le cache a une vraie chance d’être réutilisé. |
| Les tables sont grosses | Le moindre évitement de lecture peut compter. |
| Les coûts de transfert intercloud pèsent | C’est souvent le vrai irritant, plus que le SQL lui-même. |
| La gouvernance interdit les copies massives | Le cache peut éviter de dupliquer toute la donnée. |
Je le traiterais comme une preview, pas comme une généralisation immédiate. Je commence avec deux ou trois cas contrôlés, je mesure proprement, puis seulement après je décide si ça mérite d’être étendu.
Est-ce que ça vaut le coup de le tester maintenant ?
Pour moi, le cross-cloud caching répond à un vrai problème data : on a des données partout, mais on ne veut plus payer le prix technique et financier de les recopier partout. Le borderless Lakehouse pousse dans cette direction : interroger des données gouvernées là où elles résident, avec BigQuery, Iceberg, des catalogues fédérés et maintenant un cache local pour accélérer les lectures fréquentes. Le point à garder en tête, c’est le statut preview. Je le testerais d’abord sur des tables lourdes, souvent interrogées, avec des coûts intercloud visibles. Le bénéfice pour vous : aller plus vite sans casser votre architecture data existante.
FAQ
- Qu’est-ce que le cross-cloud caching pour BigQuery ?
Le cross-cloud caching permet à BigQuery de mettre en cache dans Google Cloud des données intercloud souvent consultées. L’objectif est simple : éviter de retransférer les mêmes blocs depuis un autre cloud à chaque requête, tout en gardant les données à leur emplacement d’origine. - Est-ce que le cross-cloud caching copie toutes les données ?
Non. Le principe décrit repose sur une granularité sous-fichier. BigQuery peut transférer seulement les blocs nécessaires, par exemple certaines plages Parquet utiles à la requête. Avec Iceberg, la compression colonne et le cache, moins de 5 % des données traitées peuvent souvent devoir être transférées. - Quelles sources sont concernées par le borderless Lakehouse ?
Le borderless Lakehouse vise les données dispersées entre plusieurs clouds et outils : Amazon S3, ADLS, Google Cloud Storage, bases opérationnelles, SaaS, catalogues Iceberg, Databricks Unity Catalog, AWS Glue ou Snowflake Horizon. L’idée est d’interroger les données gouvernées là où elles résident. - Comment Google Cloud évite les lectures obsolètes dans le cache ?
Le fonctionnement annoncé inclut des vérifications de fraîcheur. Le cache n’est donc pas seulement une copie rapide : il doit aussi vérifier que les données lues restent cohérentes avec la source. C’est indispensable dès qu’on parle de données analytiques partagées entre clouds. - Faut-il déjà l’utiliser en production ?
La fonctionnalité est annoncée en preview. Je la testerais d’abord sur un cas contrôlé : grosse table Iceberg, requêtes répétitives, coûts intercloud mesurables, besoin clair de gouvernance. C’est le bon moyen de valider le gain avant de l’étendre à des usages critiques.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne des équipes data, marketing et business sur des sujets très concrets : collecte fiable, gouvernance, automatisation, exploitation de la donnée et performance. J’ai travaillé avec des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez cadrer ce type de sujet dans votre entreprise, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.