





L’Agentic Commerce Analytics mesure les interactions et les achats réalisés par des agents IA, pas seulement les visites humaines. Je détaille les écarts avec l’analytique classique, le rôle du suivi côté serveur, l’évolution des équipes et les exigences d’une architecture adaptée.
Besoin d'aide ? Découvrez les solutions de notre agence d'agents IA.
Que mesure l’Agentic Commerce Analytics ?
L’Agentic Commerce Analytics mesure les interactions et les décisions commerciales impliquant des agents d’intelligence artificielle, en complément des parcours web et applicatifs humains. Je ne regarde donc plus uniquement ce qu’un visiteur fait sur un site ou dans une application. Je prends aussi en compte les interactions commerciales qui passent par des API, des interfaces conversationnelles ou des agents autonomes.
L’analytique numérique classique est principalement centrée sur les visites mesurées côté navigateur. Elle observe un parcours où la personne consulte des pages et interagit avec une interface. L’Agentic Commerce Analytics doit couvrir un ensemble plus large de points de contact : les API, les interfaces conversationnelles et les agents qui interviennent dans une décision commerciale. Le parcours n’est plus nécessairement visible sous la forme d’une succession de pages visitées.
Un achat effectué directement par un assistant peut laisser beaucoup moins de signaux côté client qu’un parcours web classique. Quand l’achat se déroule sans visite visible sur le site, les données habituellement associées aux interactions dans le navigateur peuvent être moins présentes. Je dois donc tenir compte du fait que les échanges et les décisions commerciales ne produisent pas tous les mêmes traces côté client.
Cette évolution change l’objectif marketing. Il ne s’agit plus uniquement d’optimiser les pages pour des visiteurs humains. Je dois aussi rendre les données structurées, lisibles par machine et accessibles aux agents. La qualité de l’information et sa capacité à être interprétée deviennent centrales, car un agent doit pouvoir s’appuyer sur des données exploitables pour intervenir dans un parcours commercial.
La mesure porte ainsi sur les interactions et décisions impliquant des agents IA, tout en conservant la lecture des parcours humains sur le web et dans les applications. L’enjeu est de suivre une activité commerciale qui peut se dérouler dans le navigateur, via une API ou dans une interface conversationnelle, avec des signaux côté client qui varient selon le parcours.
Pourquoi l’attribution des achats devient-elle plus difficile ?
L’attribution devient plus difficile parce qu’un achat réalisé par un agent peut générer peu ou pas de signaux navigateur. La vente risque alors d’être classée comme trafic direct ou non attribuée, même si elle résulte d’une action marketing.
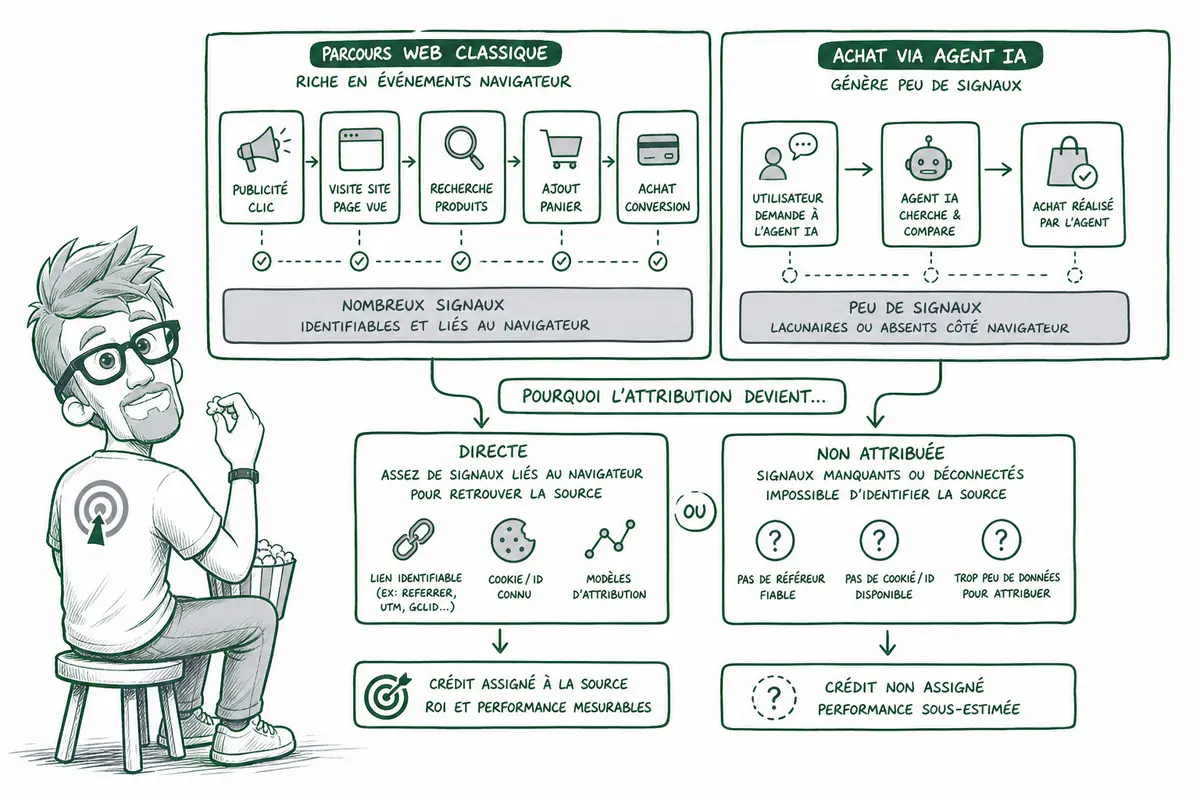
Dans un parcours web classique, le navigateur peut transmettre de nombreux événements côté client au fil de la visite et de l’achat. Ces signaux aident à relier la conversion aux interactions précédentes. Avec un achat déclenché via une API ou un assistant IA, le parcours peut laisser beaucoup moins de traces côté navigateur. Il peut ne produire que quelques données côté serveur.
Le problème n’est pas seulement technique. Quand une partie des achats échappe aux signaux utilisés pour l’attribution, je ne peux plus lire les performances marketing avec la même confiance. Une source peut sembler moins contributrice qu’elle ne l’est réellement, ou une vente peut apparaître sans origine identifiable. Les résultats deviennent plus difficiles à comparer entre les parcours classiques et ceux initiés par un agent.
Ce décalage ne signifie pas que chaque achat via un agent sera invisible. Il signifie que les données navigateur seules peuvent ne pas suffire à représenter le parcours. J’intègre donc le suivi côté serveur à l’analyse : il permet de mieux prendre en compte les transactions enregistrées côté serveur, même lorsque les signaux navigateur sont limités.
| Parcours web classique | Achat via agent |
| Nombreux événements possibles côté client, transmis par le navigateur. | Déclenché via une API ou un assistant IA. |
| Signaux navigateur disponibles pour relier les interactions à l’achat. | Peu ou pas de signaux navigateur ; quelques données côté serveur peuvent être disponibles. |
| La vente peut être associée à une source marketing. | La vente risque d’être classée comme trafic direct ou non attribuée. |
Quel rôle joue le suivi côté serveur ?
Le suivi côté serveur permet de collecter des données liées aux achats via API, puis de les valider ou de les enrichir avant leur transmission aux plateformes analytiques. Je le considère comme un complément nécessaire au suivi côté client, pas comme un remplacement universel.
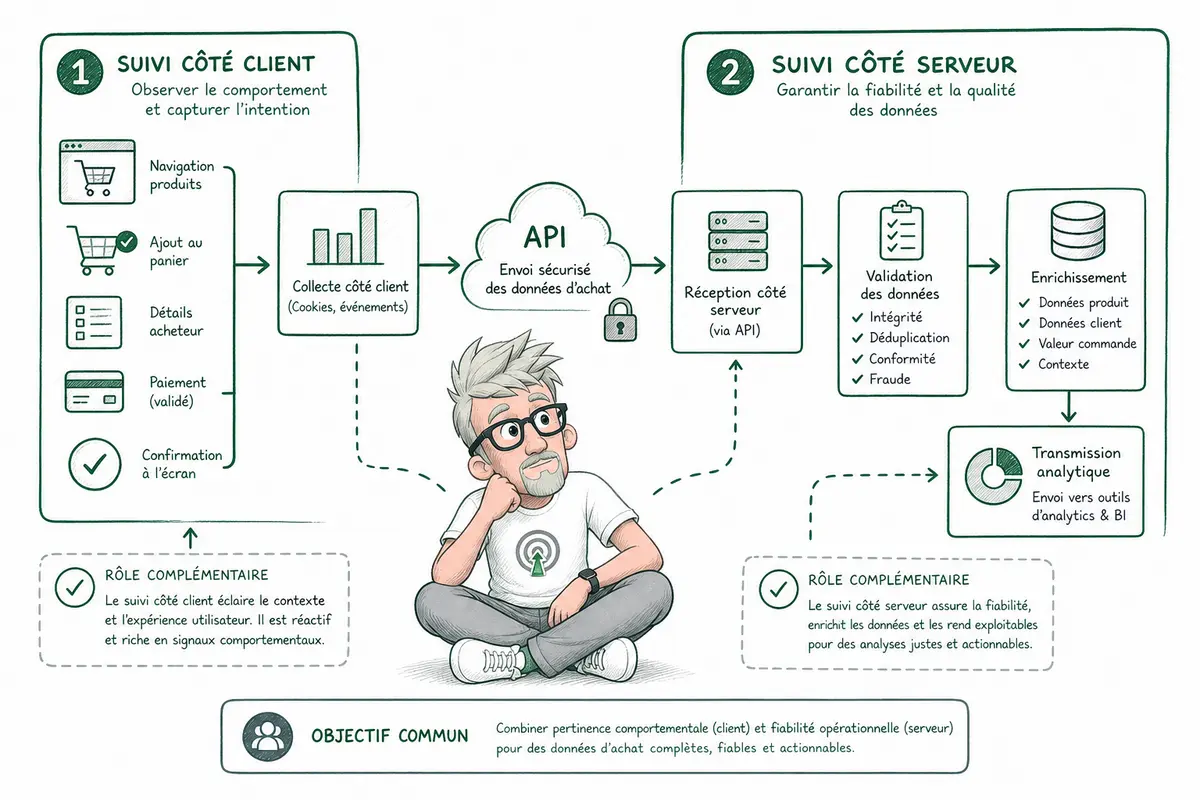
Le suivi côté client repose sur des pixels exécutés dans le navigateur. Ils peuvent enregistrer des événements comme une consultation de produit ou un achat, mais leur collecte dépend de l’environnement de l’utilisateur. Les règles de confidentialité peuvent limiter le partage de données, les bloqueurs de publicité empêcher l’exécution des pixels et certains agents d’achat ne disposent tout simplement pas d’un navigateur classique. Une partie des événements peut alors manquer ou arriver avec des informations incomplètes.
Côté serveur, les données d’achat peuvent être transmises par API sans dépendre de l’exécution d’un pixel dans le navigateur. Je peux les valider et, lorsque les informations disponibles le permettent, les enrichir avant leur envoi. Ça améliore la qualité des données transmises et limite certaines pertes de mesure. Sur des parcours mêlant utilisateurs, assistants et plateformes, cette continuité devient particulièrement utile.
Ça ne règle pas tout. Le suivi côté serveur ne recrée pas les événements qui n’ont jamais été collectés, ne garantit pas l’identification d’un utilisateur et ne résout pas à lui seul les limites d’attribution. Les données doivent aussi être traitées conformément aux règles de consentement et de confidentialité applicables. En pratique, je privilégie une combinaison des deux approches, avec des données cohérentes et des responsabilités de collecte clairement définies.
Différences principales
| Critère | Suivi côté client | Suivi côté serveur |
| Collecte | Pixels exécutés dans le navigateur | Données transmises via API |
| Dépendances | Navigateur, règles de confidentialité et bloqueurs | Moins dépendant du navigateur et de l’exécution des pixels |
| Traitement | Collecte effectuée dans le contexte du navigateur | Validation et enrichissement possibles avant transmission |
| Limite | Des événements peuvent être bloqués ou perdus | Ne supprime pas toutes les pertes ni les problèmes d’attribution |
Comment les équipes doivent-elles s’organiser ?
L’analytique agentique répartit le travail entre un ingénieur humain en données et en IA, un agent analytique IA et un décideur humain. Je considère cette répartition comme un partage de responsabilités : l’agent accélère l’analyse, mais les choix stratégiques restent humains.
L’ingénieur conçoit la couche sémantique, c’est-à-dire le modèle commun qui donne un sens cohérent aux données et aux indicateurs. Il structure les informations produit pour qu’elles soient exploitables par l’agent, puis maintient les API (interfaces de programmation applicatives) qui permettent aux systèmes d’échanger des données et des instructions. Cette base conditionne la qualité des analyses : si les définitions ou les données produit sont incohérentes, l’agent peut produire des signaux trompeurs.
L’agent analytique surveille les indicateurs, recherche les causes possibles des anomalies et déclenche des rapports ou des alertes. Il peut faire remonter une variation inhabituelle et étayer le signal avec les éléments disponibles. Il ne décide pas de la réponse stratégique à apporter. Je garde cette frontière nette : détecter et analyser n’équivaut pas à arbitrer.
Le décideur interprète les signaux dans leur contexte, pilote les expérimentations et reste responsable des choix stratégiques. Il peut s’appuyer sur les analyses de l’agent pour orienter une décision, puis évaluer les résultats des expérimentations. Les trois rôles se complètent : l’ingénieur fiabilise les fondations, l’agent rend les signaux plus rapides à détecter et le décideur transforme ces signaux en décisions.
| Rôle | Responsabilités |
| Ingénieur humain en données et en IA | Conçoit la couche sémantique, structure les informations produit et maintient les API. |
| Agent analytique IA | Surveille les indicateurs, recherche les causes des anomalies et déclenche des rapports ou des alertes. |
| Décideur humain | Interprète les signaux, pilote les expérimentations et reste responsable des choix stratégiques. |
Quels fondements techniques faut-il prévoir ?
La faisabilité de l’analytique agentique dépend d’une architecture capable de prendre en compte les interactions via API et de s’appuyer sur des protocoles de communication standardisés. Sans ces échanges, je ne peux pas relier de façon cohérente les actions des agents aux données commerciales et aux résultats observés.
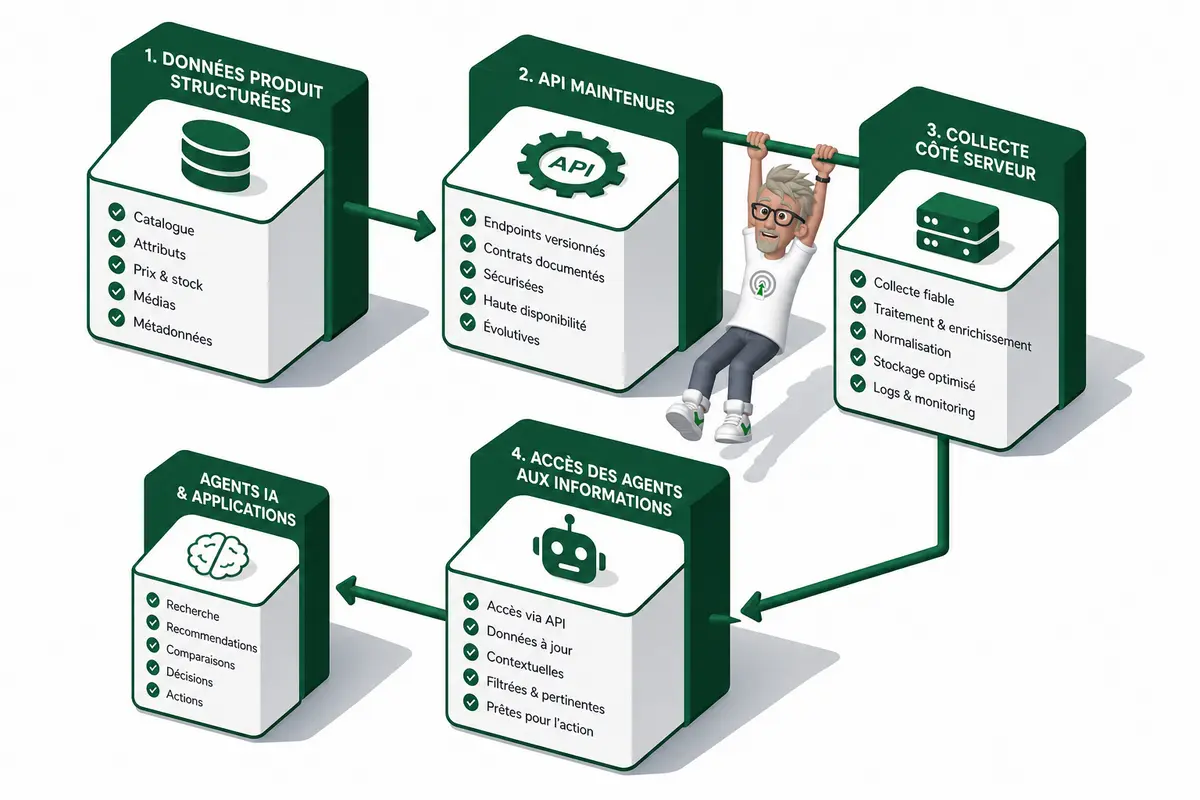
Le socle déjà établi repose sur quatre éléments : des données produit structurées, des API maintenues, une collecte côté serveur et des informations accessibles aux agents. Ces éléments permettent de rendre les données exploitables et de suivre les interactions sans dépendre uniquement des signaux captés dans le navigateur. Une donnée produit mal structurée reste difficile à interpréter. Une API non maintenue fragilise les échanges. Une collecte incomplète limite l’analyse des interactions.
Les exigences ne doivent pas être confondues avec les choix d’implémentation. Les faits disponibles établissent la nécessité d’interactions via API et d’échanges standardisés. Ils ne précisent pas quels protocoles, outils, fournisseurs ou schémas techniques doivent être retenus. Je ne peux donc pas en recommander un sans connaître les contraintes du projet : systèmes existants, données exposées, exigences de sécurité et besoins de mesure.
Le cadrage doit séparer ce qui est requis de ce qui reste à décider. Les données structurées, les API maintenues, la collecte côté serveur et l’accès des agents à l’information constituent les exigences établies. Le protocole de communication, les modalités d’authentification, le format des échanges et le périmètre des événements relèvent des décisions propres au projet. Cette distinction évite de présenter un choix technique comme une nécessité universelle.
Les points à cadrer sont limités au socle suivant :
- Données produit structurées et accessibles.
- API disponibles, maintenues et adaptées aux interactions visées.
- Collecte côté serveur des événements utiles à l’analyse.
- Standardisation des échanges entre les agents et les systèmes concernés.
Que retenir pour préparer votre analytique au commerce agentique ?
L’Agentic Commerce Analytics élargit la mesure au-delà des visites humaines et des pixels navigateur. Les achats déclenchés par des agents via des API peuvent laisser moins de signaux, ce qui fragilise l’attribution si la collecte repose uniquement sur le client. Le suivi côté serveur aide à valider et enrichir les données, tandis que des informations produit structurées et accessibles aux machines deviennent essentielles. Les équipes doivent aussi répartir clairement les responsabilités entre ingénieur, agent analytique et décideur humain. Les protocoles précis restent à définir selon l’architecture retenue. En préparant ces fondations, vous améliorez la visibilité sur les achats agentiques et la qualité de vos décisions marketing.
FAQ
-
Qu’est-ce que l’Agentic Commerce Analytics ?
C’est une discipline analytique qui mesure aussi les interactions et les achats impliquant des agents IA, au-delà des visites humaines sur un site ou une application. -
En quoi diffère-t-elle de l’analytique numérique classique ?
L’analytique classique s’appuie principalement sur les visites et les données côté navigateur. L’analytique agentique doit également prendre en compte les API, les interfaces conversationnelles et les agents autonomes. -
Pourquoi les achats réalisés par des agents sont-ils difficiles à attribuer ?
Un achat via un assistant ou une API peut produire peu de signaux côté navigateur. Sans collecte côté serveur, la vente risque d’être classée comme trafic direct ou non attribué. -
Quel est l’intérêt du suivi côté serveur ?
Il permet de valider et d’enrichir les données avant leur transmission aux plateformes analytiques, et de mieux mesurer les achats réalisés via API. -
Quel est le rôle d’un agent analytique IA ?
Il peut surveiller les indicateurs, rechercher les causes d’anomalies et déclencher des rapports ou des alertes. Le décideur humain reste responsable des choix stratégiques.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Analytics, Data engineering et automatisation IA. J’accompagne les équipes dans la structuration des données, la fiabilisation de la mesure et la conception de dispositifs analytiques adaptés aux nouveaux usages de l’IA.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.