





La précision du pipeline CRM mesure la part des revenus réellement susceptibles d’être conclus sur une période donnée. Une couverture élevée ne suffit pas à fiabiliser vos prévisions : je distingue les indicateurs, les écarts de données et les erreurs de configuration qui peuvent gonfler votre pipeline.
Besoin d'aide ? Découvrez les solutions de notre agence Data Marketing .
Que mesure la précision du pipeline ?
La précision du revenu du pipeline mesure la correspondance entre la valeur enregistrée dans le CRM et les revenus qui devraient réellement être conclus pendant une période donnée. Elle répond à une question simple : le montant inscrit dans le pipeline reflète-t-il les revenus attendus pour cette période ?
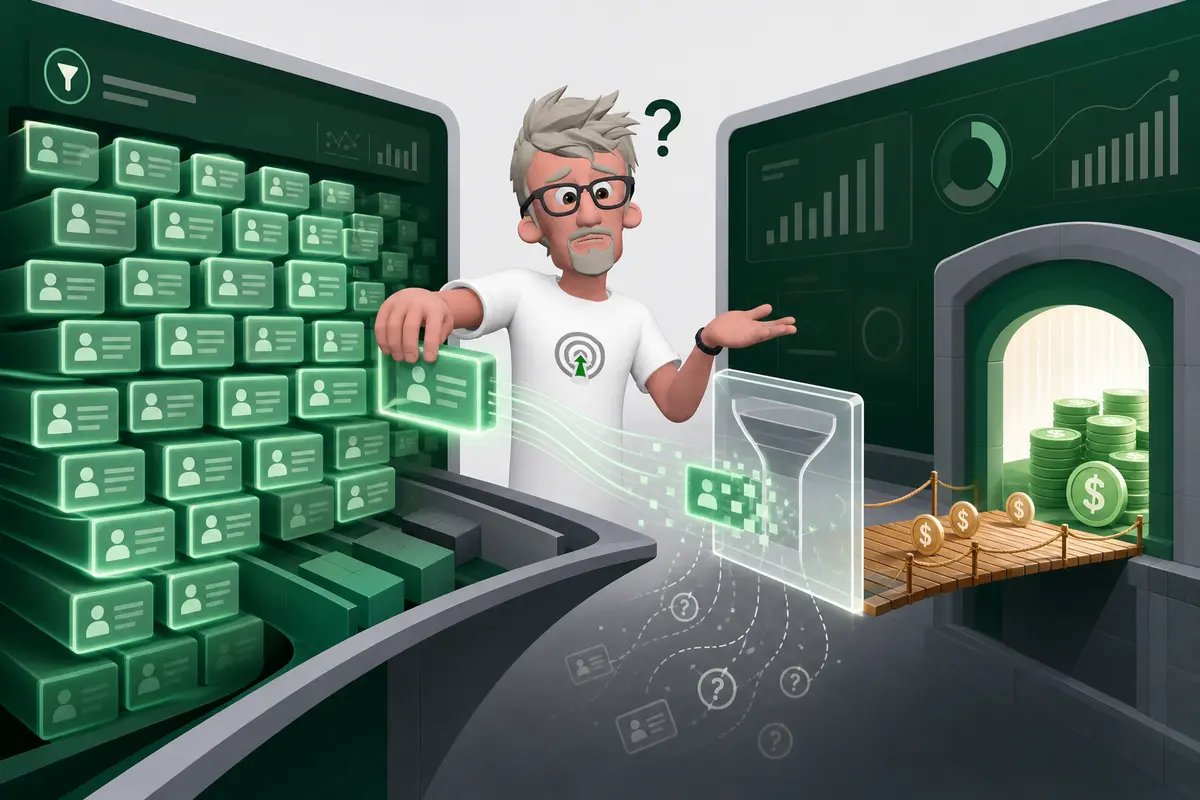
Cette mesure ne décrit pas la taille du pipeline. Le volume indique la valeur qui y est enregistrée, sans dire à lui seul quelle part devrait être conclue pendant la période. Un pipeline peut donc être volumineux sans être précis.
Le ratio de couverture met le volume du pipeline en regard du quota à atteindre. Il renseigne sur le niveau de couverture du quota, pas sur la correspondance entre les montants enregistrés et les revenus qui devraient réellement être conclus. Une couverture élevée ne garantit donc pas une estimation précise.
La précision des prévisions se mesure, elle, après la clôture de la période. Elle permet de comparer les prévisions avec ce qui s’est effectivement conclu. La précision du revenu du pipeline porte sur les revenus attendus pour une période donnée ; la précision des prévisions évalue une prévision une fois la période terminée. Le moment de la mesure et ce qu’on cherche à vérifier ne sont pas les mêmes.
Comment réussir son planning CMO 2027 ?
Ces indicateurs ne sont pas interchangeables. Le volume décrit la quantité présente dans le pipeline, le ratio de couverture la met en relation avec le quota, et la précision des prévisions s’évalue après la clôture. La précision du revenu du pipeline vérifie plutôt si la valeur inscrite dans le CRM correspond aux revenus qui devraient être conclus sur la période. Les confondre peut donner une impression trompeuse de fiabilité : un pipeline important ou bien couvert n’est pas nécessairement précis.
Pourquoi la couverture ne garantit-elle pas vos objectifs ?
Non. La couverture mesure le montant du pipeline disponible par rapport au quota. La précision du pipeline mesure si ce montant correspond à des affaires réellement susceptibles d’aboutir. Les deux indicateurs répondent à des questions différentes.
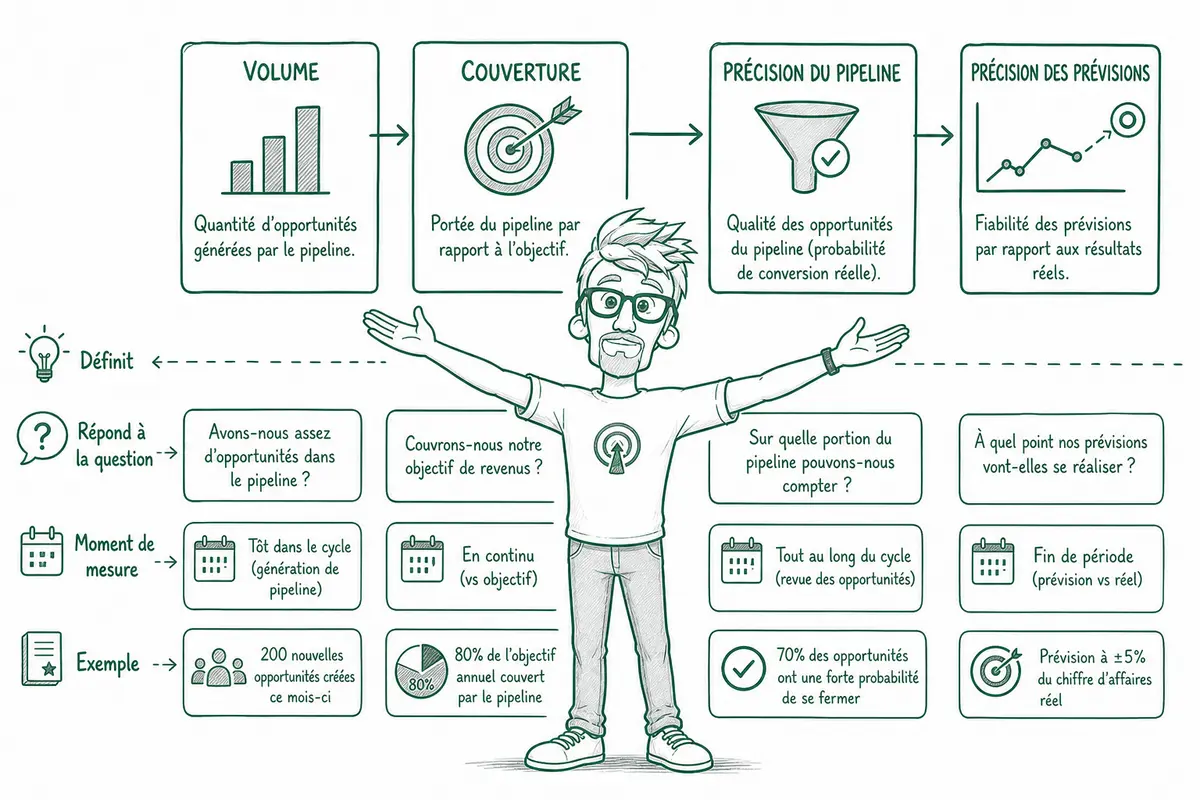
Une couverture élevée peut donc coexister avec des prévisions fragiles. Le CRM peut contenir beaucoup d’opportunités, sans que leur stade, leur calendrier ou leur probabilité de conclusion soient suffisamment fiables. Le volume affiché donne alors une impression de sécurité que la qualité des affaires ne justifie pas.
Pour prévoir les ventes, je ne m’arrête pas au montant inscrit dans le CRM. Je regarde si les opportunités sont bien qualifiées et si leur progression reflète la réalité commerciale. Une affaire enregistrée n’est pas une vente acquise. Si les données sont incomplètes ou trop optimistes, le pipeline peut sembler couvrir le quota tout en donnant peu de visibilité sur le résultat final.
Cette distinction compte aussi pour la confiance accordée au CRM. Un outil peut afficher beaucoup de données et rester peu utile à la décision si ces données ne sont pas fiables. La couverture aide à évaluer le volume disponible. La précision du pipeline aide à juger sa crédibilité. La précision des prévisions, elle, se vérifie en comparant les prévisions aux résultats obtenus.
Ces indicateurs se complètent, mais ne se remplacent pas :
| Indicateur | Ce qu’il mesure |
| Volume | Le montant total des opportunités enregistrées dans le pipeline. |
| Couverture | Le montant du pipeline disponible comparé au quota. |
| Précision du pipeline | La fiabilité des opportunités et du montant qu’elles représentent. |
| Précision des prévisions | La proximité entre les ventes prévues et les résultats réalisés. |
Pourquoi les données CRM peuvent-elles tromper ?
Non, pas à lui seul. Un CRM peut enregistrer chaque appel, e-mail ou changement de statut sans garantir que les informations saisies sont exactes, complètes ou à jour. Le volume d’activité visible ne suffit donc pas à prouver que le pipeline reflète la réalité commerciale.
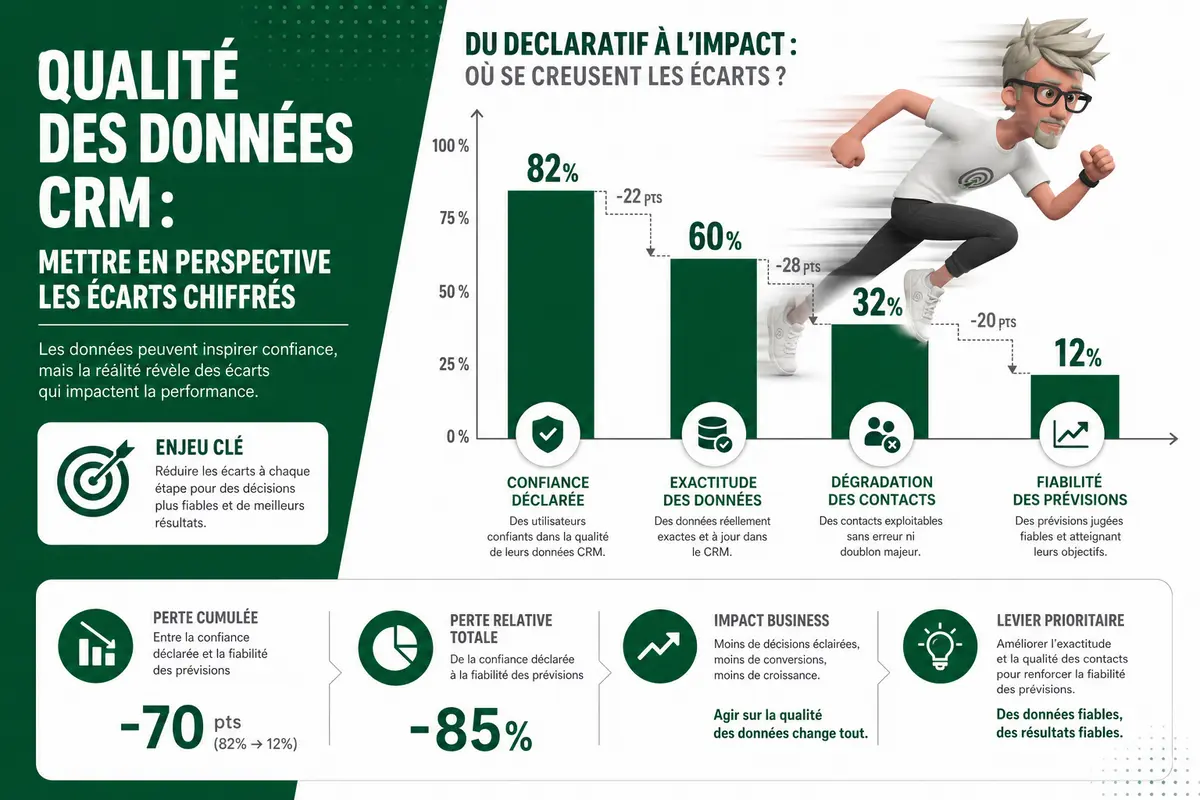
Je vois souvent un écart entre ce que l’équipe croit et ce que les données décrivent. Une affaire peut rester ouverte alors qu’elle est obsolète, apparaître plusieurs fois ou être mal configurée. Le cycle de vente varie aussi d’une affaire à l’autre : une même étape ne signifie pas toujours qu’une vente est au même stade réel.
L’attribution marketing peut être tout aussi fragile. Sans suivi UTM cohérent — des paramètres ajoutés aux liens pour identifier la source d’une visite — il devient difficile de savoir précisément quelle campagne a généré un contact ou une opportunité. Et les données de contact B2B se dégraderaient d’environ 30 % par an. Ce chiffre est une estimation, pas une règle identique pour toutes les bases.
Les indicateurs disponibles méritent donc d’être lus avec prudence. Certaines données indiquent que 73 % des responsables du revenu feraient confiance à leurs données CRM, tandis que des audits indépendants situeraient leur exactitude entre 40 et 60 %. Une étude de Forrester indique que 85 % des entreprises B2B manqueraient leurs prévisions mensuelles de ventes de plus de 5 %. Ces chiffres ne sont pas universels, mais ils montrent que confiance et précision ne sont pas synonymes.
Le problème peut aussi tenir au moment où l’information est recueillie. Le montant d’une affaire, par exemple, peut être demandé trop tard pour éclairer correctement une prévision. Un pipeline fiable dépend donc autant de la qualité des données que de leur fraîcheur et de leur cohérence.
Comment les étapes mal configurées gonflent-elles le pipeline ?
Oui. Des étapes mal configurées peuvent gonfler le pipeline en faisant apparaître des affaires comme plus avancées qu’elles ne le sont réellement. Le problème vient souvent d’une définition différente des étapes entre le marketing et les ventes.
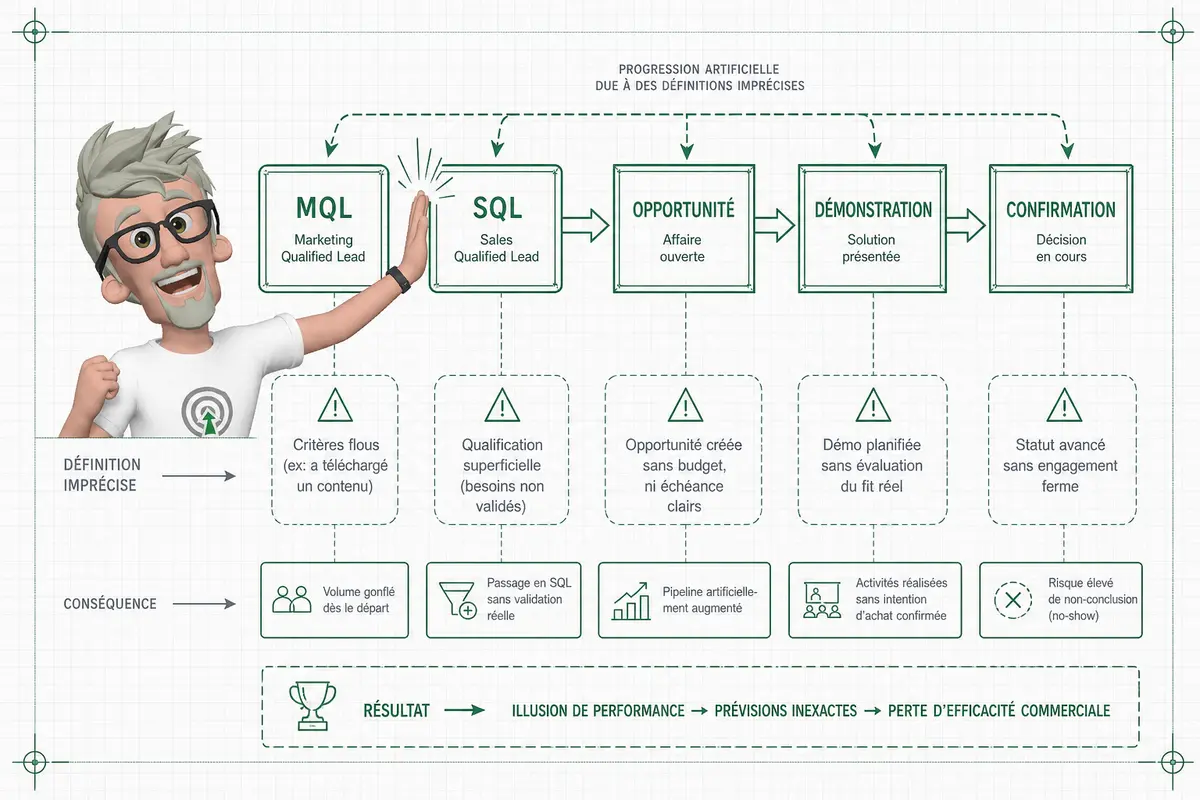
Un MQL, ou prospect qualifié par le marketing, peut désigner une personne qui a montré un intérêt suffisant pour être transmise aux ventes. Un SQL, ou prospect qualifié par les ventes, est généralement jugé assez pertinent pour être suivi par un commercial. Mais les critères varient d’une équipe à l’autre. La même ambiguïté peut toucher le passage en opportunité, puis le statut de client : faut-il une intention, un accord verbal ou un contrat signé ? Sans règles communes, les chiffres ne décrivent pas tous la même réalité.
Le risque apparaît quand une affaire progresse à la suite d’une action du vendeur plutôt qu’en réponse à un comportement confirmé de l’acheteur. Par exemple, si l’étape « démonstration prévue » est atteinte dès l’envoi d’une invitation, le CRM enregistre une avancée avant que le prospect ait confirmé sa présence. Si la démonstration n’a finalement pas lieu, les rapports en aval peuvent tout de même compter cette affaire comme plus mûre qu’elle ne l’est.
J’ai vu ce type de décalage brouiller les prévisions : le pipeline déclaré paraît solide, mais une partie des affaires n’a pas encore franchi les étapes qui rendent leur conclusion plausible. L’écart entre le montant affiché et les revenus réellement susceptibles d’être conclus devient alors difficile à repérer. Le CRM ne ment pas forcément ; il applique les règles qu’on lui a données.
Les informations disponibles détaillent cette première cause, mais elles ne permettent pas de décrire exhaustivement les quatre causes annoncées. Je ne peux donc pas préciser les trois autres sans les inventer.
Votre pipeline reflète-t-il vraiment vos revenus à venir ?
La précision du pipeline indique si les revenus inscrits dans votre CRM sont réellement susceptibles d’être conclus pendant la période visée. Le volume et la couverture ne disent pas si ces données sont fiables, et une prévision ne peut être évaluée qu’après la clôture de la période. Les affaires obsolètes, les étapes mal définies, les informations recueillies trop tard et les données de contact dégradées creusent l’écart entre confiance et réalité. Je commencerais par clarifier les critères de passage entre les étapes et par vérifier régulièrement les données qui alimentent les prévisions. Vous obtenez ainsi une lecture plus crédible du pipeline et une meilleure base pour piloter vos objectifs de revenus.
FAQ
-
Que signifie la précision du pipeline CRM ?
Elle mesure dans quelle mesure la valeur du pipeline enregistrée dans le CRM correspond aux revenus qui devraient réellement être conclus pendant une période donnée. -
Quelle différence entre couverture et précision du pipeline ?
La couverture compare le montant disponible dans le pipeline au quota. La précision indique si ce montant est fiable et susceptible de se transformer en revenus. -
Une couverture élevée garantit-elle l’atteinte du quota ?
Non. Si les affaires sont obsolètes, mal configurées ou avancées sans confirmation de l’acheteur, une couverture élevée peut donner une image trompeuse des revenus attendus. -
Pourquoi les étapes du cycle de vente faussent-elles les prévisions ?
Les équipes peuvent définir différemment les étapes MQL, SQL et opportunité. Faire progresser une affaire à partir d’une action du vendeur, plutôt que d’un comportement confirmé de l’acheteur, peut gonfler les rapports. -
Quand mesure-t-on la précision des prévisions ?
La précision des prévisions s’évalue après la clôture de la période. Elle se distingue de la précision du pipeline, qui porte sur la fiabilité des revenus attendus avant cette clôture.
A propos de l’auteur
Je suis Franck Scandolera, expert en data, analytics et automatisation. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne des entreprises comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor sur leurs enjeux de mesure, de qualité des données et de pilotage. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.