




Claude Code s’automatise avec des slash commands et des skills qui transforment vos routines dev en actions courtes, réutilisables et cadrées. Je vous montre quoi utiliser, où stocker vos instructions, et comment créer une skill new_repo propre sans casser l’existant.
Besoin d'aide ? Découvrez les solutions de notre agence d'agents IA.
À quoi servent les slash commands ?
Une slash command dans Claude Code, c’est un raccourci que je tape directement dans le terminal pour déclencher une action précise. Au lieu de reformuler “reprends le contexte”, “change de modèle”, “nettoie la conversation” ou “reviens avant cette modification”, j’utilise une commande courte. C’est bête, mais dans une journée de dev, ça change beaucoup.
Pour une équipe pressée, l’intérêt est très concret. On réduit les micro-tâches répétitives. On garde un contexte plus lisible. On accélère les revues. On évite aussi les longues conversations qui partent dans tous les sens, surtout quand Claude Code a déjà touché plusieurs fichiers, proposé des corrections, puis ajusté encore derrière.
Les commandes intégrées que j’utilise le plus sont simples à retenir :
- /model Me permet de choisir le modèle utilisé. Utile quand je veux passer sur un modèle plus rapide, ou au contraire plus costaud pour une tâche complexe.
- /rewind Me permet de revenir en arrière dans la conversation. Pratique quand une direction prise par l’agent ne me convient plus.
- /compact Sert à compacter le contexte. En clair, Claude résume ce qui compte pour continuer sans exploser la fenêtre de contexte.
- /clear Nettoie la conversation pour repartir proprement. Je m’en sers quand le sujet a changé ou que le contexte devient pollué.
- /context Affiche ou inspecte le contexte actuel. Très utile pour comprendre ce que Claude “voit” vraiment avant de lui demander une action sensible.
Sur le terrain, je l’ai vu plusieurs fois sur des projets avec beaucoup d’allers-retours entre bugfix, revue de code et refacto. Ce ne sont pas toujours les grosses automatisations qui font gagner le plus de temps. Souvent, ce sont ces petites commandes qui évitent de perdre le fil.
| Commande | Usage | Moment où je m’en sers |
| /model | Choisir le modèle Claude utilisé. | Quand je veux arbitrer entre vitesse, coût et qualité de raisonnement. |
| /rewind | Revenir à un état précédent de la conversation. | Quand une réponse ou une modification part dans la mauvaise direction. |
| /compact | Réduire et résumer le contexte actif. | Quand la session devient longue mais que je veux continuer sans tout perdre. |
| /clear | Effacer la conversation en cours. | Quand je change de sujet ou que je veux repartir sur une base propre. |
| /context | Inspecter le contexte disponible. | Avant une action importante, pour vérifier ce que Claude a en tête. |
C’est quoi une skill Claude Code ?
Une skill Claude Code, c’est simplement un fichier markdown d’instructions que Claude charge dans son contexte quand je l’invoque pour exécuter une tâche précise. Le mot important ici, c’est “contexte”. Claude ne devine pas votre façon de travailler. Il lit la skill, comprend les règles, les contraintes, les étapes attendues, puis il s’en sert pour produire un résultat plus cohérent.
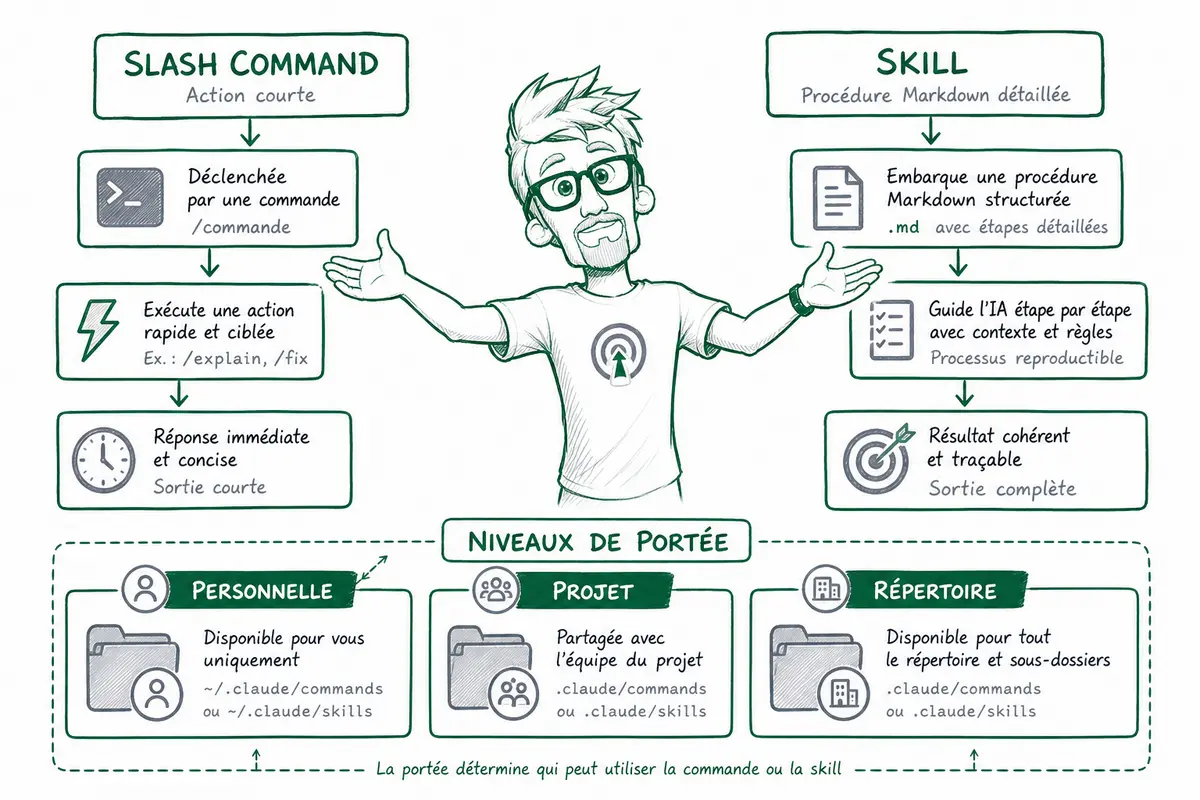
Je fais souvent la différence comme ça : une commande rapide déclenche une action, une skill porte une logique métier ou technique plus riche. Une commande peut dire “prépare une PR”. Une skill peut expliquer comment vous nommez vos branches, comment vous structurez les commits, quels fichiers vérifier, quel format de description utiliser, et quels pièges éviter. Ce n’est pas juste un raccourci, c’est une petite procédure réutilisable.
Dans une skill, on trouve généralement des instructions écrites en markdown. Le markdown, c’est un format texte simple avec des titres, des listes et des blocs faciles à lire. L’utilisateur déclenche la skill quand il en a besoin, puis Claude Code charge ces instructions dans la conversation de travail. Ça permet de garder Claude aligné avec vos conventions sans répéter le même prompt tous les jours.
La portée d’une skill dépend de l’endroit où elle est disponible. La structure exacte et les emplacements peuvent changer selon la version de Claude Code, donc je vérifie toujours la documentation officielle d’Anthropic si je tombe sur un comportement différent. C’est bête, mais ça évite de perdre une heure sur un chemin de dossier qui a changé.
| Type de skill | Quand je l’utilise |
| Personnelle | Pour mes habitudes globales, peu importe le projet. Par exemple mes règles de rédaction, mes préférences Git, mes standards de revue. |
| Projet | Pour les conventions propres à une application. Architecture, stack, commandes de test, règles API, normes frontend ou backend. |
| Répertoire | Pour une zone précise du repo. Par exemple une skill dédiée au dossier backend, une autre au design system, une autre aux scripts data. |
Les bons usages sont très concrets :
- Génération d’une structure de repo propre.
- Application de conventions de code.
- Checklists de pull request.
- Préparation ou mise à jour d’un README.
- Routines backend, frontend, data ou DevOps.
Avant d’écrire une bonne skill, il faut déjà que Claude Code CLI soit installé, lancé correctement, et connecté au bon environnement. Sinon, on construit sur du sable.
Comment installer Claude Code CLI ?
Claude Code CLI s’installe depuis un environnement Node.js récent, puis se lance dans le dossier du projet avec la commande claude. Je préfère l’installer dans un projet de test au début, surtout si je vais ensuite brancher des skills qui peuvent lire, modifier ou générer des fichiers.
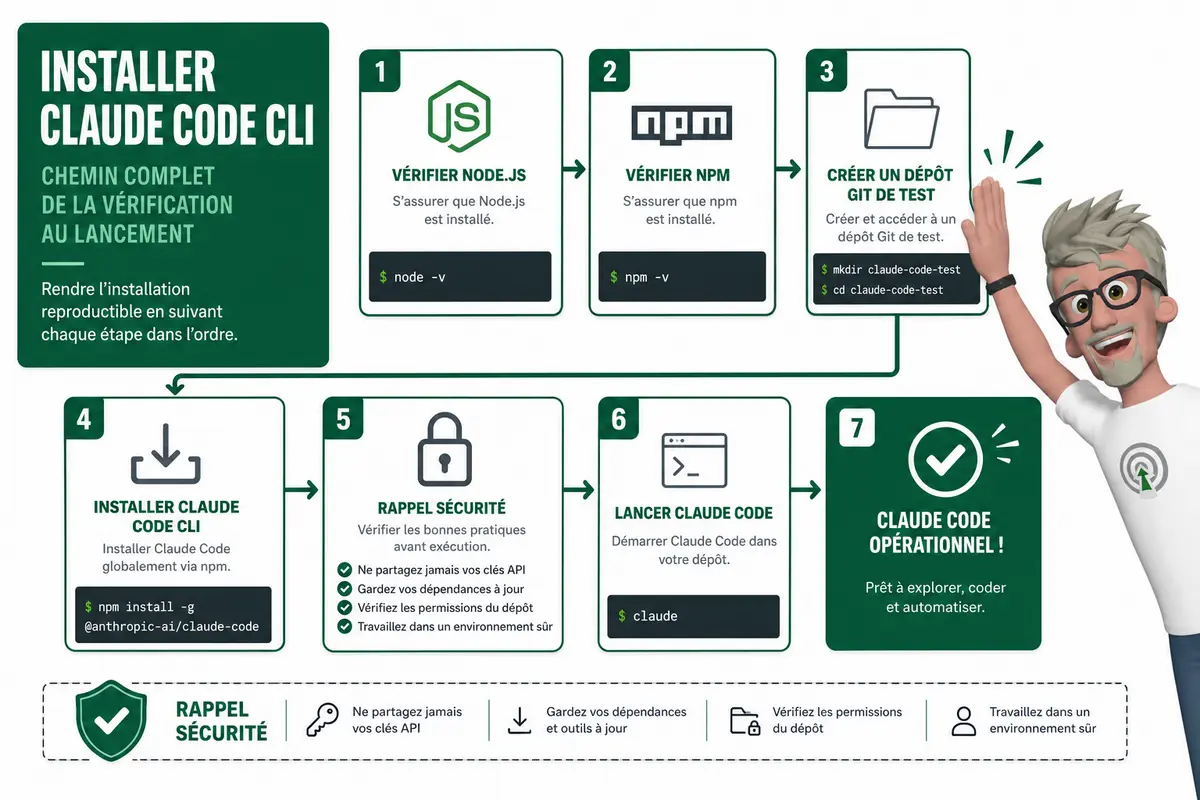
Avant de commencer, je vérifie quatre choses simples : Node.js est installé, npm est disponible, j’ai accès à un terminal, et j’ai un compte Anthropic ou un accès Claude compatible. Idéalement, le projet est aussi versionné avec Git. Ça évite les mauvaises surprises quand une automatisation touche au code.
Je commence par vérifier Node.js et npm. Ces deux commandes servent juste à confirmer que l’environnement JavaScript est prêt.
node --version
npm --version
Si les deux commandes répondent avec un numéro de version, je peux installer Claude Code CLI globalement. L’installation globale permet d’utiliser la commande claude depuis n’importe quel dossier.
npm install -g @anthropic-ai/claude-code
Pour éviter de tester ça dans un vrai projet client ou dans un dossier sensible, je crée un dossier propre. C’est une bonne habitude, surtout quand on commence à automatiser.
mkdir mon-projet-claude
cd mon-projet-claude
git init
mkdir crée le dossier. cd entre dedans. git init initialise un dépôt Git local, ce qui me permet de suivre les changements et de revenir en arrière si besoin.
Une fois dans le bon dossier, je lance Claude Code CLI avec cette commande.
claudeÀ partir de là, Claude travaille dans le contexte du dossier courant. C’est important. Si je suis dans le mauvais dossier, je donne le mauvais contexte à l’outil, et c’est souvent là que les erreurs commencent.
Côté sécurité, je garde trois règles simples. Je teste d’abord dans un dossier sans risque. Je fais un commit avant d’exécuter des automatisations. Et je ne laisse jamais une skill écraser des fichiers sans validation claire. J’ai déjà vu des scripts “pratiques” remplacer des fichiers de config entiers, donc je suis assez strict là-dessus.
| Problème | Cause probable | Solution simple |
| Node absent | Node.js n’est pas installé | Installer une version récente de Node.js, puis relancer le terminal |
| npm non reconnu | npm n’est pas dans le PATH ou Node est mal installé | Réinstaller Node.js avec npm inclus |
| Droits d’installation globaux | Le système bloque npm install -g | Utiliser un gestionnaire de versions comme nvm, ou corriger les droits npm |
| Commande claude introuvable | Le binaire global n’est pas accessible | Relancer le terminal et vérifier le chemin npm global |
| Lancement hors du bon dossier | La commande est exécutée depuis le mauvais répertoire | Utiliser cd pour revenir dans le dossier du projet avant de lancer claude |
Comment créer la skill new_repo ?
La skill new_repo, je la vois comme un garde-fou. Elle doit dire à Claude Code de créer une base propre avec backend/, frontend/ et README.md, mais sans jamais écraser ce qui existe déjà. C’est le point important. On crée, on vérifie, on demande confirmation s’il y a conflit. On ne supprime rien.
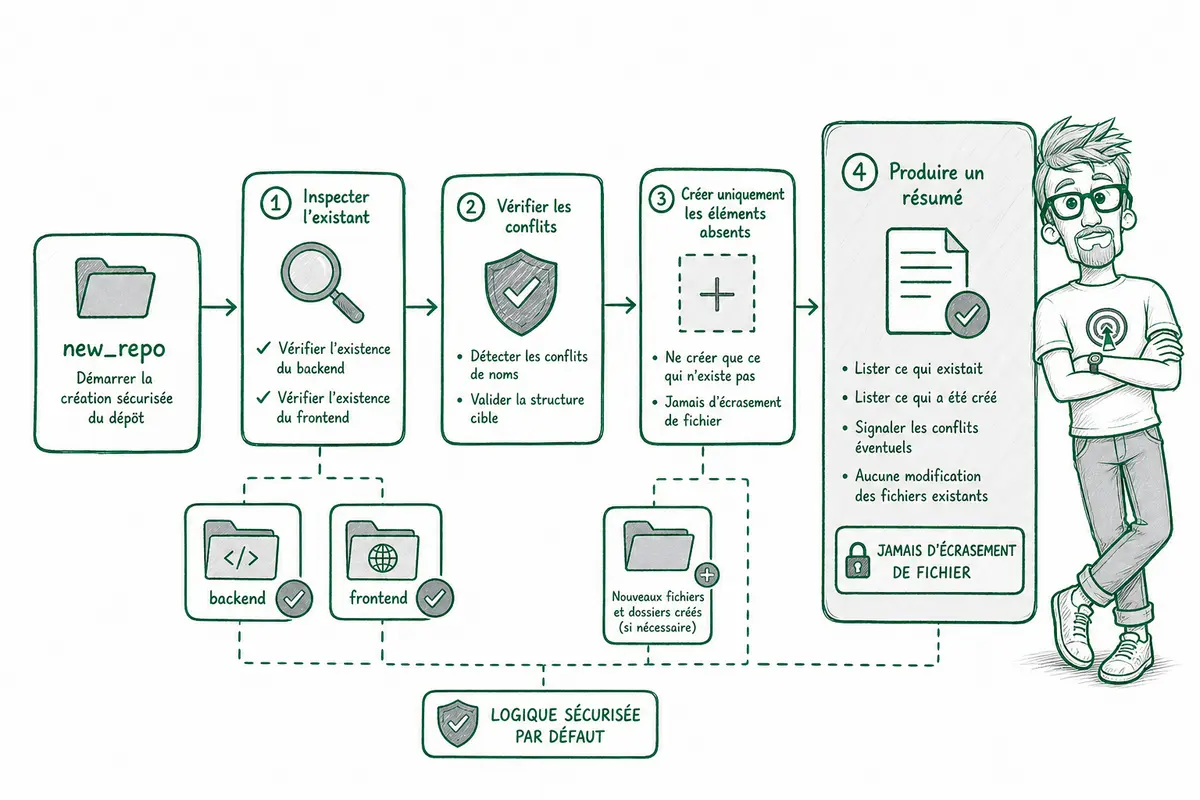
Pour tester ça proprement, je pars d’un dépôt vide.
mkdir claude-new-repo-demo
cd claude-new-repo-demo
git init

mkdir -p .claude/skills
touch .claude/skills/new_repo.md
Dans un projet Claude Code, j’utilise l’emplacement .claude/skills/. Si votre environnement Claude Code a une convention différente, gardez la même idée : une skill projet, versionnée avec le dépôt.
Voici le contenu complet que je mets dans .claude/skills/new_repo.md.
# Skill: new_repo

## Objectif

Créer une base de dépôt propre avec cette structure :

- backend/
- frontend/
- README.md

La skill doit préparer le projet sans écraser, supprimer ou remplacer un fichier ou dossier existant.

## Règles strictes

- Ne jamais supprimer de fichier.
- Ne jamais remplacer un fichier existant.
- Ne jamais modifier README.md s’il existe déjà.
- Vérifier l’existence de backend/, frontend/ et README.md avant toute création.
- Si un élément existe déjà, le conserver tel quel.
- Si un conflit est détecté, demander confirmation avant toute action.
- Afficher clairement ce qui a été créé et ce qui existait déjà.

## Étapes d’exécution

1. Inspecter le dossier courant.
2. Vérifier si backend/ existe.
3. Vérifier si frontend/ existe.
4. Vérifier si README.md existe.
5. Créer uniquement les éléments manquants.
6. Ne jamais toucher aux éléments existants.
7. Afficher un résumé final.

## Structure attendue

backend/
frontend/
README.md

## Contenu README.md si le fichier n’existe pas

# Nouveau projet

Structure initiale générée avec Claude Code.

## Dossiers

- backend/ : code serveur, API, logique métier
- frontend/ : interface utilisateur

## Contrôle anti-écrasement

Avant chaque création, vérifier avec un test d’existence.

Si README.md existe déjà, ne pas le modifier.

Si backend/ ou frontend/ existent déjà, ne pas les recréer.

## Message final attendu

Base de dépôt vérifiée.

Créé :
- Liste des éléments créés

Déjà présent :
- Liste des éléments existants

Aucun fichier existant n’a été écrasé.
Pour valider la logique hors Claude Code, je garde aussi une variante shell. C’est utile quand je veux tester le comportement avant de confier ça à l’agent.
#!/usr/bin/env bash

# Arrête le script si une commande échoue
set -e

# Crée backend/ seulement s’il n’existe pas déjà
mkdir -p backend

# Crée frontend/ seulement s’il n’existe pas déjà
mkdir -p frontend

# Vérifie si README.md existe déjà
if test -e README.md; then
  # Ne touche pas au fichier existant
  echo "README.md existe déjà, aucune modification."
else
  # Crée README.md uniquement s’il est absent
  cat > README.md <<'EOF'
# Nouveau projet

Structure initiale générée de façon sécurisée.

## Dossiers

- backend/ : code serveur, API, logique métier
- frontend/ : interface utilisateur
EOF
  echo "README.md créé."
fi

# Résumé simple
echo "Structure vérifiée sans écrasement."
Ma checklist de validation est simple :
- Lancer la skill new_repo avec Claude Code.
- Vérifier que backend/, frontend/ et README.md existent.
- Relancer la skill pour confirmer qu’elle n’écrase rien.
- Faire un git status pour voir exactement ce qui a été créé.
Comment éviter les automatisations dangereuses ?
On évite les automatisations dangereuses en imposant des garde-fous dans les instructions, pas en faisant confiance à une phrase vague du style “fais attention”.
Avec Claude Code et les skills, le risque n’est pas théorique. Un agent peut écraser un fichier utile, créer une structure de projet incohérente, modifier trop de choses d’un coup, ou partir dans la mauvaise direction parce que l’instruction était ambiguë. Le cas classique, c’est l’automatisation lancée dans le mauvais dossier. Là, même une bonne skill peut faire des dégâts.
Ma règle simple : je traite Claude comme un développeur rapide, pas comme un magicien infaillible. Je lui donne un cadre clair avant de le laisser modifier quoi que ce soit.
Dans mes consignes, je mets toujours quelques règles très explicites :
- Travailler sur Git, avec un commit propre avant une grosse modification.
- Vérifier git status avant et après l’exécution.
- Demander à Claude de lister son plan avant toute modification.
- Interdire explicitement la suppression de fichiers sans validation.
- Interdire explicitement l’écrasement d’un fichier existant sans me prévenir.
- Limiter le périmètre à un dossier ou à une liste de fichiers.
J’utilise aussi les commandes de contexte. /context me sert à comprendre ce que Claude voit réellement. C’est bête, mais ça évite beaucoup d’erreurs. Si le contexte devient trop lourd, j’utilise /compact pour résumer et repartir avec quelque chose de plus propre. Si la conversation est partie dans tous les sens, je préfère faire /clear et recommencer. Ça prend trente secondes, et ça évite une heure de nettoyage.
Chez des clients, je vois toujours la même chose. Les vrais gains viennent rarement d’une grosse automatisation magique qui fait tout. Ils viennent de petites routines fiables, répétables, bien cadrées. Une skill qui prépare un plan, modifie trois fichiers précis, lance les tests, puis s’arrête, c’est souvent beaucoup plus rentable qu’un agent qui “refactorise tout le projet”.
| Problème | Garde-fou | Commande ou pratique |
| Automatisation lancée au mauvais endroit | Vérifier le dossier courant avant action | pwd et git status |
| Écrasement de fichiers | Interdire l’écrasement sans validation | Instruction explicite dans la skill |
| Suppression accidentelle | Demander confirmation avant suppression | Règle écrite dans les instructions |
| Contexte trop chargé | Réduire et clarifier le contexte | /compact |
| Claude ne voit pas les bons éléments | Contrôler son contexte réel | /context |
| Conversation confuse | Repartir proprement | /clear |
Et si vos routines dev devenaient enfin réutilisables ?
Claude Code devient vraiment utile quand je ne lui demande plus seulement d’aider au coup par coup, mais quand je lui confie des routines propres. Les slash commands servent à piloter vite. Les skills servent à cadrer une tâche avec des règles claires. Avec une skill comme new_repo, on peut générer une base backend, frontend et README sans écraser l’existant, à condition de poser les bons garde-fous. Mon conseil reste simple : commencez petit, testez dans un repo dédié, versionnez tout. Le bénéfice pour vous, c’est moins de répétition, moins d’erreurs, et un workflow dev plus stable.
FAQ
- Claude Code sert à quoi pour un développeur ?
Claude Code aide à travailler dans le terminal avec un assistant IA capable de comprendre un projet, proposer des modifications, exécuter des tâches guidées et accélérer les routines de développement. Son intérêt augmente quand on structure les demandes avec des commandes et des skills. - Quelle différence entre slash command et skill ?
Une slash command déclenche vite une action ou une fonction. Une skill contient des instructions plus détaillées, souvent dans un fichier markdown, pour cadrer une tâche précise. Je vois ça comme la différence entre un raccourci et une procédure réutilisable. - La skill new_repo peut-elle écraser mes fichiers ?
Elle ne doit pas le faire si elle est bien écrite. Il faut indiquer explicitement de vérifier l’existence de backend/, frontend/ et README.md, de ne rien remplacer, et de demander confirmation en cas de conflit. Je conseille aussi de tester dans un repo Git propre. - Faut-il savoir coder pour utiliser les skills Claude Code ?
Il faut au minimum comprendre la structure d’un projet et savoir lire des instructions markdown. Pour des automatisations de développement, savoir utiliser le terminal, Git et quelques commandes shell reste franchement préférable. - Quelles commandes Claude Code utiliser au quotidien ?
Les plus pratiques sont /model pour choisir le modèle, /context pour voir ce que Claude prend en compte, /compact pour alléger une conversation longue, /clear pour repartir proprement et /rewind pour revenir en arrière quand une direction ne convient pas.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent rendre leurs workflows plus fiables, plus mesurables et moins dépendants des tâches manuelles. J’interviens via l’agence webAnalyste et l’organisme Formations Analytics, avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez structurer vos automatisations IA ou vos process data, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.