




Je choisis selon le problème à résoudre. Si je dois comprendre ce que disent les données, je prends un analyste data. Si je dois construire un système fiable, je prends un ingénieur logiciel. Le vrai sujet, c’est d’éviter le mauvais recrutement au mauvais moment.
Quel problème voulez-vous résoudre ?
Le bon choix dépend du travail attendu, pas des outils utilisés.
Je vois souvent la confusion venir du même endroit : l’analyste data et l’ingénieur logiciel manipulent parfois les mêmes briques. Du code. Des bases de données. Des APIs, c’est-à-dire des points d’échange entre logiciels. Des tableaux de bord. Des pipelines, donc des chaînes automatisées qui déplacent ou transforment des données. Mais ils ne résolvent pas le même problème.
Quand le besoin est de comprendre pourquoi le chiffre d’affaires baisse, d’identifier un comportement utilisateur, de mesurer l’effet d’une campagne marketing ou d’aider une direction à prendre une décision, on est sur un problème d’analyse. Le sujet, c’est le sens. La question derrière la question. Ce que les données racontent vraiment.
Quand le besoin est de créer une application, de stabiliser une infrastructure, d’automatiser un flux critique, de gérer la montée en charge ou de fiabiliser le stockage des données, on est sur un problème d’ingénierie logicielle. Là, le sujet, c’est la robustesse. La production. Le système qui doit tourner tous les jours sans casser.
J’ai souvent vu des entreprises recruter un profil trop technique pour une question business. Le résultat ? Beaucoup de complexité, peu de décisions utiles. J’ai aussi vu l’inverse : un analyste brillant à qui on demande de maintenir une architecture de production. Là aussi, ça finit en frustration, parce que ce n’est pas le même métier.
Besoin réel | Profil prioritaire | Signe d’alerte |
Comprendre une baisse de chiffre d’affaires ou expliquer une tendance. | Analyste data. | Vous parlez surtout de décisions, mais vous recrutez quelqu’un pour construire une plateforme. |
Mesurer l’impact d’une campagne, d’un produit ou d’un changement de prix. | Analyste data. | Vous avez des données, mais personne ne sait transformer ça en recommandation claire. |
Créer une application, une API ou un service utilisé par des clients ou des équipes. | Ingénieur logiciel. | Vous demandez à un analyste de gérer des erreurs, des déploiements et de la sécurité en production. |
Automatiser un flux critique ou fiabiliser un stockage de données. | Ingénieur logiciel. | Votre priorité est la stabilité, mais vous cherchez surtout quelqu’un qui fait de beaux dashboards. |
Que fait vraiment un analyste data ?
Un analyste data transforme des données existantes en réponses business utilisables. C’est vraiment ça le cœur du métier. Pas “faire des graphiques”. Les graphiques sont juste une façon de rendre visible ce qu’il a compris, ou ce qu’il veut faire comprendre.
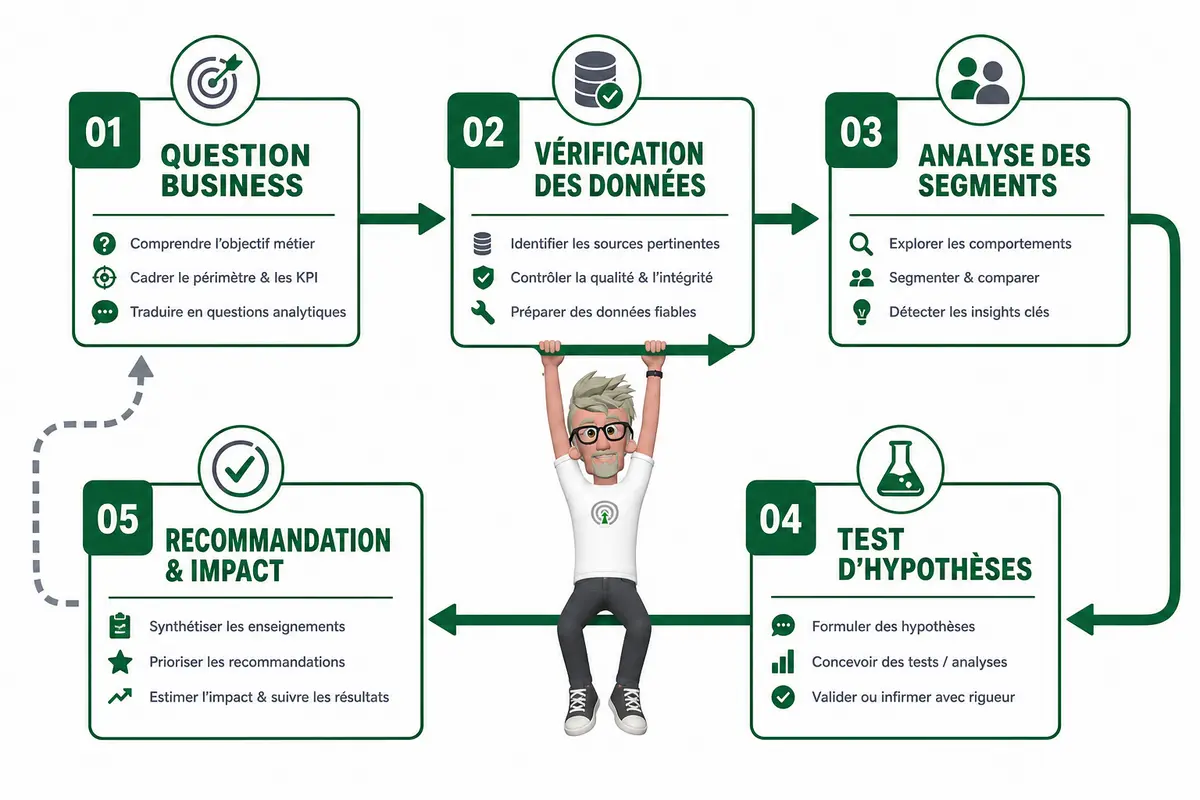
Dans la vraie vie, il part rarement d’un cahier des charges parfaitement propre. On lui dit plutôt : “Le taux de conversion baisse, vous pouvez regarder ?” Et là, il enquête. Il formule la bonne question, vérifie si les données sont fiables, regarde les tendances, compare des segments, mesure les écarts, teste des hypothèses, puis produit une recommandation exploitable.
Un bon analyste data ne cherche pas seulement une corrélation visible. Il cherche une cause probable. Il sait que deux courbes qui bougent ensemble ne veulent pas forcément dire qu’une chose provoque l’autre. C’est là que le raisonnement statistique compte. Une tendance peut exister, mais être trop faible pour décider. Une différence peut sembler énorme, mais venir d’un échantillon trop petit. Et parfois, il faut avoir l’honnêteté de dire : “Les données ne permettent pas de conclure.” C’est frustrant, mais c’est souvent ce qui évite une mauvaise décision.
Je l’ai vu chez un client e-commerce. Tout le monde pensait que la baisse des ventes venait des campagnes marketing. En regardant les données par appareil, par navigateur et par étape du tunnel, on a trouvé un bug sur mobile au moment du paiement. Le marketing n’était pas le problème. Le reporting global cachait l’anomalie.
Les cas classiques ressemblent souvent à ça :
- Analyser pourquoi un taux de conversion baisse.
- Comprendre quels clients se désabonnent et à quel moment.
- Identifier les canaux marketing vraiment rentables.
- Suivre la performance commerciale par équipe, produit ou région.
- Repérer une anomalie dans un reporting mensuel.
SQL, Python, R, les outils de BI comme Power BI ou Tableau, et même les tableurs restent des moyens. SQL sert à interroger une base de données. La BI sert à construire des tableaux de bord. Python ou R servent à analyser, nettoyer ou automatiser. Mais le métier, ce n’est pas l’outil. Le métier, c’est la décision basée sur des preuves.
Petite nuance terrain : un bon analyste peut bricoler un script, automatiser un reporting, connecter deux outils. Ça aide beaucoup. Mais ce n’est pas forcément la bonne personne pour concevoir un système critique, robuste, maintenable pendant cinq ans. Là, on entre davantage dans le métier d’ingénieur logiciel ou data engineer.
Ses livrables typiques sont assez concrets :
- Une analyse claire avec des conclusions défendables.
- Un dashboard fiable pour suivre des indicateurs.
- Une note de recommandation orientée décision.
- Une segmentation clients ou produits.
- Un modèle descriptif pour comprendre un phénomène.
- Des indicateurs propres, documentés et utilisables par les équipes.
Que construit un ingénieur logiciel ?
Un ingénieur logiciel conçoit, développe et maintient des systèmes qui doivent fonctionner dans la durée. Son problème principal, ce n’est pas seulement de répondre à une question. C’est de créer quelque chose de fiable, testable, sécurisé, évolutif et maintenable. Bref, un mécanisme qui tient quand il y a des utilisateurs, des bugs, des pics de charge, des changements métier et des nuits où personne n’a envie d’être réveillé.
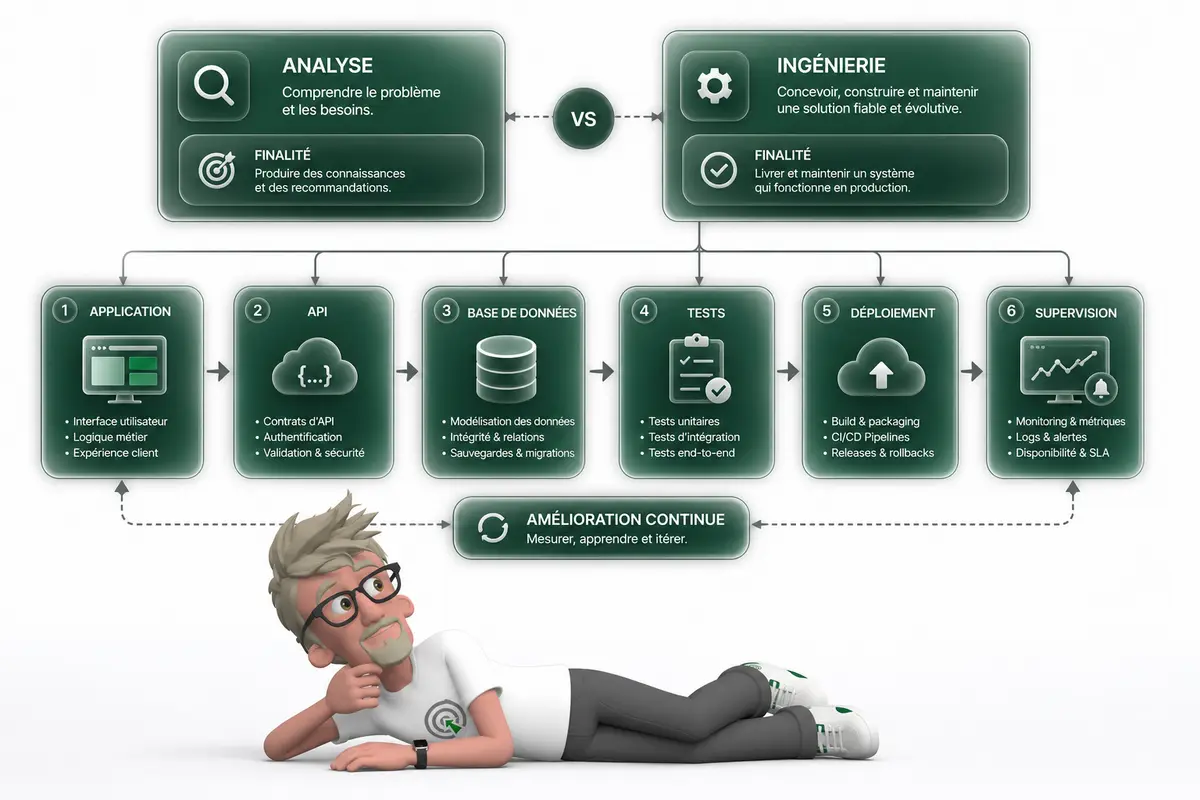
Dans son quotidien, il touche à beaucoup de sujets très concrets :
- Architecture applicative : Choisir comment les composants d’une application communiquent entre eux.
- Backend : Développer la partie serveur, celle qui gère la logique métier, les règles, les traitements.
- Frontend : Construire l’interface utilisée par les clients ou les équipes internes.
- APIs : Créer des points d’entrée pour permettre à des systèmes de s’échanger des données.
- Bases de données : Stocker, organiser et récupérer les informations correctement.
- Tests : Vérifier automatiquement que le système fait bien ce qu’il doit faire.
- Déploiement : Mettre le code en production sans tout casser.
- Observabilité : Suivre les logs, les métriques et les alertes pour comprendre ce qui se passe.
- Sécurité : Protéger les accès, les données et les usages sensibles.
- Performance : Faire en sorte que l’application réponde vite, même quand le volume augmente.
Le lien avec la data est partout. Un ingénieur logiciel peut produire des données, les transporter, les transformer ou les stocker. Mais son objectif reste le système qui rend tout ça possible. Par exemple, construire une plateforme de collecte d’événements, créer une API de paiement, développer un outil interne, industrialiser un pipeline, gérer des droits d’accès, rendre une application plus rapide, ou éviter qu’un traitement casse en production.
J’ai vu ce flou souvent chez des clients. On appelle parfois ingénieur data ou développeur data des profils entre les deux mondes. Ce n’est pas un problème. La bonne question reste simple : Est-ce qu’on attend une investigation, ou est-ce qu’on attend un système ? Ce n’est pas du tout le même métier.
| Critère | Analyste data | Ingénieur logiciel |
| Objectif | Comprendre, expliquer, aider à décider. | Construire un système qui fonctionne durablement. |
| Résultat attendu | Analyse, dashboard, recommandation, insight. | Application, API, service, pipeline, outil fiable. |
| Temporalité | Souvent ponctuelle ou liée à un cycle business. | Long terme, avec maintenance et évolution. |
| Risque principal | Mauvaise interprétation des données. | Système instable, lent, non sécurisé ou impossible à maintenir. |
Pourquoi les deux rôles sont confondus ?
Les deux rôles sont confondus parce qu’ils partagent des outils, pas parce qu’ils font le même métier. C’est le piège classique. Quand je vois SQL, Python, Git, des notebooks, un entrepôt de données, des APIs et du cloud dans les deux fiches de poste, je comprends pourquoi tout le monde mélange. Mais utiliser les mêmes outils ne veut pas dire produire la même valeur.
Un analyste data cherche surtout à comprendre ce qui se passe et à aider une décision. Un ingénieur logiciel construit un système fiable, maintenable, qui tourne dans la durée. Entre les deux, il y a des zones communes, bien sûr. Mais la finalité n’est pas la même.
Le vrai problème, c’est la fiche de poste fourre-tout. On demande à une seule personne de produire des analyses business, maintenir des pipelines de données, créer des dashboards, développer des modèles, brancher des APIs et gérer l’infrastructure cloud. Sur le papier, ça paraît pratique. Dans la vraie vie, c’est souvent un poste impossible. J’ai déjà vu des profils très bons se faire juger moyens juste parce que le rôle n’avait jamais été cadré correctement.
Les conséquences arrivent vite :
- Les attentes deviennent floues.
- Les priorités se contredisent entre urgence business et stabilité technique.
- Le code devient fragile parce qu’il est écrit dans l’urgence.
- Les analyses prennent trop de temps parce que les données cassent tout le temps.
- La dette technique s’accumule dans les scripts, les dashboards et les flux.
- Les équipes business reprochent à la tech d’être lente, et la tech reproche au business de changer d’avis.
Ce n’est pas forcément un problème de compétence individuelle. C’est souvent un problème de cadrage. On a mélangé comprendre, construire, maintenir et industrialiser dans le même sac.
Il y a quelques signaux qui ne trompent pas. On demande une analyse urgente, mais la personne passe ses journées à réparer des flux. On veut un système stable, mais on recrute quelqu’un évalué surtout sur Power BI. On cherche des recommandations business, mais la fiche parle surtout de Kubernetes, un outil pour déployer et gérer des applications en production. On veut un outil fiable, mais personne ne parle de tests, de supervision ou de maintenance.
Avant de recruter, je poserais toujours ces questions simples :
- Est-ce qu’on veut comprendre ou construire ?
- Est-ce que le résultat doit éclairer une décision ou tourner en production ?
- Est-ce que le risque principal est une mauvaise interprétation ou une panne système ?
- Qui maintient le livrable après livraison ?
Comment cadrer le bon recrutement ?
Je cadre le recrutement en décrivant le problème réel avant de décrire les outils. Sinon, on finit avec une fiche de poste qui demande SQL, Python, Airflow, Power BI, React, Docker et “un bon sens business”, sans savoir ce que la personne doit vraiment produire.
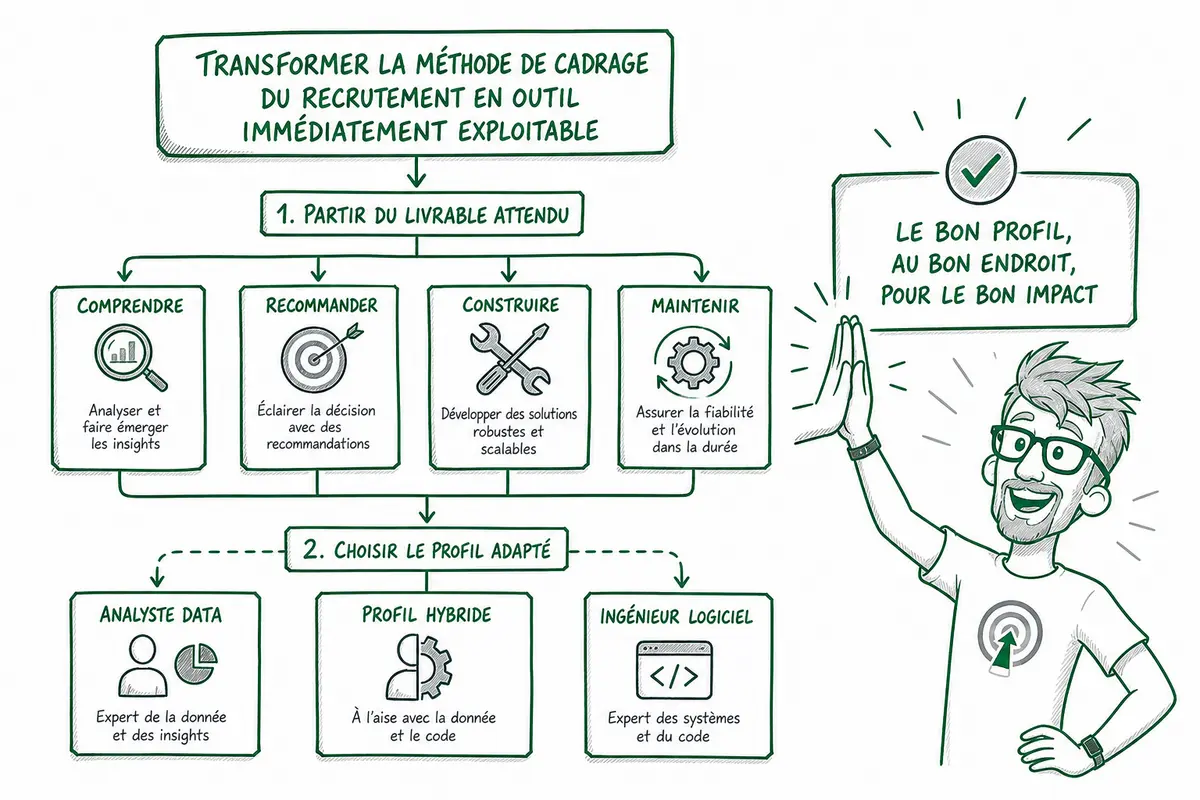
La fiche de poste doit partir des décisions à prendre, des systèmes à construire, des contraintes de production et des livrables attendus. Pas d’une liste d’outils empilés. J’ai déjà vu des équipes chercher un “data analyst senior” alors que le vrai besoin était de fiabiliser un pipeline quotidien qui cassait tous les lundis matin. Là, ce n’est pas un problème d’analyse. C’est un problème d’ingénierie.
Je garde une méthode simple. J’écris le problème en une phrase. Je définis le résultat attendu. J’identifie le risque principal. Je précise qui utilisera le livrable. Je précise aussi qui le maintiendra. Cette dernière question évite beaucoup d’erreurs, parce qu’un tableau de bord bricolé pour une réunion et une API utilisée par des clients tous les jours n’ont pas du tout les mêmes exigences.
Si le livrable principal est une recommandation, un diagnostic, une mesure ou une lecture business, je m’oriente vers un analyste data. Si le livrable principal est un service, une application, une API, un pipeline robuste ou une architecture maintenable, je m’oriente vers un ingénieur logiciel.
Les profils hybrides existent, et ils sont précieux, surtout dans les petites équipes. Mais je reste lucide. Un profil hybride ne remplace pas durablement deux métiers si les enjeux sont forts des deux côtés. Je peux demander de la polyvalence, oui. Mais je dois choisir la priorité. Sinon, je recrute quelqu’un qui sera moyen partout, frustré rapidement, et mal évalué parce que le besoin n’était pas clair dès le départ.
| Situation | Profil le plus adapté | Pourquoi |
| Question business floue | Analyste data | Il sait clarifier la demande, formuler les bonnes hypothèses et transformer le flou en décision. |
| Reporting fiable | Analyste data | Il construit des indicateurs lisibles, cohérents et utiles aux équipes métier. |
| Analyse exploratoire | Analyste data | Il cherche les signaux, teste les pistes et explique ce que les données racontent. |
| Pipeline critique | Ingénieur logiciel | Il pense robustesse, tests, supervision et reprise en cas d’échec. |
| Application interne | Ingénieur logiciel | Il construit un outil maintenable, utilisable et intégré au système existant. |
| API client | Ingénieur logiciel | Il gère la performance, la sécurité, les contrats d’interface et la stabilité. |
| Architecture de données | Ingénieur logiciel | Il conçoit des fondations solides pour faire circuler et maintenir les données. |
| Automatisation ponctuelle | Profil hybride | Il peut aller vite si le risque est faible et que le besoin reste limité. |
Quand je cadre comme ça, le recrutement devient plus simple. Il y a moins de frictions, moins de mauvais recrutements, et surtout plus de clarté dans l’équipe. Chacun sait pourquoi la personne arrive, ce qu’elle doit livrer, et sur quoi elle sera vraiment attendue.
Vous avez besoin de comprendre ou de construire ?
Je résume simplement : un analyste data aide à comprendre une situation avec des données existantes et à prendre une meilleure décision. Un ingénieur logiciel construit les systèmes qui doivent fonctionner, durer et supporter la charge. Les deux peuvent coder, manipuler des bases et travailler sur les mêmes plateformes, mais leur logique n’est pas la même.
Avant de recruter, je regarde donc le problème réel. Est-ce une enquête business ou un produit technique à maintenir ? Ce cadrage évite les fiches de poste impossibles, les tensions et les livrables bancals. Le bénéfice pour vous, c’est une équipe plus claire, plus efficace, avec les bonnes compétences au bon endroit.
FAQ
- Quelle est la différence simple entre un analyste data et un ingénieur logiciel ?
Un analyste data cherche à comprendre ce que les données racontent pour aider à décider. Un ingénieur logiciel construit les systèmes qui collectent, traitent, stockent ou exposent ces données. Les outils peuvent se croiser, mais l’objectif n’est pas le même. - Un analyste data doit-il savoir coder ?
Souvent oui, au moins avec SQL et parfois Python ou R. Mais le code reste un moyen. Ce qui compte le plus, c’est sa capacité à poser les bonnes questions, vérifier les données, interpréter correctement les résultats et formuler une recommandation claire. - Un ingénieur logiciel peut-il faire de l’analyse de données ?
Il peut produire des analyses, surtout s’il est à l’aise avec les données. Mais son cœur de métier reste la conception de systèmes fiables. Si le besoin principal est une investigation business, un analyste data sera souvent plus adapté. - Pourquoi les fiches de poste data sont-elles souvent confuses ?
Parce qu’elles mélangent des besoins différents : analyse, BI, automatisation, data engineering, développement logiciel, parfois même IA. Le résultat, c’est une liste d’outils au lieu d’un vrai problème à résoudre. C’est là que les recrutements dérapent. - Comment savoir quel profil recruter en premier ?
Je regarde le livrable attendu. Si vous avez besoin d’un diagnostic, d’une mesure, d’un dashboard ou d’une recommandation business, commencez par un analyste data. Si vous avez besoin d’une application, d’une API, d’un pipeline robuste ou d’une infrastructure maintenable, commencez par un ingénieur logiciel.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui doivent mieux structurer leurs données, leurs outils et leurs décisions, avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor.
Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez cadrer vos besoins data, automatisation ou IA sans recruter à côté du sujet, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.