




Ils valent surtout le test si votre sujet, c’est le coût API. Sol vise les tâches exigeantes moins chères, Luna les gros volumes. Je détaille ce qu’on peut vraiment attendre, où les benchmarks aident, et les points à vérifier avant de les mettre dans vos agents.
Besoin d'aide ? Découvrez les solutions de notre agence Openai GPT.
À quoi servent Sol et Luna ?
Sol et Luna servent à rapprocher les usages business d’un niveau de modèle avancé, sans payer le prix d’un modèle premium à chaque appel.
GPT-6 Sol, je le vois comme le choix intermédiaire. C’est le modèle qu’on va regarder quand la tâche demande du raisonnement, de la synthèse, une bonne compréhension du contexte, mais qu’on ne veut pas envoyer chaque requête vers le modèle le plus cher. Typiquement, ça peut être utile pour analyser des tickets clients, produire des réponses structurées, qualifier des leads, résumer des documents ou aider un agent IA à prendre une décision simple.
GPT-6 Luna, lui, est plus orienté volume. Quand vous avez beaucoup d’appels API, le coût devient vite le vrai sujet. Une API, c’est juste une interface qui permet à votre logiciel d’appeler le modèle automatiquement. Et quand cette API tourne des milliers ou des millions de fois, quelques centimes d’écart finissent par peser lourd. Luna est donc pensé pour les tâches répétitives, les traitements courts, les classifications simples, les extractions basiques ou les automatisations où la vitesse et le prix comptent plus que la finesse maximale.
L’objectif annoncé n’est pas de battre tous les meilleurs modèles du marché. L’idée, c’est plutôt d’obtenir une performance proche d’un modèle plus haut de gamme, pour une fraction du coût. Je resterais quand même prudent. La vraie valeur dépend du cas d’usage, des prompts, du contexte fourni, de la longueur des échanges et surtout du niveau d’erreur que votre métier peut accepter.
Dans les projets data, IA et automatisation que je vois passer, le sujet n’est pas seulement le meilleur modèle. C’est souvent le bon modèle au bon endroit. Un modèle très cher utilisé partout finit par tuer le ROI. Alors qu’un modèle moins cher, bien routé, peut faire le job sur 70 à 90 % des tâches simples ou répétitives. Et on garde le modèle premium pour les cas vraiment sensibles.
| Modèle | Usage naturel | Vigilance |
| GPT-6 Sol | Tâches exigeantes à coût contrôlé. | Nécessité de tester la précision sur vos vrais cas. |
| GPT-6 Luna | Gros volumes, traitements répétitifs, automatisations simples. | Nécessité de surveiller les cas complexes. |
| GPT-6 Astra | Référence haut de gamme pour les tâches critiques. | Coût plus élevé, à réserver aux usages où la qualité justifie le prix. |
Que changent les coûts API ?
La baisse des coûts API change surtout la manière de concevoir les agents, parce qu’on peut multiplier les appels utiles sans rendre le système économiquement absurde.
Une API, c’est juste la porte d’entrée technique qui permet à votre application d’appeler un modèle comme GPT-6 Sol ou Luna. Quand ce coût baisse, je peux réfléchir autrement. Je ne suis plus obligé de tout faire en un seul gros prompt fragile. Je peux découper le travail.
Dans une entreprise, ça change des cas très concrets. L’analyse de tickets support devient plus réaliste à grande échelle. La qualification de leads aussi, avec un agent qui lit une demande, extrait les infos importantes, estime l’urgence, puis propose une action. Même chose pour l’extraction d’informations dans des contrats, le résumé de documents, le contrôle qualité de contenus, les assistants internes ou les workflows automatisés.
Le vrai sujet, ce n’est pas juste “le modèle est moins cher”. C’est plutôt “je peux faire travailler l’IA en plusieurs étapes sans exploser le budget”. Un agent IA, c’est rarement une seule réponse magique. Il lit, compare, reformule, appelle des outils, vérifie, puis répond. Chaque étape peut consommer des tokens, donc du coût.
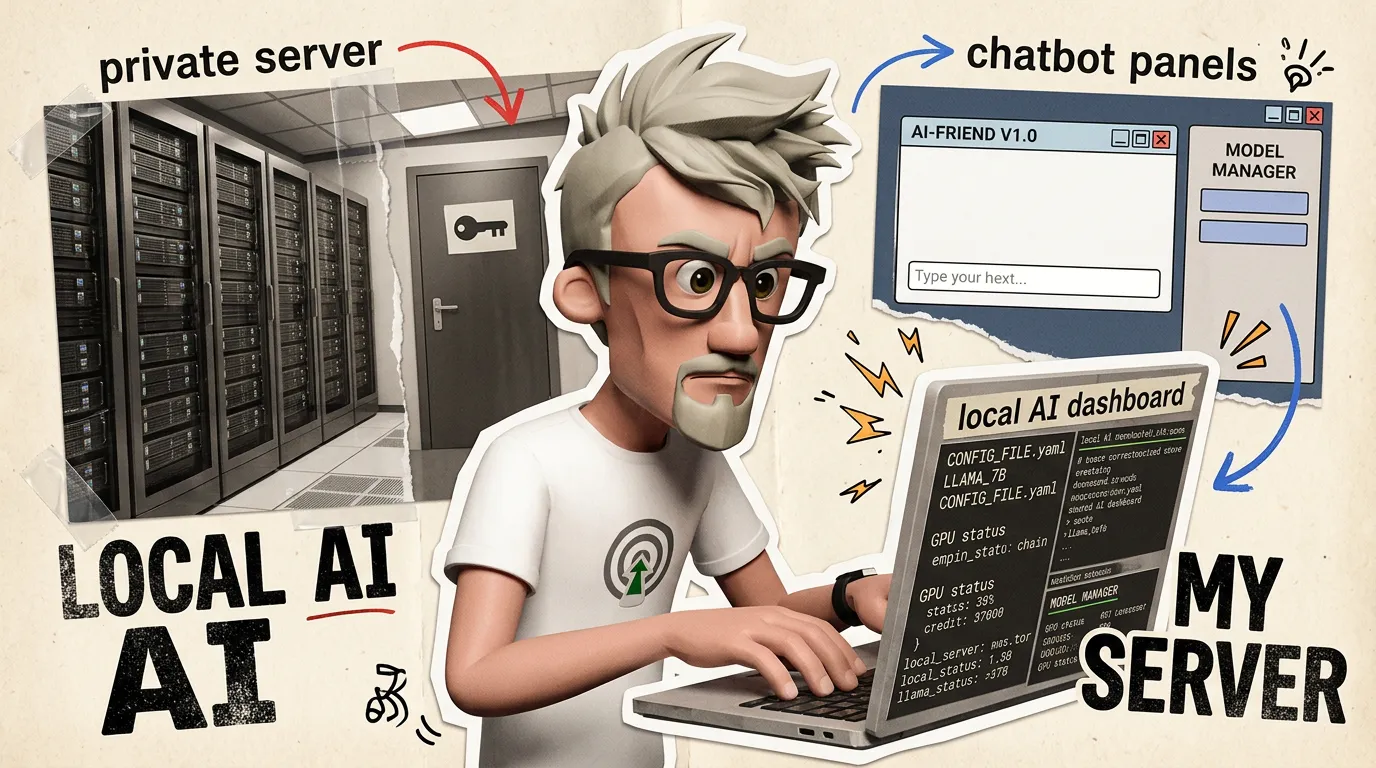
Le cache devient important ici. Un cache, c’est une mémoire temporaire qui évite de retraiter inutilement la même chose. Si l’agent réutilise les mêmes instructions, le même contexte client, les mêmes règles métier ou des informations déjà vues, un bon cache peut réduire les appels redondants. À volume élevé, chaque économie compte. J’ai vu des systèmes où le vrai problème n’était pas le prix du modèle, mais le fait qu’on lui faisait relire 40 fois la même documentation.
Mais soyons honnêtes. Le cache ne sauve pas un mauvais design. Si l’agent relit trop de contexte, si les prompts sont trop longs, ou si on appelle le modèle pour une tâche qu’une règle simple pourrait traiter, le budget part quand même trop vite.
Pour évaluer Sol, Luna et un modèle premium, je regarderais surtout le coût par tâche terminée, le taux d’erreur, le temps gagné, le taux de reprise humaine et la satisfaction utilisateur. Et je comparerais les trois sur les mêmes prompts, les mêmes données, les mêmes cas réels. Sinon, la comparaison ne vaut pas grand-chose.
| Levier | Impact sur les coûts |
| Choix du modèle | Utiliser Sol, Luna ou un modèle premium selon la difficulté réelle de la tâche. |
| Cache | Éviter de retraiter les mêmes instructions, contextes ou informations déjà vues. |
| Routage des tâches | Envoyer les tâches simples vers un modèle moins coûteux et garder le premium pour les cas complexes. |
| Réduction du contexte | Donner au modèle uniquement les informations utiles, pas tout l’historique par sécurité. |
| Validation humaine sur les cas sensibles | Limiter les erreurs coûteuses en gardant un contrôle humain quand l’impact métier est important. |
Les benchmarks suffisent-ils ?
Les benchmarks aident à cadrer le niveau attendu, mais ils ne suffisent pas pour décider d’un déploiement sérieux.
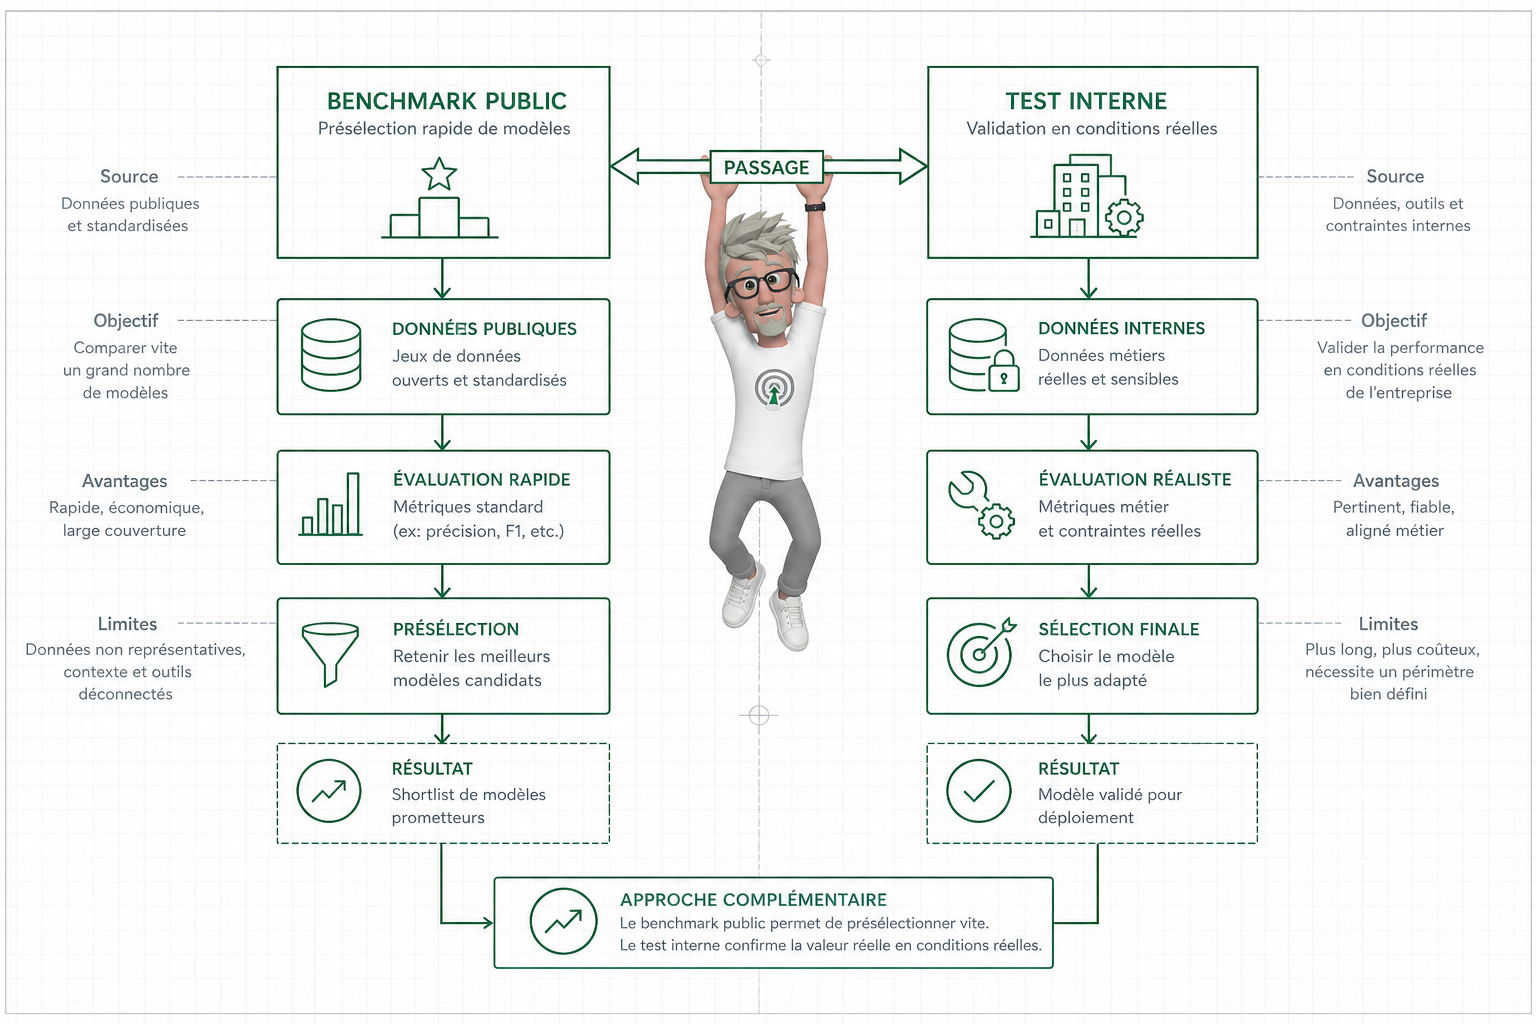
Je les regarde, bien sûr. Surtout quand on parle de GPT-6 Sol et Luna, parce que les comparaisons annoncées touchent des usages assez concrets : workflows professionnels, ingénierie logicielle, usage d’ordinateur, codage. C’est utile pour sentir si un modèle tient la route sur des tâches proches du terrain.
Mais le message central, à mon avis, ce n’est pas “Sol et Luna écrasent tout”. Ce serait trop simple. Le vrai signal, c’est plutôt qu’ils semblent proches de modèles plus chers sur plusieurs familles de tâches. Et ça, pour une entreprise, c’est intéressant. Pas parce que ça fait joli dans un graphique, mais parce que ça peut changer le coût d’un process automatisé.
Il faut quand même garder la tête froide. Certains scores concurrents peuvent venir de sources publiques. Les environnements de test peuvent changer. Et surtout, un résultat dans une interface comme ChatGPT peut être différent d’un usage API réel, ou d’un agent branché à vos outils internes. J’ai déjà vu ça chez un client : modèle très convaincant en démo, beaucoup moins propre une fois connecté au CRM, avec des données sales et des cas métier ambigus.
Quand je lis ces benchmarks pour un client, je ne regarde pas d’abord le podium. Je regarde la tâche réelle. Un modèle peut être excellent en codage et moins fiable sur un contrôle métier. Il peut très bien résumer un document, mais être insuffisant sur une décision qui demande une traçabilité forte, c’est-à-dire la capacité à expliquer clairement d’où vient la réponse.
Les bonnes questions sont souvent plus utiles que le score global :
- Est-ce que la tâche ressemble vraiment au benchmark ?
- Quelle est la gravité d’une erreur ?
- Combien coûte une vérification humaine ?
- Est-ce que le modèle sait dire qu’il ne sait pas ?
- Est-ce que les réponses sont exploitables directement ?
| Type de test | Utilité | Limite | Décision possible |
| Benchmark public | Cadrer le niveau général du modèle et comparer des familles de tâches. | Ne reflète pas toujours vos données, vos outils, vos contraintes et vos erreurs réelles. | Choisir quels modèles méritent un test plus sérieux. |
| Test interne | Mesurer la performance sur vos cas métiers, avec vos documents et vos règles. | Demande du temps, un jeu de test propre et des critères clairs. | Décider si Sol ou Luna peuvent passer en production, et sur quel périmètre. |
Comment les tester proprement ?
Il faut tester Sol et Luna sur des cas réels, avec les mêmes prompts, les mêmes données et une grille de notation simple.
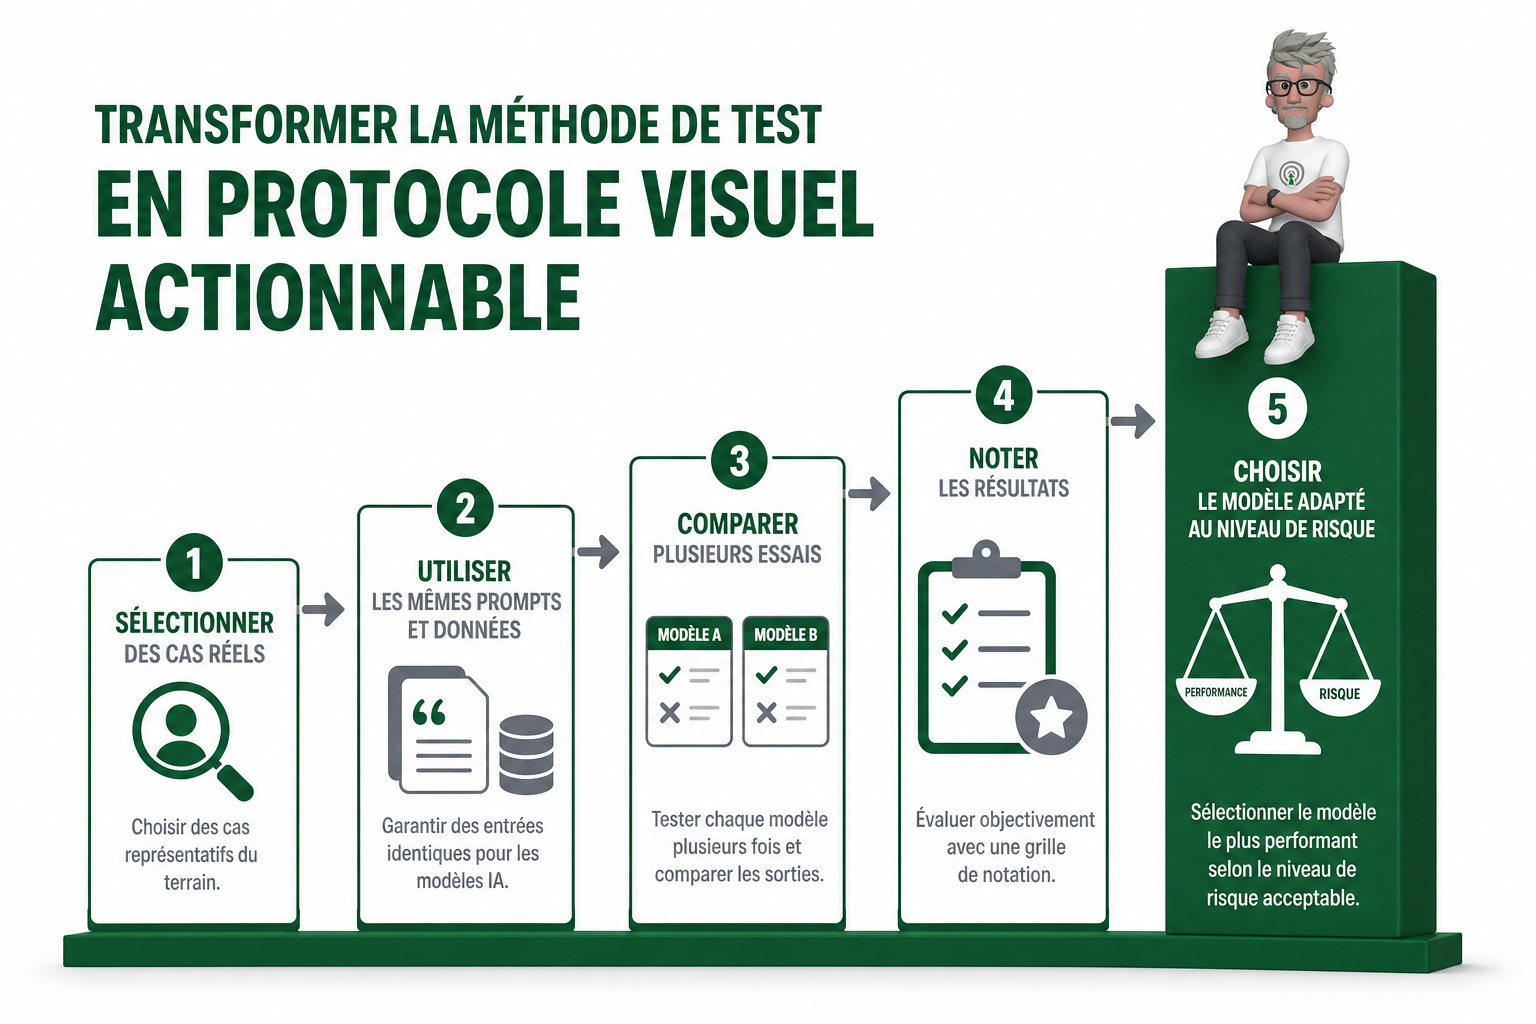
Je ferais ça dans ChatGPT si les modèles sont disponibles dans votre interface, ou via API si vous avez les accès. Attention, la disponibilité peut dépendre du type de compte, de l’interface utilisée et des accès ouverts au moment du test. Donc je ne partirais pas du principe que tout le monde voit les mêmes options au même moment.
Le piège, c’est de tester avec deux prompts “waouh” et de conclure trop vite. J’ai souvent vu des équipes choisir un modèle après trois réponses impressionnantes, puis découvrir en production que le vrai problème était la régularité. Ce qu’on cherche, ce n’est pas une démo brillante, c’est un comportement fiable sur la durée.
Je prendrais plusieurs cas proches de votre quotidien, puis je ferais tourner Sol et Luna dans les mêmes conditions :
- Calculs métier du quotidien, par exemple marge, remise, TVA, prorata, arrondi.
- Planification entre fuseaux horaires, avec dates, contraintes et exceptions.
- Résumé ou reformulation d’un email, d’un compte rendu ou d’un brief.
- Exécution d’une consigne longue, avec plusieurs règles à respecter.
- Comparaison de documents, pour repérer les écarts et les points manquants.
- Aide au codage simple, comme corriger une fonction ou expliquer une erreur.
- Extraction d’informations structurées, par exemple sortir un JSON propre depuis un texte.
Je testerais au moins plusieurs variantes de prompts et plusieurs exemples par cas. Un seul bon résultat ne prouve rien. Trois bons résultats non plus, si le quatrième part dans le décor.
| Critère | Ce que je mesure |
| Exactitude | La réponse est-elle juste, vérifiable, sans invention ? |
| Clarté | La réponse est-elle compréhensible sans effort ? |
| Concision | Le modèle va-t-il droit au but ou ajoute-t-il du bruit ? |
| Gestion des ambiguïtés | Le modèle pose-t-il une question quand il manque une info ? |
| Stabilité entre plusieurs essais | Les réponses restent-elles cohérentes d’un test à l’autre ? |
| Coût estimé | Le gain justifie-t-il le prix à votre volume réel ? |
| Besoin de reprise humaine | Combien de corrections faut-il avant usage ? |
À la fin, je déciderais comme ça :
| Situation | Choix raisonnable |
| Volume élevé, tâches simples, faible risque | Luna |
| Tâches plus exigeantes, consignes longues, raisonnement plus fin | Sol |
| Cas à risque, décision critique, forte exigence de fiabilité | Garder un modèle supérieur avec validation humaine |
Quels risques surveiller ?
Les risques à surveiller sont les erreurs factuelles, les réponses trop confiantes, les écarts entre benchmark et production, et le mauvais arbitrage entre coût et qualité.
Sur le papier, GPT-6 Sol et Luna promettent moins d’erreurs factuelles, un style plus clair, plus concis, et probablement une meilleure tenue sur les tâches courantes. C’est intéressant, mais je ne le prendrais jamais comme une garantie. Je le vérifierais sur mes propres données, mes propres prompts, mes propres cas tordus. C’est là que les modèles montrent vraiment ce qu’ils valent.
Le vrai sujet, c’est le coût de l’erreur. Si le modèle résume un article interne et oublie un détail, ce n’est pas dramatique. Si le modèle donne une mauvaise réponse sur un contrat, une décision finance, un dossier santé, une règle de conformité, une donnée client ou une opération sensible, là on n’est plus dans le confort. On est dans le risque métier.
Je mets toujours des garde-fous simples avant de brancher ça à une automatisation. Validation humaine sur les cas sensibles. Seuils de confiance, c’est-à-dire un score ou un signal qui dit “là, je ne suis pas assez sûr”. Journalisation des réponses pour pouvoir auditer après coup. Tests réguliers avec des jeux de données de contrôle. Prompts de refus quand l’information manque. Routage vers un modèle plus robuste quand la tâche devient complexe ou ambiguë.
Avec le low code et les agents, ce point devient encore plus important. Un agent qui se trompe vite peut créer plus de travail qu’il n’en économise. J’ai déjà vu des automatisations “intelligentes” générer des tickets support inutiles, parce que le modèle interprétait mal trois champs CRM. Le bon design, souvent, c’est de laisser Luna ou Sol traiter le volume, puis de déclencher une vérification humaine ou un modèle plus fort dès qu’un signal de risque apparaît.
- Réponses qui changent trop souvent à consigne équivalente.
- Citations ou faits non vérifiables.
- Calculs incohérents ou arrondis mal gérés.
- Mauvaise gestion des fuseaux horaires.
- Confusion entre consigne et contexte.
- Refus mal placés sur des demandes légitimes.
- Sortie non conforme au format attendu.
| Risque | Symptôme | Parade |
| Erreur factuelle | Le modèle affirme sans source fiable. | Contrôle humain ou vérification par données internes. |
| Surconfiance | La réponse semble sûre alors que le contexte manque. | Prompt de refus et seuil de confiance. |
| Écart production | Le benchmark est bon, mais les vrais cas échouent. | Tests réguliers sur jeux de contrôle métier. |
| Mauvais coût qualité | Le modèle moins cher crée des reprises manuelles. | Routage vers Sol, Luna ou un modèle plus fort selon le risque. |
Alors, on les teste où dans votre stack ?
Sol et Luna ont du sens si on les regarde pour ce qu’ils promettent vraiment : une IA proche d’un niveau avancé, mais pensée pour mieux tenir le coût, surtout côté API et agents. Sol paraît plus adapté aux tâches exigeantes à budget contrôlé. Luna vise les gros volumes où chaque appel compte. Les benchmarks donnent une indication, pas une décision. Le vrai juge, c’est votre cas d’usage, vos données, vos erreurs acceptables et votre coût par tâche terminée. Si vous testez proprement, vous pouvez garder la qualité là où elle compte et réduire la facture là où c’est possible.
FAQ
- GPT-6 Sol et Luna sont-ils faits pour remplacer les meilleurs modèles ?
Pas forcément. Leur intérêt annoncé, c’est plutôt d’approcher un niveau de performance avancé avec un coût plus bas. Je les verrais comme des modèles à tester pour optimiser une stack IA, pas comme un remplacement automatique partout. - Quelle différence entre GPT-6 Sol et GPT-6 Luna ?
Sol est présenté comme le modèle intermédiaire pour des tâches plus exigeantes à coût réduit. Luna vise davantage les tâches à fort volume, quand le prix par appel devient déterminant. En pratique, il faut les comparer sur vos propres workflows. - Les benchmarks permettent-ils de choisir le bon modèle ?
Ils donnent une première lecture, mais ils ne suffisent pas. Un benchmark ne reproduit pas toujours votre contexte, vos données, vos prompts, vos contraintes métier ou vos outils. Je m’en sers comme filtre, puis je teste sur des cas réels. - Pourquoi le cache est important pour les agents IA ?
Parce qu’un agent peut appeler le modèle plusieurs fois pour une seule tâche. Si une partie du contexte ou des instructions peut être réutilisée efficacement, on réduit les traitements inutiles. Sur de gros volumes, ça peut changer sérieusement l’économie du projet. - Comment tester Sol et Luna sans se tromper ?
Je partirais sur une grille simple : exactitude, clarté, concision, stabilité, coût, reprise humaine nécessaire et respect du format attendu. Même prompt, mêmes données, plusieurs essais. Et surtout, je garde une validation humaine sur les tâches sensibles.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent passer de la démo IA sympa à des systèmes fiables, mesurables et rentables. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige aussi l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez cadrer vos usages IA, vos agents ou vos coûts API, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.