




Un filigrane Claude ne s’enlève pas comme une ligne cachée. Sur le texte, il faut surtout comprendre le motif statistique. Sur le code, c’est plus fragile. Sur les fichiers, les métadonnées changent tout. Je vous montre ce qui est réaliste, et ce qui ne l’est pas.
Besoin d'aide ? Découvrez les solutions de notre agence IA.
C’est quoi un filigrane Claude ?
Un filigrane Claude, c’est une trace de provenance ou un motif de génération. Pas forcément un logo, pas forcément un texte caché, et pas forcément un caractère invisible qu’on pourrait supprimer dans un éditeur.
Quand on parle de filigrane sur du texte généré par IA, on parle souvent d’un signal statistique. Google DeepMind l’a bien documenté publiquement avec SynthID-Text. L’idée, en simplifiant, c’est de modifier très légèrement la probabilité de certains tokens. Un token, c’est un morceau de texte manipulé par le modèle. Ça peut être un mot, un bout de mot, une ponctuation. Le texte reste naturel pour un humain, mais à grande échelle, certains choix laissent une empreinte détectable.
C’est important parce que beaucoup de gens imaginent un filigrane comme dans une image. Un petit logo dans un coin. Là, non. On ne cherche pas un caractère magique caché entre deux espaces. On parle plutôt d’un motif réparti dans les choix de formulation. C’est plus subtil, et forcément moins binaire.
Pour le code, c’est encore différent. Un modèle peut générer du code avec moins de liberté syntaxique. Le langage impose déjà des contraintes fortes. Une fonction Python ou JavaScript doit respecter une grammaire précise. Du coup, un éventuel marquage peut passer par des choix de style, des noms de variables, une structure de blocs, ou certains patterns récurrents. Mais c’est fragile. Un refactoring propre peut casser une bonne partie du signal.
Pour les fichiers, on change de terrain. Là, on peut avoir des métadonnées de provenance. C’est le principe porté publiquement par la C2PA. On attache au contenu des informations sur son origine, son historique, les outils utilisés, parfois des signatures cryptographiques. Ce n’est pas le même sujet qu’un motif statistique dans une phrase. C’est une couche d’information ajoutée au fichier.
| Contenu | Type de marque | Robustesse | Niveau de contrôle possible |
| Texte | Signal statistique distribué dans les tokens | Moyenne, sensible aux grosses réécritures | Faible à moyen |
| Code | Patterns de style, structure, choix syntaxiques | Faible à moyenne, fragile au refactoring | Moyen |
| Fichiers | Métadonnées de provenance, type C2PA | Bonne si signée, faible si le fichier est nettoyé | Élevé sur les métadonnées |
Pourquoi le texte résiste ?
Le texte résiste parce que le filigrane est intégré dans les probabilités de formulation, pas dans un bloc supprimable. Dit autrement, ce n’est pas comme une signature cachée qu’on pourrait enlever avec un copier-coller ou un nettoyage de caractères.
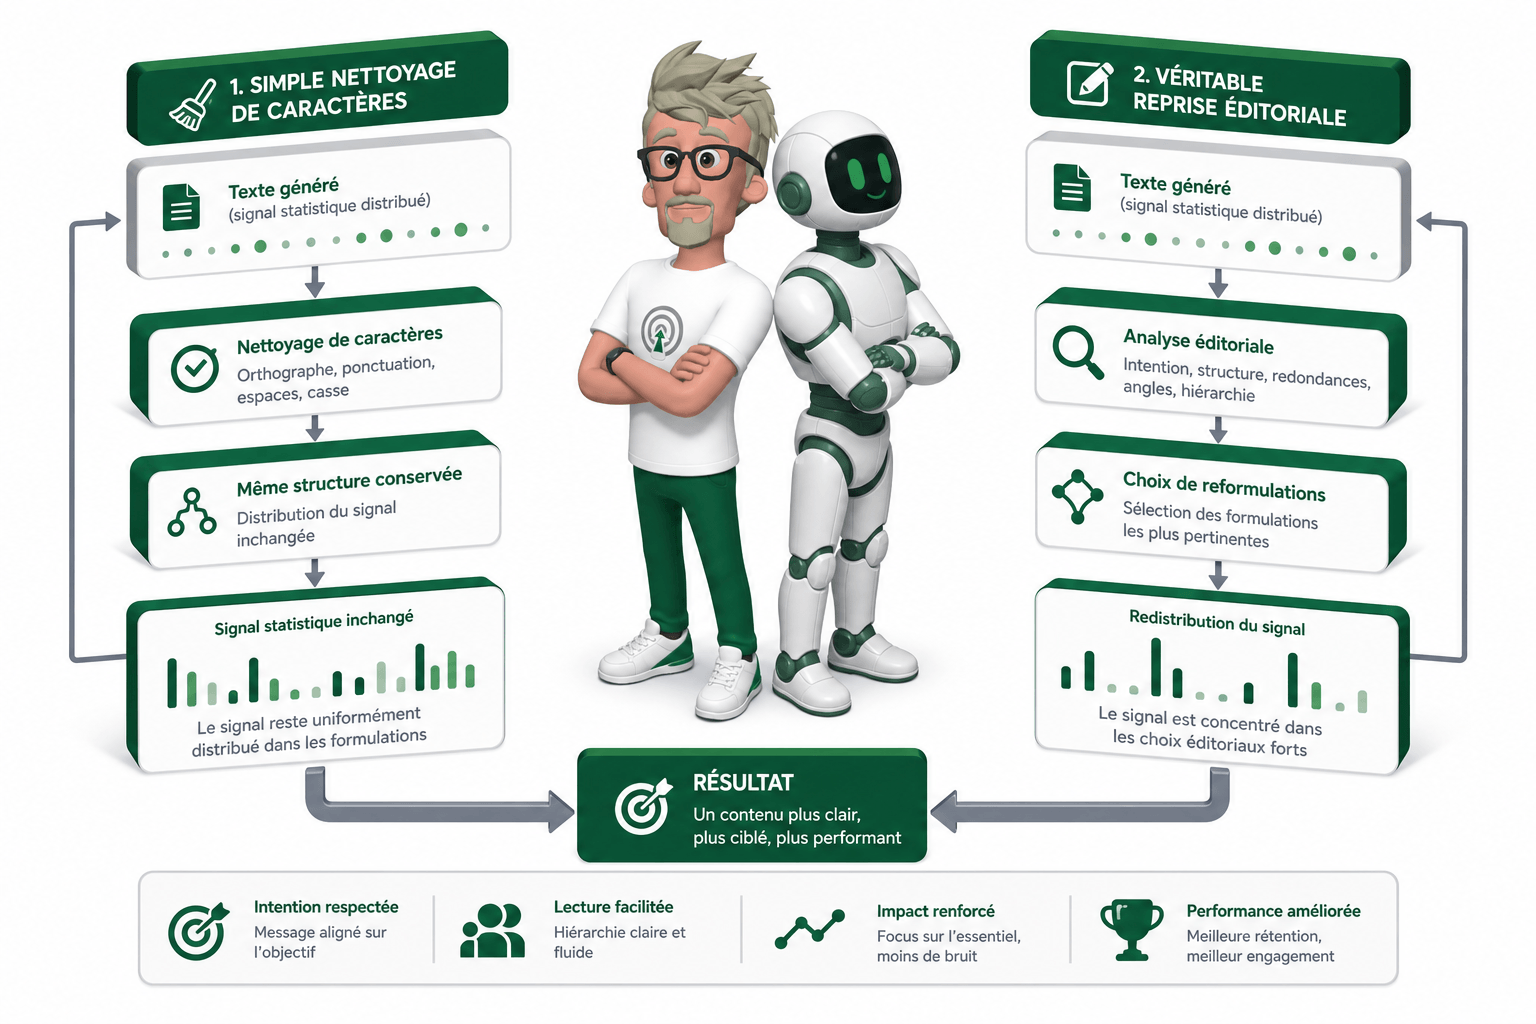
Quand un modèle génère du texte, il choisit des mots selon des probabilités. Un filigrane statistique peut jouer sur ces choix. Il peut favoriser certaines tournures, certains enchaînements, certaines distributions de mots. Donc si le signal vient de la manière dont le texte est formulé, changer d’éditeur ne change pas grand-chose.
Copier le texte dans Notion, Word, Google Docs ou un outil de nettoyage ne règle pas le sujet. Supprimer les doubles espaces, les caractères invisibles, les sauts de ligne bizarres, ça peut rendre le fichier plus propre, oui. Mais si le signal est dans les choix de mots, le texte garde une partie de sa logique initiale.
Une vraie réécriture change davantage les choses, mais pas parce qu’elle “efface” quelque chose de façon magique. Elle transforme le texte sur le fond. Elle apporte une intention, une voix, une précision métier.
- Elle reformule les idées avec vos mots.
- Elle change l’angle du passage.
- Elle modifie la structure des phrases.
- Elle ajoute des exemples concrets.
- Elle adapte le ton à votre marque, votre métier, votre audience.
Je reste prudent là-dessus. Je ne promets jamais un effacement complet, et je ne donne pas de recette pour tromper un système de détection. Ce n’est pas le bon sujet. Le bon sujet, c’est de reprendre possession du texte. Vérifier les faits, clarifier le propos, enlever les phrases génériques, ajouter ce que vous savez vraiment.
| Avant | Les entreprises peuvent utiliser l’intelligence artificielle pour améliorer leur productivité et optimiser leurs processus internes. |
| Après | Dans une PME, je vois surtout l’IA gagner du temps sur les tâches répétitives : trier des demandes clients, préparer des comptes rendus, relancer des devis oubliés. Ce n’est pas spectaculaire, mais c’est souvent là que le retour est le plus rapide. |
Chez les clients, le vrai gain vient rarement du nettoyage automatique. Il vient de la reprise métier du contenu. Quand quelqu’un du terrain relit, précise, coupe le flou et ajoute l’expérience réelle, le texte devient meilleur. Et ça, aucun outil de nettoyage ne le remplace.
Pourquoi le code bouge plus ?
Le code bouge plus facilement parce qu’un programme peut garder le même comportement avec des noms, des commentaires ou un formatage différents. Vous pouvez renommer une variable locale, déplacer une petite logique dans une fonction, changer l’indentation automatique, et le résultat reste le même. Dans du texte naturel, ces micro-variations changent vite le style. Dans du code, c’est plus mécanique.
Mais il y a une limite assez forte. La syntaxe encadre tout. Les mots-clés comme def, return ou for, les imports obligatoires, les appels API, les signatures attendues par une librairie, certaines structures, tout ça ne se change pas librement. C’est ce qui rend un filigrane moins robuste dans du code que dans du texte naturel. Il y a moins d’espace pour cacher un signal sans risquer de casser quelque chose.
Je distingue toujours deux familles de changements, surtout chez des clients qui veulent “nettoyer” du code généré par IA avant de l’intégrer en prod :
- Transformations sûres : Renommer une variable locale, reformater avec Black, supprimer un commentaire inutile, extraire une petite fonction pure, c’est-à-dire une fonction sans effet externe.
- Transformations risquées : Changer une API, modifier l’ordre d’effets de bord, toucher à une logique métier non testée, ou “simplifier” une condition qu’on ne comprend pas vraiment.
Voici un exemple simple. Le but ici n’est pas d’effacer une provenance, mais de montrer qu’un refactoring propre peut garder le même comportement.
def total_with_tax(items, tax_rate):
    # Additionne les prix puis applique la taxe.
    total = 0
    for item in items:
        total += item["price"]
    return round(total * (1 + tax_rate), 2)


def sum_prices(items):
    return sum(item["price"] for item in items)


def total_with_tax_refactored(items, tax_rate):
    return round(sum_prices(items) * (1 + tax_rate), 2)


cart = [{"price": 10}, {"price": 15.5}]
assert total_with_tax(cart, 0.2) == total_with_tax_refactored(cart, 0.2)
Pour comprendre ce qu’on peut refactoriser, Python fournit ast, un module qui transforme le code en arbre syntaxique. C’est utile pour analyser les variables locales avant un refactoring, pas pour fabriquer un outil d’effacement de provenance.
import ast

source = """
def compute_total(items):
    total = 0
    for item in items:
        total += item["price"]
    return total
"""

tree = ast.parse(source)

class LocalNameVisitor(ast.NodeVisitor):
    def visit_FunctionDef(self, node):
        print(f"Function: {node.name}")
        for child in ast.walk(node):
            if isinstance(child, ast.Name) and isinstance(child.ctx, ast.Store):
                print(f"Local variable: {child.id}")

LocalNameVisitor().visit(tree)
La règle simple que j’applique : si le code n’a pas de tests, on ne refactorise pas à l’aveugle. Sinon, on ne sait pas si on a amélioré le code ou juste cassé quelque chose plus discrètement.
Que faire avec les fichiers ?
Avec les fichiers, il faut d’abord distinguer le contenu visible des métadonnées de provenance. Le contenu visible, c’est ce que vous lisez, voyez ou copiez. Les métadonnées, c’est ce que le fichier peut transporter en plus : auteur, logiciel utilisé, dates de création, historique d’édition, appareil photo, outil d’export, parfois même des informations de traçabilité.
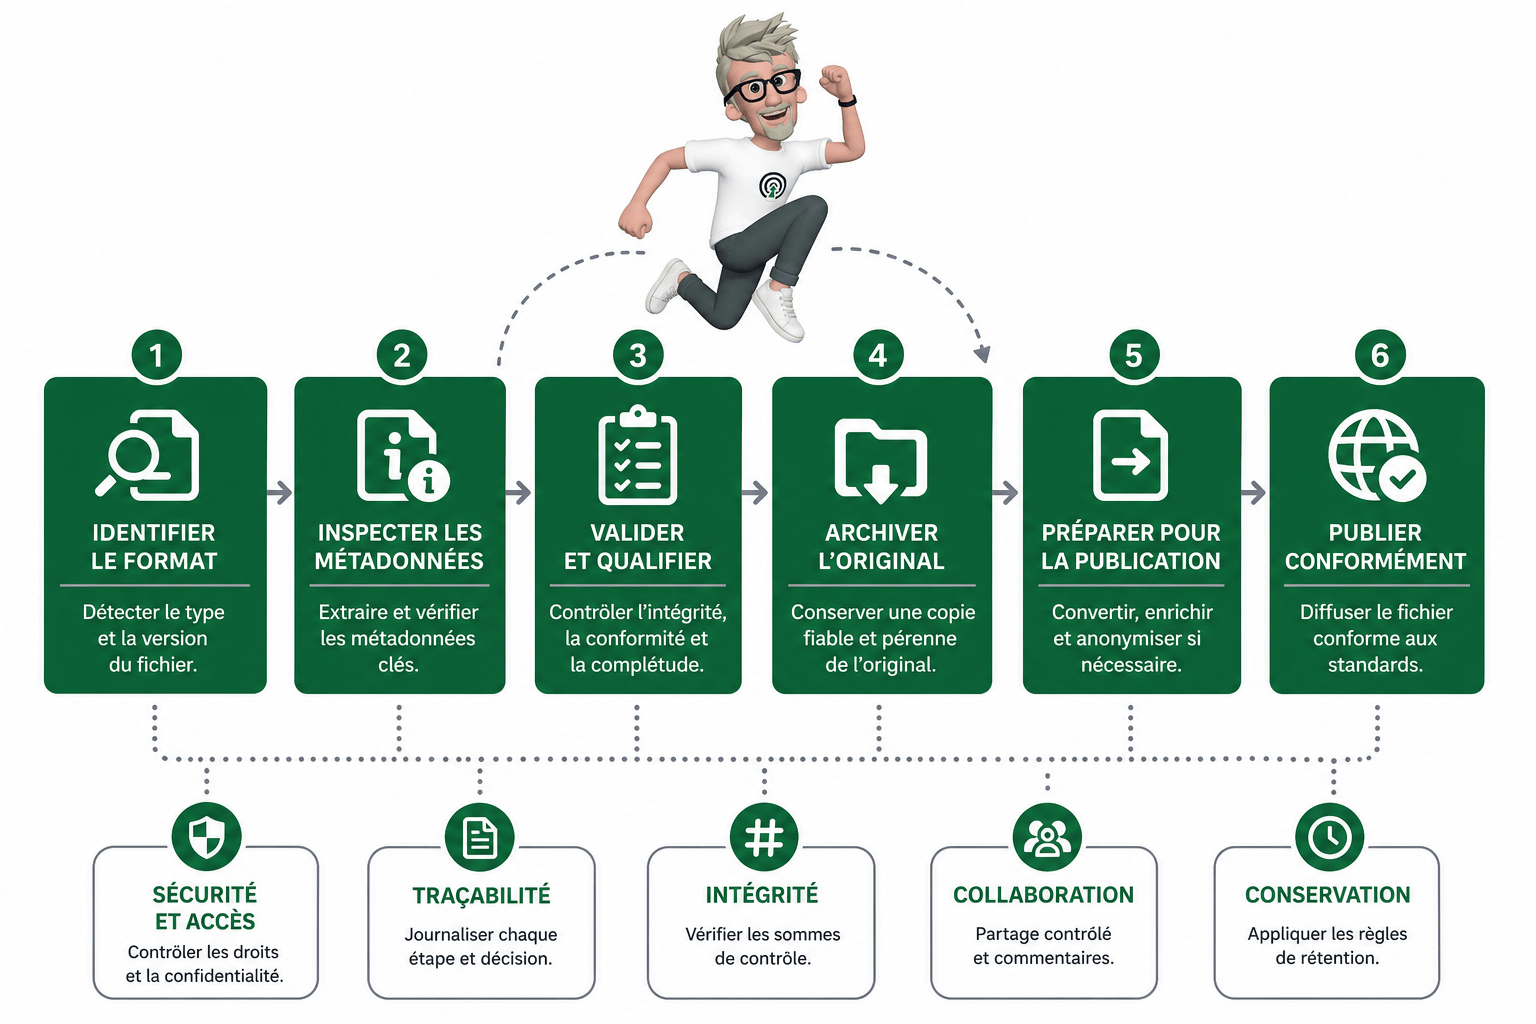
Certains formats gardent beaucoup plus de traces que d’autres. Un PDF complet peut contenir des propriétés internes, des infos de lecteur PDF, des signatures, des champs cachés ou des données d’export. Une image peut embarquer des données EXIF, comme le modèle de l’appareil ou le logiciel de retouche. Un document bureautique peut garder le nom de l’auteur, des commentaires, des révisions. Un fichier exporté depuis une plateforme peut aussi contenir des marqueurs liés au service utilisé.
Les standards comme C2PA ont justement été conçus pour documenter l’origine et les modifications d’un contenu. L’idée n’est pas de “piéger” l’utilisateur, mais de fournir une chaîne de provenance : qui a créé le contenu, avec quel outil, quelles modifications ont été faites. C’est utile pour la confiance, surtout avec les contenus générés ou modifiés par IA.
Un point très concret : une copie de texte sortie d’un PDF n’a pas les mêmes traces qu’un fichier PDF complet. Si vous copiez trois paragraphes dans un éditeur texte, vous récupérez surtout le texte visible. Si vous partagez le PDF original, vous partagez potentiellement aussi ses métadonnées.
Ma méthode saine ressemble à ça :
- Identifier le format : PDF, image, DOCX, export HTML, fichier texte, archive, etc.
- Inspecter les métadonnées : Propriétés du fichier, informations du lecteur PDF, ExifTool, panneau d’informations du logiciel utilisé.
- Vérifier les obligations : Contrat client, licence, politique interne, droit d’auteur, mentions obligatoires.
- Conserver une version originale : C’est votre preuve de départ, surtout si le fichier a une valeur juridique ou métier.
- Produire une version de travail : Si vous êtes propriétaire du fichier, vous pouvez créer une copie adaptée à l’usage prévu, sans toucher à l’original.
Attention quand même. Retirer une information de provenance pour faire croire qu’un contenu a une autre origine peut poser un vrai problème éthique, juridique ou contractuel. J’ai déjà vu des équipes vouloir “nettoyer” des fichiers avant publication, juste par réflexe. Dans certains cas c’est normal. Dans d’autres, ça revient à masquer une source, un outil ou une modification importante.
| Inspection | Je vérifie ce que le fichier contient vraiment : propriétés, métadonnées, signatures, historique visible. |
| Export | Je génère une version adaptée à l’usage, en gardant en tête les règles de licence et de provenance. |
| Archivage | Je conserve l’original intact, avec ses traces, pour garder une référence fiable. |
| Publication | Je publie une version conforme, claire sur son origine si c’est nécessaire ou attendu. |
Peut-on tout effacer ?
On ne peut pas garantir un effacement total d’un filigrane Claude dans tous les cas. Je préfère être clair là-dessus, parce que c’est souvent là que les gens se racontent une histoire confortable.
Un détecteur n’est pas un juge absolu. C’est probabiliste. Ça veut dire qu’il donne une probabilité, un score, une impression statistique basée sur des motifs. Deux outils peuvent ne pas être d’accord. Un texte réécrit peut faire baisser un signal, sans prouver qu’il n’existe plus. Et l’inverse arrive aussi, j’ai déjà vu du contenu 100 % humain se faire signaler comme “probablement IA”.
Les signaux changent selon les formats. Dans un texte, on parle surtout de style, de répétitions, de tournures trop propres. Dans du code, on regarde plutôt la structure, les commentaires, les patterns trop génériques. Dans un fichier, il peut y avoir des métadonnées, c’est-à-dire des infos cachées comme l’auteur, l’outil utilisé, la date de création ou l’historique d’export. Ces métadonnées peuvent être copiées, supprimées, modifiées ou perdues sans que vous vous en rendiez compte.
La seule approche sérieuse, c’est de reprendre le contenu avec un vrai travail humain. Pour un texte, ça veut dire une réécriture éditoriale, avec votre angle, vos exemples, vos sources et votre ton. Pour du code, ça veut dire une refactorisation testée, pas juste changer les noms de variables. Pour des fichiers, ça veut dire une gestion propre de la provenance, donc savoir d’où vient le fichier, ce qu’il contient, et ce qu’on transmet.
Voilà ma checklist simple selon l’objectif :
- Publier : Relire, sourcer, reformuler avec votre point de vue, vérifier que le contenu dit quelque chose de vrai.
- Livrer à un client : Documenter l’usage de l’IA si c’est nécessaire, garder les sources, assumer les modifications.
- Intégrer dans une base documentaire : Ajouter le contexte, la date, l’origine, et éviter les copier-coller bruts.
- Versionner du code : Refactoriser, tester, commenter ce qui mérite de l’être, garder un historique Git propre.
- Archiver un fichier : Vérifier les métadonnées, le format, les droits, et conserver une trace de provenance.
Le bon sujet n’est pas seulement d’enlever une trace, c’est de maîtriser ce qu’on publie.
Alors, qu’est-ce que je garde en tête ?
Je retiens surtout une chose : un filigrane Claude n’est pas un autocollant qu’on décolle. Sur le texte, le signal peut venir de la manière dont les mots ont été choisis. Sur le code, c’est souvent moins solide parce que la syntaxe contraint déjà beaucoup le modèle. Sur les fichiers, les métadonnées et la provenance changent complètement le problème. La meilleure approche, c’est de reprendre le contenu proprement, tester le code, inspecter les fichiers et assumer l’usage de l’IA quand c’est nécessaire. Le bénéfice pour vous : publier ou livrer un contenu mieux maîtrisé, plus fiable, et moins risqué.
FAQ
- Un filigrane Claude est-il un caractère caché ?
Pas forcément. Pour le texte, il peut s’agir d’un motif statistique lié aux choix de mots ou de tokens. C’est justement pour ça qu’un simple copier-coller, un nettoyage d’espaces ou un changement d’éditeur ne suffit pas. - Une paraphrase suffit-elle à enlever un filigrane ?
Une paraphrase profonde peut modifier le signal, mais elle ne garantit pas un effacement total. Le plus fiable reste une vraie reprise humaine : changer la structure, préciser les idées, ajouter votre expertise et vérifier les faits. - Pourquoi le code généré par IA est-il moins protégé ?
Le code a une syntaxe stricte. Beaucoup d’éléments ne peuvent pas changer sans casser le programme. En revanche, les noms de variables, certains commentaires ou le formatage peuvent évoluer sans modifier le comportement, ce qui rend un filigrane moins robuste. - Les PDF et fichiers contiennent-ils aussi des filigranes ?
Ils peuvent contenir des métadonnées ou des informations de provenance, notamment selon le format et l’outil utilisé. Il faut distinguer le contenu visible du fichier complet. Un texte copié depuis un PDF et le PDF original ne portent pas forcément les mêmes informations. - Est-ce une bonne idée de supprimer toute provenance IA ?
Pas si l’objectif est de tromper un lecteur, un client ou une plateforme. Le bon réflexe, c’est de maîtriser ce qu’on publie : relire, réécrire, tester, documenter et respecter les obligations contractuelles ou légales liées à la provenance.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui doivent industrialiser leurs contenus, leurs données et leurs workflows sans perdre le contrôle sur la qualité, la traçabilité et la conformité. J’ai travaillé avec des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez cadrer l’usage de l’IA dans votre entreprise, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.