




Les meilleures alternatives open source à ChatGPT en local existent déjà, et certaines sont franchement solides. Je vais comparer celles qui servent vraiment selon votre besoin : chat simple, IA hors ligne, agents, RAG documentaire, interface privée ou plateforme complète pour votre business.
Besoin d'aide ? Découvrez les solutions de notre agence Openai GPT.
Pourquoi lancer ChatGPT en local ?
Lancer une alternative à ChatGPT en local sert surtout à garder le contrôle sur les données, les coûts, les modèles et les usages internes.
Ce n’est pas juste un délire de technicien. Quand une entreprise commence à envoyer des documents clients, des contrats, des tickets support ou des données métier dans une IA, la première question devient très vite : Où partent ces données, qui peut les voir, combien ça coûte, et est-ce qu’on pourra encore changer demain ?
Le local répond à ça assez simplement. Vous gardez l’infrastructure chez vous, sur un poste, un serveur interne ou un cloud privé. Vous réduisez la dépendance aux API externes, une API étant juste une porte d’entrée technique vers un service distant. Vous pouvez tester plusieurs modèles sans tout reconstruire. Et selon les outils, vous pouvez même travailler hors ligne, ce qui est très utile dans certains contextes sensibles.
L’expérience peut être franchement proche de ChatGPT aujourd’hui. On a des interfaces open source avec chat, historique, gestion de fichiers, réglages du modèle, agents, outils, RAG, multi-modèles, connexions à Ollama, llama.cpp ou à des API compatibles OpenAI. Le RAG, pour faire simple, c’est le fait de brancher l’IA sur vos propres documents pour qu’elle réponde avec votre base de connaissance au lieu d’inventer dans son coin.
Sur le terrain, je le vois souvent chez mes clients : le vrai sujet n’est pas seulement le modèle. C’est l’interface, les droits utilisateurs, la récupération documentaire, les logs, la sécurité, et la capacité à industrialiser sans exposer les données n’importe où. Un bon modèle mal intégré ne sert pas à grand-chose. Une interface propre avec des droits clairs, là, ça change tout.
| Besoin | Pourquoi le local aide | Outil à regarder en priorité |
| Confidentialité | Les données restent sur votre machine ou votre infrastructure interne. | Ollama avec Open WebUI |
| Coût | Vous limitez les appels payants aux API externes, surtout sur les gros volumes. | Ollama |
| Test de modèles | Vous comparez facilement plusieurs modèles selon vos cas d’usage. | LM Studio |
| RAG documentaire | Vous interrogez vos fichiers internes sans les envoyer à un service tiers. | AnythingLLM |
| Plateforme interne | Vous proposez une interface commune avec utilisateurs, modèles et règles. | Open WebUI |
| Usage hors ligne | Vous continuez à travailler sans connexion, selon les modèles installés. | LM Studio ou llama.cpp |
Quelle interface choisir pour démarrer vite ?
Pour démarrer vite, je regarderais d’abord Jan si vous voulez une application simple, Open WebUI si vous acceptez Docker, et llama.cpp WebUI si vous cherchez le plus léger. C’est vraiment la question à se poser : vous voulez une app prête à cliquer, une vraie interface de travail, ou juste une couche web fine au-dessus du moteur ?
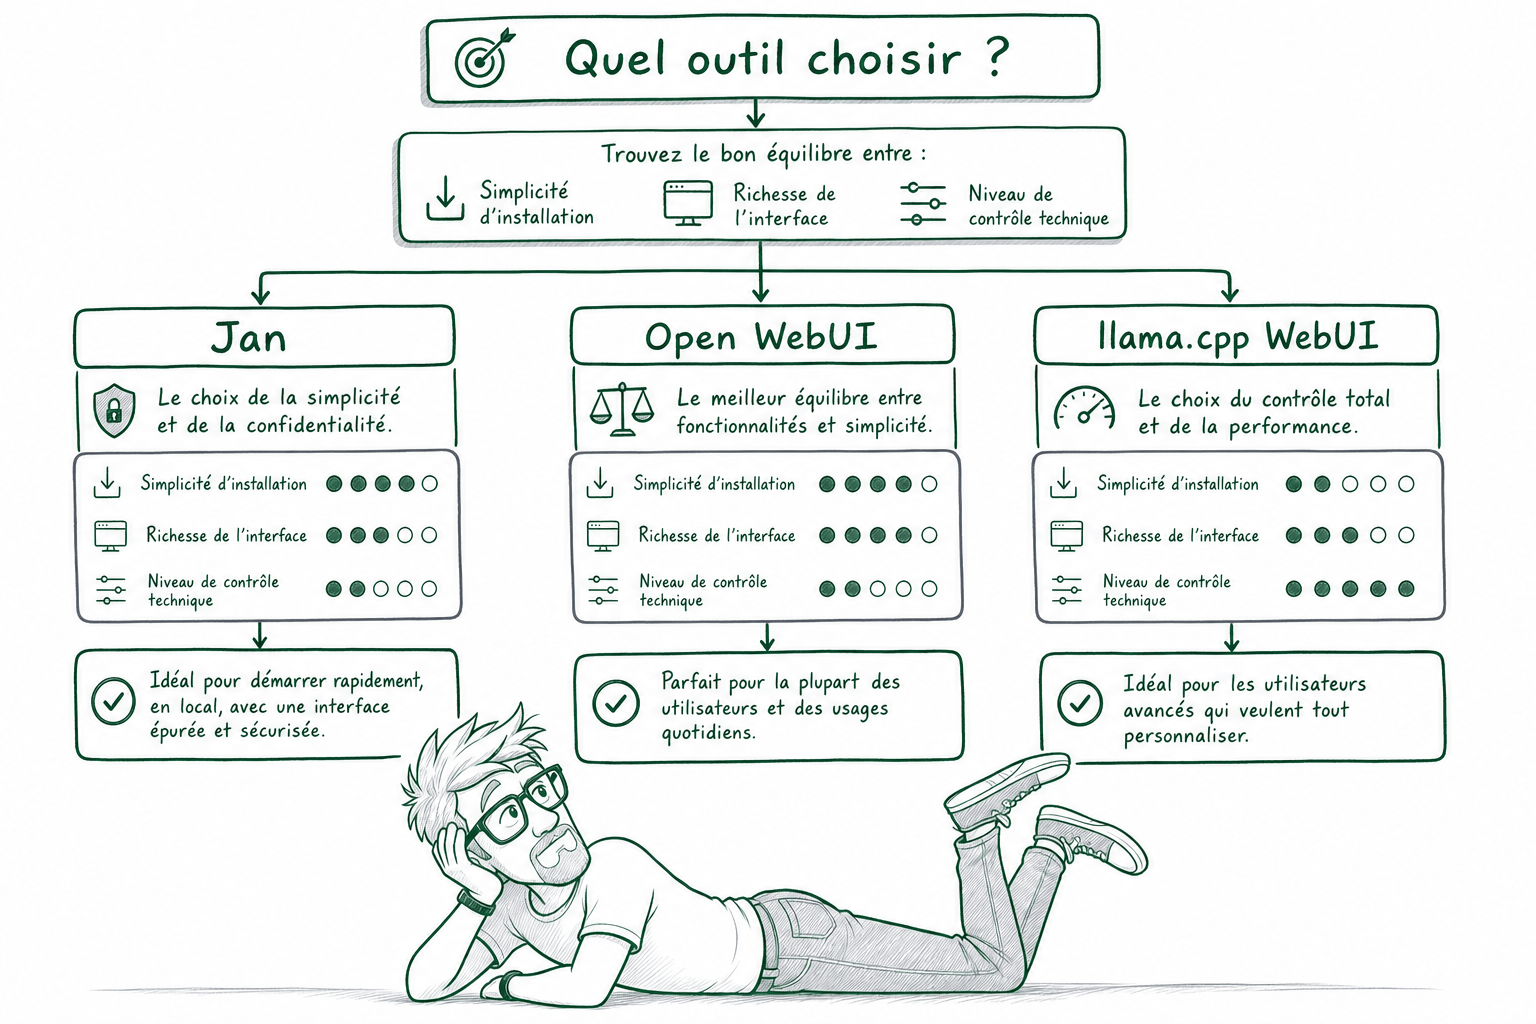
Open WebUI, pour moi, c’est l’interface locale la plus complète pour un poste de travail IA. Elle marche avec Ollama, llama.cpp, et aussi avec des API compatibles OpenAI, donc des serveurs qui exposent les mêmes routes que l’API OpenAI. C’est propre au quotidien, agréable pour discuter avec plusieurs modèles, gérer l’historique, et retrouver une vraie expérience de chat locale. Son défaut, c’est qu’il faut accepter une petite couche technique : Docker dans la majorité des cas, ou Python si vous préférez installer à la main.
Voilà le genre de commande que j’utilise quand je veux brancher Open WebUI sur Ollama rapidement :
# Lance Open WebUI dans un conteneur Docker
docker run -d
  # Nomme le conteneur pour le retrouver facilement
  --name open-webui
  # Expose l'interface web sur le port 3000
  -p 3000:8080
  # Garde les données même si le conteneur est recréé
  -v open-webui:/app/backend/data
  # Indique où Open WebUI doit trouver Ollama
  -e OLLAMA_BASE_URL=http://host.docker.internal:11434
  # Utilise l'image officielle Open WebUI
  ghcr.io/open-webui/open-webui:main
Pour lancer un modèle côté Ollama, c’est encore plus simple :
# Télécharge et lance Llama 3.1 en local via Ollama
ollama run llama3.1
llama.cpp WebUI, c’est l’option minimaliste. Pas besoin d’une grosse application séparée. L’interface est proche de llama.cpp, avec conversations multiples, streaming, réglages du modèle, pièces jointes et historique. C’est moins “produit fini”, soyons honnêtes, mais très efficace quand vous voulez rester près du moteur d’inférence.
# Démarre un serveur llama.cpp compatible avec l'API OpenAI
./llama-server
  # Charge le modèle local au format GGUF
  -m ./models/mistral-7b-instruct.gguf
  # Ouvre le serveur sur le port 8080
  --port 8080
  # Active l'accès depuis votre machine locale
--host 127.0.0.1Jan, lui, est souvent le meilleur choix pour les gens qui veulent juste tester sans se battre. Pas de Docker, pas de serveur séparé à comprendre, moins de friction. J’ai vu des clients non techniques réussir à lancer un modèle local avec Jan en quelques minutes, là où Docker les aurait déjà perdus.
| Outil | Niveau technique | Installation | Points forts | Limites | Profil idéal |
| Open WebUI | Intermédiaire | Docker ou Python | Interface complète, compatible Ollama, llama.cpp et API OpenAI | Un peu plus technique à installer | Utilisateur qui veut un vrai poste de travail IA local |
| llama.cpp WebUI | Technique | Intégré à llama.cpp | Léger, direct, proche du moteur | Moins polish, moins “app grand public” | Développeur qui veut contrôler l’inférence |
| Jan | Débutant | Application bureau | Simple, offline, pas de Docker | Moins flexible pour les setups avancés | Utilisateur qui veut tester vite sans complexité |
Quel outil choisir pour documents et RAG ?
Si je dois choisir un outil local pour travailler sur des documents et faire du RAG, je pars sur AnythingLLM. C’est le choix le plus logique, surtout quand vous devez organiser plusieurs espaces de connaissance sans tout mélanger.
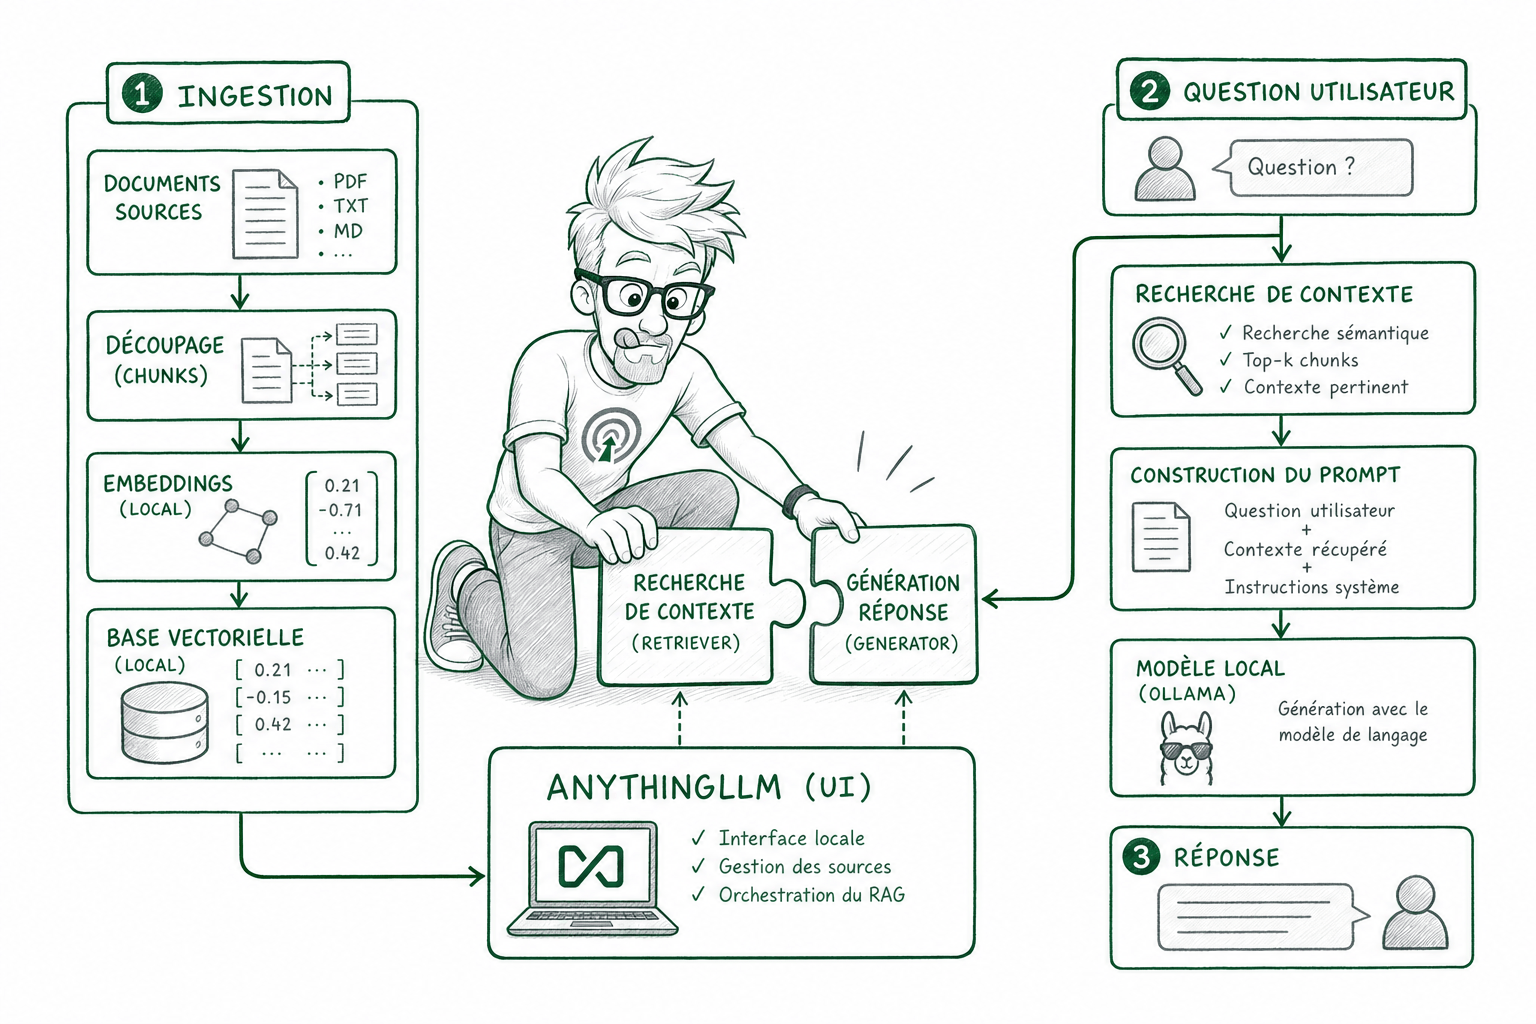
Le RAG, pour Retrieval Augmented Generation, change complètement la logique. Au lieu de discuter avec un modèle général qui répond avec ce qu’il a appris pendant son entraînement, vous lui donnez vos propres documents comme mémoire de travail. Les fichiers sont ingérés, découpés en petits morceaux, transformés en embeddings, c’est-à-dire en représentations numériques du sens, puis stockés dans une base vectorielle. Quand vous posez une question, le système retrouve les passages les plus proches, les donne au modèle comme contexte, et le modèle répond avec ces éléments.
- Document
- Découpage
- Embeddings
- Base vectorielle
- Question utilisateur
- Contexte récupéré
- Réponse du modèle
AnythingLLM est bien pensé pour ça. Vous pouvez créer des espaces de travail séparés, par exemple un espace RH, un espace support, un espace juridique, un espace produit. Chaque espace peut avoir ses documents, sa base de connaissances, ses réglages, ses agents. J’ai vu ce cas chez un client avec une documentation interne éclatée entre PDF, Notion exporté et fichiers Word. Le vrai gain n’était pas “l’IA magique”, c’était juste de retrouver vite la bonne procédure sans demander à trois personnes.
Les cas d’usage sont très concrets : documentation interne, support client, procédures métier, base RH, analyse de contrats, centre d’aide produit. Côté confidentialité, c’est intéressant si le modèle, l’interface et la base vectorielle restent dans votre infrastructure ou dans un environnement privé. Mais je préfère être clair : le niveau réel de confidentialité dépend toujours du déploiement choisi, des volumes Docker, des accès réseau, des sauvegardes et des connecteurs activés.
Voici une architecture locale simple pour tester. AnythingLLM sert d’interface RAG, Ollama exécute les modèles localement, et les volumes gardent les données après redémarrage.
version: "3.8"

services:
  ollama:
    image: ollama/ollama:latest
    container_name: ollama
    ports:
      - "11434:11434"
    volumes:
      - ollama_models:/root/.ollama

  anythingllm:
    image: mintplexlabs/anythingllm:latest
    container_name: anythingllm
    ports:
      - "3001:3001"
    volumes:
      - anythingllm_storage:/app/server/storage
    depends_on:
      - ollama

volumes:
  ollama_models:
anythingllm_storage:| Cas d’usage | Niveau de risque données | Configuration conseillée | Erreur à éviter |
| Centre d’aide produit | Faible à moyen | AnythingLLM local avec Ollama | Indexer une documentation obsolète |
| Base RH | Élevé | Déploiement privé avec accès restreints | Mélanger les espaces RH et support |
| Analyse de contrats | Élevé | Stockage local, modèle local, sauvegardes maîtrisées | Envoyer les documents vers une API externe sans audit |
Quand faut-il des agents et une plateforme complète ?
Quand le chat ne suffit plus, je passe sur une plateforme plus complète. C’est le moment où vous voulez des agents, des actions, plusieurs modèles, des droits utilisateurs, et une vraie organisation des usages IA. Sinon, un simple ChatGPT local avec Ollama fait déjà très bien le job.
LobeHub, je le vois comme la montée en gamme propre et agréable. L’interface est soignée, ça tourne bien avec Ollama, et c’est pratique pour créer des assistants spécialisés. Un assistant code, un assistant recherche, un assistant rédaction. C’est pertinent quand vous voulez structurer les usages sans partir tout de suite dans une usine à gaz.
LibreChat, c’est plus riche, mais aussi plus sérieux à cadrer. Vous avez les agents, le changement de modèle, les actions personnalisées, l’exécution de code, la recherche conversationnelle, l’authentification, plusieurs fournisseurs, et le support de MCP. MCP, pour faire simple, c’est une manière de connecter des outils et des contextes externes à un agent. Par exemple une base documentaire, un CRM, un dépôt Git, ou un outil interne. C’est puissant, mais ça demande de la gouvernance, des tests, et de la sécurité. Un agent qui peut agir doit avoir des limites claires.
Chez les clients, le piège classique, c’est de vouloir une plateforme agentique avant d’avoir clarifié les cas d’usage, les données accessibles et les actions autorisées. Et là, on fabrique surtout du risque avec une jolie interface.
Quelques agents concrets que je vois revenir souvent :
- Agent d’analyse de logs : Données nécessaires : logs applicatifs et métriques. Actions autorisées : lire, résumer, proposer une cause. Garde-fous : pas de suppression, pas d’accès aux secrets.
- Agent SEO : Données nécessaires : briefs, pages, mots-clés. Actions autorisées : proposer titres, plans, optimisations. Garde-fous : validation humaine avant publication.
- Agent support interne : Données nécessaires : base de connaissances, procédures RH ou IT. Actions autorisées : répondre et orienter. Garde-fous : pas de décision administrative automatique.
- Agent code : Données nécessaires : dépôt Git, documentation technique. Actions autorisées : expliquer, générer un patch, lancer des tests. Garde-fous : pas de merge sans revue.
- Agent recherche : Données nécessaires : web, PDF, notes internes. Actions autorisées : synthétiser et citer les sources. Garde-fous : obligation de sources vérifiables.
| Critère | LobeHub | LibreChat |
| Simplicité | Très bon | Plus complexe |
| Rendu | Très soigné | Solide, plus fonctionnel |
| Agents | Bon pour assistants spécialisés | Très complet avec actions et MCP |
| Multi-utilisateurs | Moins central | Plus adapté |
| Sécurité | Correcte pour usage local | Meilleure base pour entreprise |
| Complexité | Modérée | Élevée si on active tout |
| Meilleur contexte | Usage perso ou petite équipe | Plateforme IA privée d’équipe |
Quelle stack locale choisir au final ?
La bonne stack locale dépend rarement du “meilleur” outil. Elle dépend surtout de votre usage réel. Est-ce que vous voulez juste discuter avec un modèle ? Chercher dans vos documents ? Donner un outil à une équipe ? Brancher des agents ? Ou utiliser un serveur d’inférence déjà prêt, c’est-à-dire une machine qui fait déjà tourner les modèles et expose une API.
Ma synthèse simple. Open WebUI est souvent le meilleur point de départ avec Ollama pour un chat local propre. Llama.cpp WebUI est très bien si vous voulez rester proche de llama.cpp et optimiser finement. LobeHub est agréable pour un usage personnel moderne. AnythingLLM est solide pour le RAG, c’est-à-dire poser des questions à vos documents avec recherche avant réponse. Jan est pratique pour tester localement sans se compliquer la vie. LibreChat ressemble plus à une vraie plateforme d’équipe. Hugging Face Chat UI est une option légère et propre si vous avez déjà un serveur d’inférence local, avec connexion possible à des API compatibles OpenAI comme llama.cpp ou Ollama.
Par profil, je choisirais comme ça.
- Débutant non technique : Jan ou Ollama + Open WebUI.
- Développeur local : llama.cpp WebUI ou Open WebUI, selon le niveau de contrôle voulu.
- Équipe data : Open WebUI pour tester vite, AnythingLLM pour les documents.
- Entreprise avec documents sensibles : AnythingLLM ou LibreChat, avec stockage maîtrisé.
- Équipe voulant des agents : LibreChat ou LobeHub, en vérifiant les connecteurs.
- Organisation avec serveur d’inférence : Hugging Face Chat UI, simple, propre, sans doublonner l’infra.
Avant de déployer, je vérifie toujours ça. Machine disponible, GPU ou CPU, modèle choisi, interface, stockage des conversations, gestion des fichiers, authentification, sauvegarde, logs, droits d’accès, politique de données. J’ai déjà vu un client installer une belle interface locale, puis se rendre compte que les conversations sensibles étaient gardées sans règle claire. C’est bête, mais ça arrive.
Un exemple de stack réaliste. Je commence souvent simple : Ollama + Open WebUI pour le chat local, AnythingLLM pour le RAG, LibreChat si l’équipe a besoin d’une plateforme partagée, Hugging Face Chat UI si le serveur d’inférence est déjà prêt. Je préfère mesurer l’usage, puis ajouter les briques. Déployer une usine à gaz le premier jour, c’est rarement une bonne idée.
| Si vous voulez | Choisissez | Pourquoi | À surveiller |
| Un chat local simple | Ollama + Open WebUI | Rapide à lancer, agréable à utiliser | Gestion des comptes et sauvegardes |
| Tester des modèles finement | llama.cpp WebUI | Bon contrôle local | Configuration plus technique |
| Discuter avec vos documents | AnythingLLM | Bon pour le RAG | Qualité de l’indexation |
| Une plateforme équipe | LibreChat | Plus structuré pour plusieurs utilisateurs | Droits, logs, authentification |
| Une interface sur serveur existant | Hugging Face Chat UI | Léger, compatible API OpenAI | Stabilité du serveur d’inférence |
Et maintenant, vous partez sur quelle IA locale ?
Les alternatives open source à ChatGPT en local couvrent presque tous les besoins sérieux. Pour aller vite, Jan ou Open WebUI font très bien le job. Pour rester léger, llama.cpp WebUI suffit. Pour les documents et le RAG, AnythingLLM est souvent le bon réflexe. Pour les agents et une plateforme plus complète, LobeHub et LibreChat prennent le relais. Hugging Face Chat UI reste intéressant si votre serveur d’inférence est déjà prêt. Mon conseil : commencez petit, testez avec vos vrais usages, puis structurez. Le bénéfice pour vous, c’est une IA plus privée, plus contrôlable, et vraiment adaptée à votre business.
FAQ
- Quelle est la meilleure alternative open source à ChatGPT en local ?
Il n’y a pas un seul meilleur choix. Open WebUI est souvent le plus équilibré pour une expérience complète. Jan est plus simple pour démarrer. AnythingLLM est plus adapté aux documents et au RAG. LibreChat est plus intéressant si vous voulez une vraie plateforme IA privée. - Est-ce qu’une IA locale protège vraiment les données ?
Elle peut mieux protéger les données si tout est bien déployé : modèle local, interface locale, stockage contrôlé, authentification, sauvegardes et logs maîtrisés. Le local ne règle pas tout magiquement. Une mauvaise configuration peut rester risquée. - Faut-il Docker pour utiliser ces outils ?
Pas toujours. Open WebUI et LibreChat sont souvent déployés avec Docker parce que c’est pratique. Jan évite justement cette complexité avec une application de bureau. llama.cpp WebUI peut rester très léger si vous êtes à l’aise techniquement. - Quelle solution choisir pour interroger mes documents internes ?
AnythingLLM est le choix le plus naturel pour ça. Il permet de créer des espaces de travail, d’ingérer des documents, d’utiliser une base vectorielle et de structurer une vraie connaissance exploitable par le modèle. - Est-ce qu’on peut avoir des agents IA en local ?
Oui, avec des outils comme LobeHub ou LibreChat. LibreChat va plus loin avec agents, MCP, actions personnalisées, exécution de code et multi-fournisseurs. Je conseille juste de cadrer les droits et les actions avant de brancher des agents sur des données sensibles.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent rendre leurs données, leurs outils et leurs workflows IA vraiment opérationnels, pas juste faire une démo sympa. Avec webAnalyste et Formations Analytics, j’ai travaillé pour des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez déployer une IA locale, un RAG ou une automatisation IA utile dans votre entreprise, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.