




Je partirais d’un parcours progressif, pas d’une pile de théorie. D’abord comprendre l’IA au travail, puis prototyper, puis creuser les LLMs, le RAG, les agents et la mise en production. Le vrai sujet, c’est de choisir le bon cours selon votre niveau.
Besoin d'aide ? Découvrez les solutions de notre agence Openai GPT.
Par quoi commencer sans bagage technique ?
Le plus simple pour démarrer, c’est de ne pas commencer par les maths, les modèles de neurones ou les papiers de recherche. Je partirais plutôt sur un cours orienté usage réel, comme les formations IA de Formations-Analytics.com. Pour quelqu’un qui veut comprendre les LLMs sans bagage technique, c’est une bonne porte d’entrée.
Ce cours sert surtout à poser les bases. Ce qu’est l’IA. Ce qu’est le machine learning, c’est-à-dire des systèmes qui apprennent à partir de données au lieu d’être programmés règle par règle. Ce que change l’IA générative, donc les outils capables de produire du texte, des images, du code ou des réponses structurées. Et surtout comment utiliser tout ça dans un contexte professionnel sans faire n’importe quoi.
L’objectif ici n’est pas de devenir ingénieur LLM en deux heures. Ce serait une promesse bidon. L’objectif, c’est de comprendre ce qu’on peut faire avec ces outils, ce qu’on ne doit pas leur confier, et où sont les limites. Par exemple, un modèle peut donner une réponse très convaincante et pourtant fausse. C’est ce qu’on appelle une hallucination. Le mot est un peu bizarre, mais l’idée est simple : le modèle invente quelque chose avec aplomb.
Je vois souvent le même problème chez les clients. Tout le monde veut faire des prompts, créer des agents, brancher du RAG, c’est-à-dire connecter un modèle à une base de documents pour améliorer ses réponses. Mais personne n’est vraiment aligné sur ce que fait l’outil, ce qu’il ne fait pas, les données qu’on peut lui donner, les risques juridiques ou les erreurs possibles. Ce type de cours règle déjà une partie du problème, parce qu’il donne un vocabulaire commun.
Ce cours est particulièrement adapté à ces profils :
- Débutants complets qui veulent comprendre l’IA sans coder.
- Managers qui doivent cadrer des projets IA sans se faire balader par le jargon.
- Équipes marketing, sales ou support qui veulent gagner du temps avec l’IA.
- Profils business et consultants qui doivent identifier des cas d’usage réalistes.
- Personnes qui veulent améliorer leur productivité sans devenir développeur.
| À apprendre ici | Bases IA, machine learning, IA générative, usages au travail |
| Niveau | Débutant absolu |
| Résultat attendu | Comprendre les usages, les limites et les risques |
Cette première brique suffit pour prendre du recul. Après ça, on peut aller vers des sujets plus avancés comme les prompts sérieux, le RAG, les agents ou l’audit de systèmes IA, avec une base beaucoup plus saine.
Comment apprendre en construisant vite ?
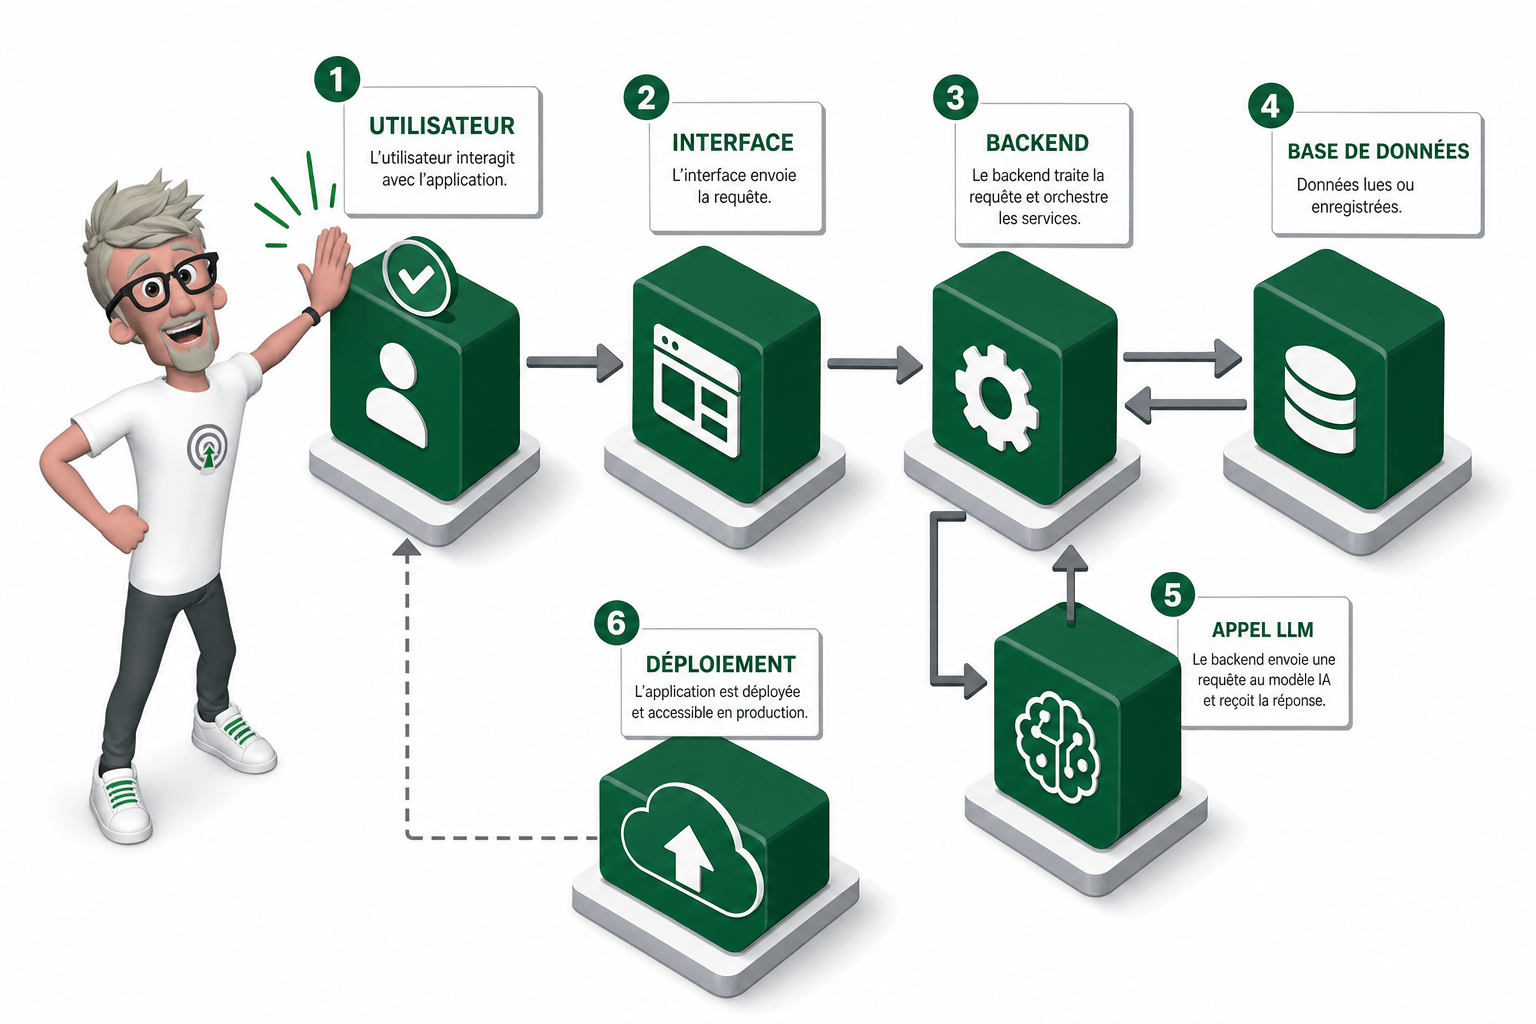
Pour apprendre les LLMs sans rester coincé dans la théorie, je passerais assez vite sur Easy-Vibe AI Coding Guide from Scratch. Là, on sort du mode spectateur. On commence à construire. Une interface, un backend, une base de données, un appel à un modèle, un petit déploiement. C’est souvent là que les déclics arrivent.
Le vibe coding, pour moi, c’est une approche très utile quand vous voulez aller vite avec l’IA. Vous décrivez ce que vous voulez, l’IA vous aide à générer, corriger, brancher, tester. Ça marche très bien pour sortir un prototype en quelques heures ou quelques jours. Une app interne, un assistant métier, une interface simple branchée sur une base de connaissances, ou un workflow IA un peu plus ambitieux.
Mais il faut être clair. Vite ne veut pas dire solide. J’ai vu ça plusieurs fois en entreprise. Le POC impressionne tout le monde le lundi, et le jeudi il bloque parce que personne n’a pensé aux logs, aux erreurs, aux droits utilisateurs, à la qualité des données ou au coût des appels LLM. Un frontend joli ne remplace pas un backend. Une base de connaissances ne garantit pas une bonne réponse. Un déploiement ne veut pas dire que c’est prêt pour de vrais utilisateurs.
| Brique | Rôle |
| Utilisateur | Pose une question ou lance une action |
| Interface | Récupère la demande et affiche la réponse |
| Backend | Contrôle la logique, la sécurité, les appels externes |
| Base de données | Stocke les contenus, historiques, retours utilisateurs |
| Appel LLM | Génère une réponse ou exécute une tâche assistée |
| Déploiement | Rend l’outil accessible, mais pas forcément prêt en production |

Un mini squelette peut suffire pour comprendre la logique. L’idée n’est pas de maîtriser toute la syntaxe, mais de voir où chaque brique se branche.
// Serveur minimal côté backend
// Reçoit une question, appelle un LLM, stocke le retour

app.post("/ask", async (req, res) => {
  const question = req.body.question;

  // Appel au modèle avec le contexte utile
  const answer = await callLLM({
    prompt: question,
    context: await searchKnowledgeBase(question)
  });

  // Stockage pour améliorer le produit ensuite
  await saveFeedback({
    question,
    answer,
    createdAt: new Date()
  });

  res.json({ answer });
});
Ce cours parle surtout à ceux qui veulent produire quelque chose. Créateurs de produits, freelances, fondateurs, profils hybrides, équipes métier un peu techniques. Il prépare aussi très bien aux sujets RAG et agents, parce qu’on voit déjà comment les briques se connectent entre elles.
- Ce cours aide à passer de l’idée au prototype
- Il convient aux créateurs de produits, freelances, fondateurs et profils hybrides
- Il prépare bien aux sujets RAG et agents, parce qu’on voit déjà comment les briques se connectent
Quand creuser vraiment les LLMs ?
Je creuserais vraiment les LLMs au moment où les usages simples et les prototypes commencent à montrer leurs limites. Tant qu’on teste une idée avec une API, un bon prompt et deux documents, pas besoin de partir trop loin. Mais dès que les réponses deviennent instables, que le coût monte, que la qualité varie selon les cas, là il faut comprendre ce qu’il se passe sous le capot.
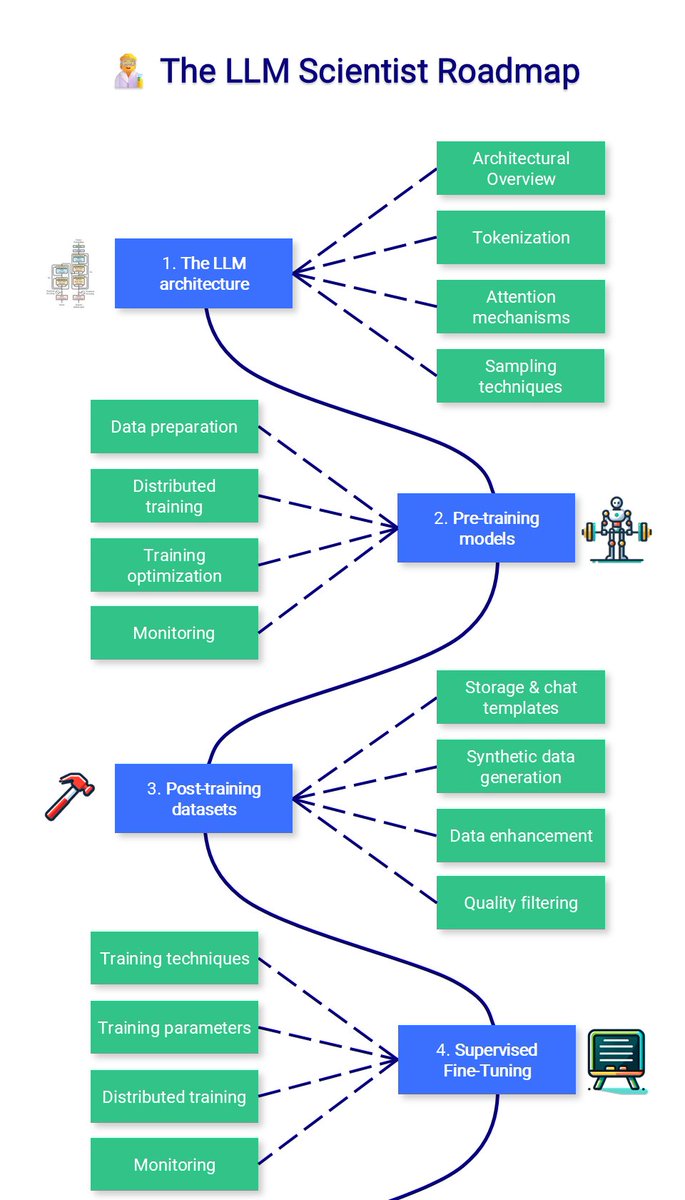
Le LLM Course de Maxime Labonne devient très intéressant à ce moment-là. Il est plus technique que les ressources d’introduction, et c’est justement son intérêt. Il ne sert pas juste à apprendre à appeler un modèle via une API. Il aide à comprendre comment fonctionnent les grands modèles de langage, pourquoi ils se trompent, comment les adapter, comment les évaluer, et comment éviter les décisions techniques un peu bancales.
Le cours est structuré en trois grands blocs. Les fondamentaux posent les bases théoriques, avec les Transformers, la tokenisation et les embeddings. Un Transformer, pour faire simple, c’est l’architecture qui permet au modèle de gérer le contexte et les relations entre les mots. La tokenisation découpe le texte en petits morceaux compréhensibles par le modèle. Les embeddings transforment ces morceaux en vecteurs, donc en représentations numériques exploitables.
La partie scientist va plus loin sur les données, l’entraînement, le fine-tuning et l’évaluation. Le fine-tuning consiste à réentraîner un modèle sur un jeu de données spécifique pour l’adapter à un usage précis. Mais ça ne marche pas par magie. Si les datasets sont mauvais, mal nettoyés ou mal choisis, le résultat sera mauvais aussi. La partie engineer rapproche tout ça du réel : quantization, déploiement, coût, latence, performance. La quantization, c’est une technique qui réduit la taille du modèle pour le rendre plus léger, souvent avec un compromis sur la qualité.
Je le vois souvent en projet IA. Les erreurs viennent rarement d’un seul mauvais prompt. Elles viennent plutôt d’un mauvais choix de modèle, d’une donnée faible, d’un manque d’évaluation, ou d’une architecture bricolée trop vite. Ce cours aide à mettre des mots, des méthodes et des critères derrière ces problèmes.
| Profil cible | Développeur, data scientist, ingénieur IA, profil technique motivé |
| Notions fortes | LLMs, fine-tuning, quantization, datasets, évaluation, déploiement |
| Pourquoi le suivre | Comprendre les modèles en profondeur et faire de meilleurs choix techniques |
Quel cours pour passer en production ?
Pour passer en production, je choisirais LLM Zoomcamp de DataTalks.Club. C’est le cours que je placerais après les bases et les premiers prototypes, quand on a déjà compris ce qu’un LLM peut faire, mais qu’on veut arrêter de bricoler une démo fragile.
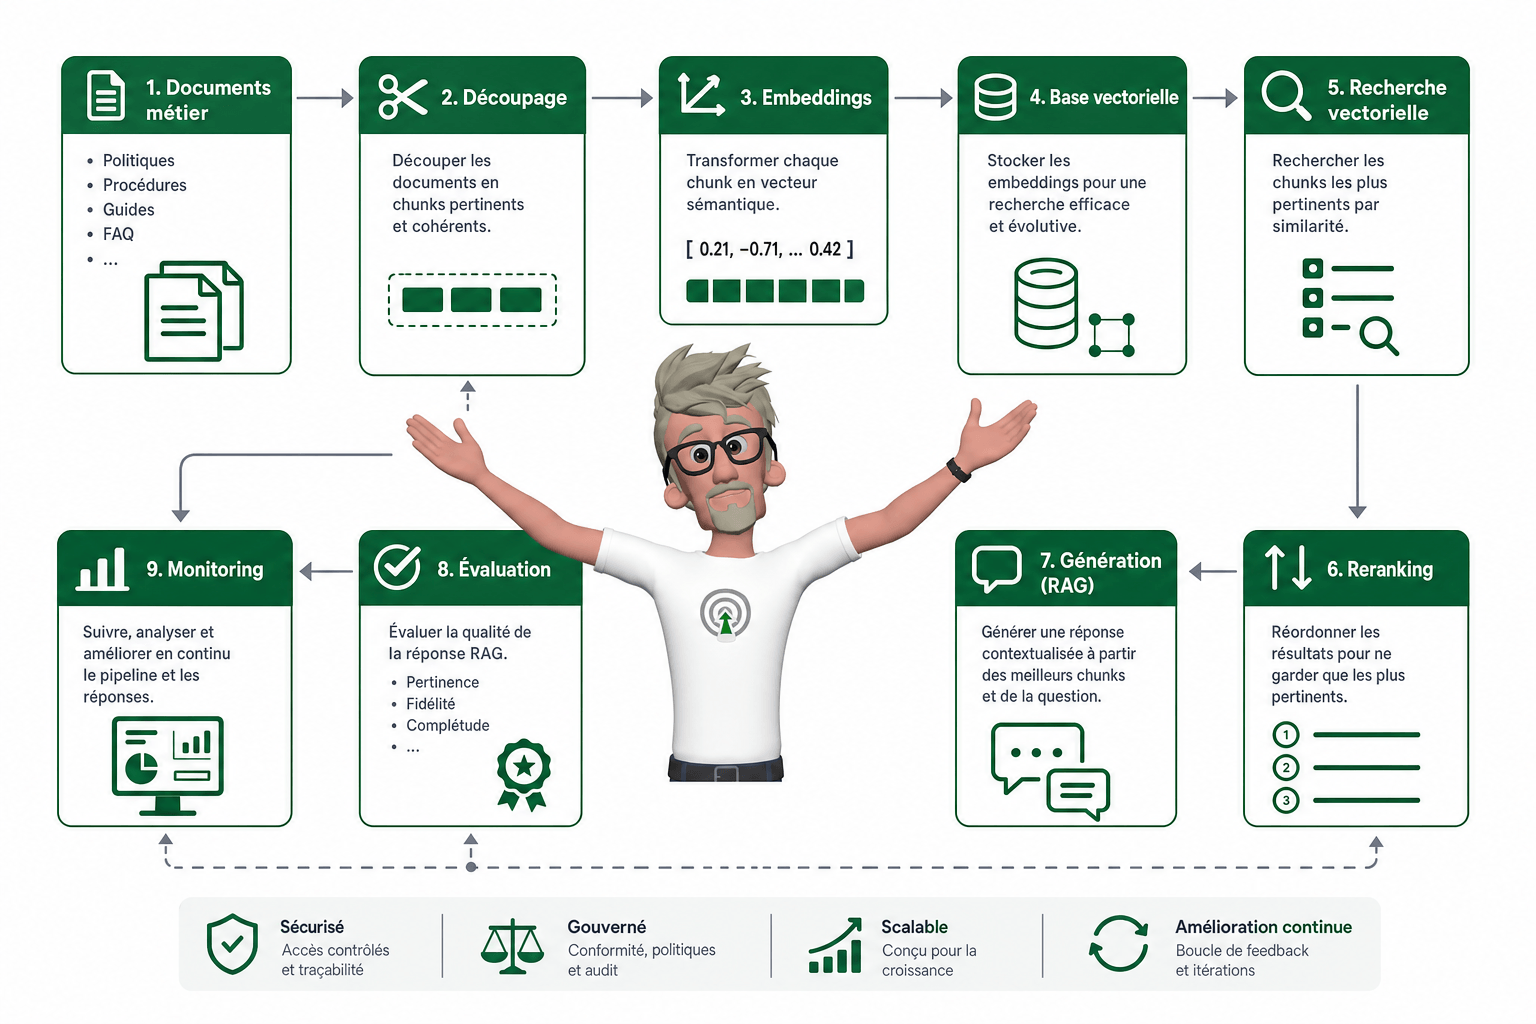
Le vrai intérêt du cours, c’est sa progression pratique sur plusieurs semaines. On avance vers un assistant IA utilisable dans un contexte réel, avec des données métier, des contraintes de qualité, et des cas qui ne rentrent pas toujours proprement dans les exemples de départ. Et c’est là que les sujets sérieux arrivent.
- RAG pour connecter le modèle à des connaissances fiables.
- Recherche vectorielle pour retrouver les bons passages dans vos documents.
- Embeddings pour transformer du texte en représentation numérique exploitable par une machine.
- Reranking pour remettre les meilleurs résultats en haut avant de répondre.
- Agents et function calling pour déclencher des actions, appeler une API, créer un ticket, chercher une donnée.
- Évaluation et monitoring pour savoir si le système tient dans la durée.
Le RAG, c’est assez simple dans l’idée. Au lieu de demander au modèle de répondre depuis sa mémoire, on lui donne les bons documents au bon moment. La recherche vectorielle sert à trouver les contenus proches de la question de l’utilisateur. Les embeddings permettent de comparer le sens des textes, pas juste les mots exacts. Le reranking affine encore le tri, parce que les premiers résultats ne sont pas toujours les meilleurs. J’ai vu ça chez un client sur une base documentaire RH, sans reranking l’assistant répondait souvent avec le bon thème, mais pas le bon document.
Le flux technique ressemble souvent à ça, même si le code exact dépendra de votre stack, LangChain, LlamaIndex, PostgreSQL avec pgvector, Qdrant, Weaviate ou autre.
# Charger les documents métier
documents = load_documents("docs/")

# Découper les documents en passages courts
chunks = split_into_chunks(documents)

# Créer des embeddings pour chaque passage
vectors = embedding_model.embed(chunks)

# Stocker les passages dans une base vectorielle
vector_db.upsert(chunks, vectors)

# Récupérer les passages les plus proches de la question
question = "Quelle est la politique de remboursement ?"
results = vector_db.search(embedding_model.embed(question), top_k=10)

# Réordonner les résultats pour garder les plus pertinents
best_context = reranker.rank(question, results, top_k=3)

# Générer une réponse basée sur les passages récupérés
answer = llm.generate(question=question, context=best_context)

# Évaluer simplement la réponse
score = evaluator.check_relevance(question, answer, best_context)
L’évaluation et la surveillance sont souvent oubliées, alors que c’est là que la production commence vraiment. Un assistant IA peut marcher sur cinq tests et se casser dès que les vrais utilisateurs arrivent. Il faut mesurer la qualité, suivre les erreurs, repérer les réponses faibles, surveiller les coûts et améliorer le système progressivement. Sans ça, on n’a pas un produit IA. On a une démo qui espère avoir de la chance.
Faut-il apprendre les agents IA maintenant ?
Les agents IA, je les apprendrais maintenant seulement si les bases sont déjà là. Si vous comprenez ce qu’est un LLM, comment marche un workflow, comment appeler une API et pourquoi le RAG existe, alors oui, ça vaut le coup. Je compléterais clairement la sélection avec le cours gratuit AI Agents Course de Hugging Face, parce qu’il pose bien les choses : agents, outils, frameworks, logique d’action.
Un agent IA ne se limite pas à répondre à une question comme un chatbot classique. Il peut décider d’une action, appeler un outil, consulter une base documentaire, exécuter une fonction, puis revenir avec une réponse. C’est là que ça devient intéressant. Et aussi là que ça devient dangereux si c’est mal cadré.
Le RAG, pour rappel, c’est le fait de connecter un modèle à des sources externes pour améliorer ses réponses. Une API, c’est une porte d’entrée technique pour faire communiquer deux systèmes. Avec les agents, on ajoute une couche au-dessus : le modèle ne fait plus que générer du texte, il choisit quoi faire avec les capacités qu’on lui donne.
C’est puissant, mais ça demande du contrôle. Sinon vous créez vite une boîte noire qui agit trop vite, mal, ou sans garde-fou. J’ai déjà vu des prototypes agents très impressionnants en démo, puis beaucoup moins rassurants dès qu’on demande : “Comment on teste ça ? Qui valide l’action ? Qu’est-ce qui se passe si l’outil répond n’importe quoi ?”
L’intérêt pédagogique de ce cours, c’est de comprendre plusieurs choses concrètes :
- Comment un modèle raisonne avec des outils disponibles.
- Comment on définit ce qu’il a le droit de faire.
- Comment on encadre les actions sensibles.
- Pourquoi l’orchestration devient centrale dès qu’il y a plusieurs étapes.
Dans la progression, je le vois comme une couche supplémentaire. DataCamp donne la culture générale. Easy-Vibe aide à prototyper. Maxime Labonne apporte la profondeur LLM. LLM Zoomcamp pousse vers la production. Les agents ajoutent la couche action.
Je ne commencerais pas par là si les bases RAG, API, données et évaluation ne sont pas solides. Les agents donnent une impression de magie. En entreprise, ils doivent surtout être observables, testables, limités et auditables.
| À apprendre | Agents IA, outils, orchestration, actions, workflows autonomes |
| Bon moment | Après les bases LLM, RAG et API |
| Bénéfice | Créer des systèmes IA capables d’agir, pas seulement de répondre |
Et maintenant vous commencez par quoi ?
Je ne choisirais pas ces cours au hasard. Je partirais de votre niveau réel. Si vous découvrez l’IA, commencez par les bases et les usages au travail. Si vous aimez construire, passez vite au prototypage. Si vous êtes développeur ou profil data, creusez les LLMs, le fine-tuning, le RAG, l’évaluation et la production. Les agents viennent après, quand les fondations sont propres. Le bon parcours, c’est celui qui vous évite de bricoler sans comprendre. Vous gagnez du temps, vous choisissez mieux vos outils, et vous construisez des systèmes IA plus utiles pour votre business.
FAQ
- Quel cours gratuit choisir pour débuter en IA et LLMs ?
Je commencerais par un cours généraliste comme Introduction to AI for Work de DataCamp. Il pose les bases de l’IA, du machine learning et de l’IA générative avec un angle professionnel. C’est plus utile que de commencer directement par le fine-tuning ou les Transformers si vous n’avez pas encore le vocabulaire. - Faut-il savoir coder pour apprendre les LLMs ?
Pas au début. Vous pouvez comprendre les usages, les risques, les prompts et les grands concepts sans coder. Par contre, pour construire des applications LLM, utiliser le RAG, brancher des API ou mettre un assistant en production, le code devient vite nécessaire. - Quelle est la différence entre prompt, RAG et fine-tuning ?
Le prompt guide la réponse du modèle. Le RAG ajoute des documents ou données externes au moment de la requête. Le fine-tuning modifie le comportement du modèle avec un entraînement complémentaire. Dans beaucoup de projets business, je teste d’abord le prompt et le RAG avant de penser au fine-tuning. - Quel cours suivre pour créer un assistant IA en production ?
LLM Zoomcamp de DataTalks.Club est très adapté pour ça. Il couvre les briques importantes : RAG, embeddings, recherche vectorielle, agents, function calling, évaluation, monitoring et reranking. C’est exactement le type de progression utile quand on veut sortir du simple prototype. - Les agents IA sont-ils utiles pour une entreprise ?
Oui, mais seulement si le cadre est solide. Un agent IA peut appeler des outils, exécuter des actions et orchestrer un workflow. C’est puissant pour automatiser des tâches, mais il faut des garde-fous, des logs, de l’évaluation et des limites claires. Sinon, on ajoute surtout du risque.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. Avec webAnalyste et Formations Analytics, j’accompagne des équipes qui veulent passer des idées IA aux systèmes fiables, mesurables et utiles. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez structurer vos projets IA, automatiser vos workflows ou former vos équipes, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.