





Un service, deux boîtes partagées, des demandes qui arrivent toute la journée. Le suivi tient dans la mémoire de trois personnes, et il s’arrête le jour où l’une d’elles part en congé. Un e-mail n’a ni responsable, ni échéance, ni statut : trois propriétés qu’un outil de gestion doit garantir et qu’aucun client de messagerie ne fournit. GMA existe pour faire cette conversion, et l’intérêt n’est pas la lecture automatique du courrier — c’est l’état d’avancement qu’on arrive à maintenir après.
Besoin d'aide ? Découvrez les solutions de notre agence n8n.
J’ai construit GMA pour une raison précise : dans une PME ou une ETI multi-sites, les demandes arrivent dans des boîtes partagées et nominatives, se mélangent dans le même fil, et le suivi tient dans la tête de deux ou trois personnes. Ce qui suit décrit la mécanique réelle, les points où elle casse, et ce que ça change concrètement dans une semaine de travail — sans la brochure.
- Pourquoi une boîte mail ne pilote pas l’activité ?
- Comment GMA transforme un message en affaire suivie ?
- Que fait GMA quand l’IA n’est pas sûre d’elle ?
- Pourquoi l’architecture pèse plus que le modèle ?
- Combien de temps avant que ça tourne ?
- À qui GMA ne sert à rien ?
- Faut-il automatiser les règles ou l’IA en premier ?
Pourquoi une boîte mail ne pilote pas l’activité ?
Parce qu’un message est un document de communication, pas un objet de gestion. Il ne porte pas d’identifiant stable, il n’a pas de propriétaire unique, et son état se déduit d’une lecture humaine du fil. Un outil de suivi, lui, repose sur trois garanties : un objet identifiable, un responsable nommé, une date d’échéance. La messagerie ne fournit aucune des trois, et ce n’est pas un défaut de conception : ce n’est pas son travail.
Le problème devient visible quand la boîte est partagée. Un même fil mélange un litige client, une relance de facture et une question de sécurité chantier. Trois sujets, trois responsables, trois échéances, un seul objet e-mail. Personne ne peut dire, sans ouvrir le fil et le relire, où en est la facture. Dans une organisation multi-sites, la même affaire se répartit entre la boîte du conducteur de travaux, celle du service achats et une adresse générique : l’historique est complet quelque part, mais fragmenté partout.

Ce qui se passe ensuite est prévisible. Les demandes sans responsable explicite disparaissent des radars jusqu’à ce que le client rappelle. Les relances se font de mémoire, donc de manière inégale selon la charge du moment. Les urgences se repèrent à l’intonation du dernier mail, pas à une règle. Et le départ d’un collaborateur emporte avec lui la connaissance de ce qui était en attente chez qui.
Comment GMA transforme un message en affaire suivie ?
En cinq opérations successives : ingérer le message, le découper en sujets distincts, rattacher chaque sujet à une affaire existante, attribuer un responsable unique, puis tenir l’échéance et préparer la réponse. L’ordre compte : sauter le découpage ou le rattachement produit un outil qui range des e-mails au lieu de suivre des affaires.
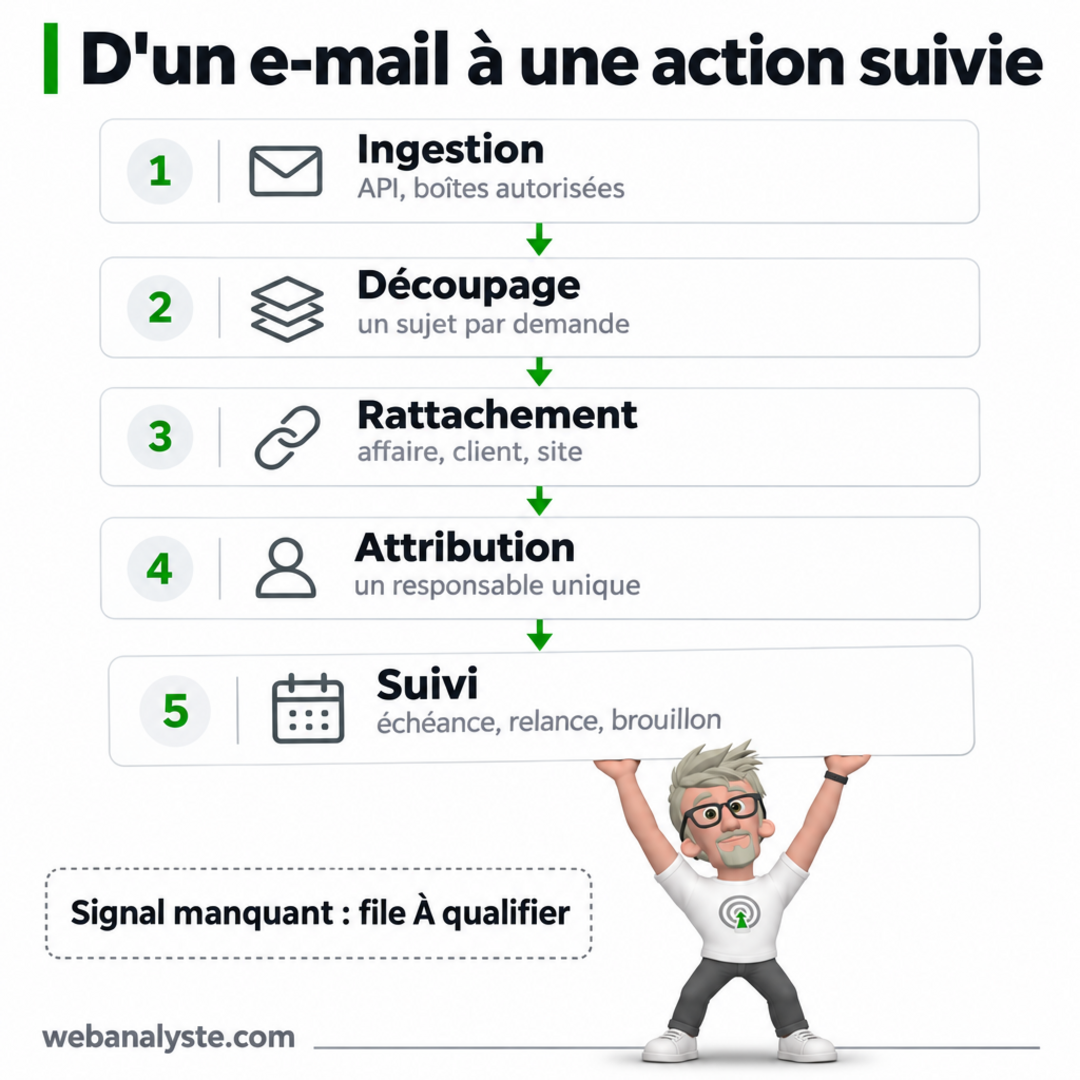
L’ingestion passe par les API, jamais par un accès global à la boîte
GMA se connecte aux boîtes explicitement autorisées via Microsoft Graph pour Microsoft 365 et Exchange, via l’API Gmail pour Google Workspace, et par API dédiées ou IMAP pour les autres environnements. La lecture des messages existants se fait en lecture seule, l’écriture est limitée à la création de brouillons. Une entreprise qui connecte trois boîtes partagées n’expose pas les cent cinquante autres.
Cette limite n’est pas un détail d’implémentation : elle est structurante. Microsoft Graph applique des limites de débit et renvoie un code 429 avec un en-tête Retry-After quand elles sont dépassées ; pour l’extraction en masse, Microsoft renvoie vers Graph Data Connect plutôt que vers les API REST classiques. Autrement dit : un agent qui interroge la boîte en boucle finira par être coupé. GMA travaille par abonnements et par reprise sur curseur, avec une déduplication en base : un redémarrage ne retraite pas ce qui a déjà été traité, et une interruption ne crée pas de trou.
Les quotas Gmail donnent la mesure du sujet. La documentation officielle fixe 6 000 unités de quota par minute et par utilisateur ; un messages.get en consomme 20, et 60 en format complet, un drafts.create 10. Relire 500 messages en format complet pour reconstruire un contexte coûte donc 30 000 unités, soit cinq minutes de quota plein pour un seul utilisateur. Un rattrapage naïf sature le quota de la boîte qu’il est censé aider. C’est le genre de détail qui décide si le système tient à l’échelle d’un service ou seulement d’une démonstration.
Un message contient plusieurs demandes, GMA les sépare
C’est l’étape que les outils de tri automatique ratent. Un modèle à qui l’on demande de « classer » un e-mail rend une étiquette ; le même e-mail peut contenir une demande de devis urgente, une validation de plan et une question RH sur un salarié. GMA identifie chaque sujet, l’analyse séparément — type de demande, contexte, urgence, échéance — et extrait les informations utiles des pièces jointes, notamment les courriers numérisés qui entrent dans le même circuit.

Chaque proposition conserve ses éléments sources : le message, la phrase, la pièce jointe qui la justifie. Sans ce lien, une proposition d’IA n’est pas vérifiable, donc pas utilisable sur une affaire réelle.
Le rattachement se fait sur des référentiels, pas sur une intuition
Une affaire se reconnaît à un numéro, un nom de client, un site, un projet ou un fil de discussion déjà connu. GMA s’appuie sur les référentiels internes de l’entreprise — et pas sur la seule mémoire du modèle. C’est ce qui permet de regrouper des communications arrivées dans trois boîtes différentes sous une seule fiche d’affaire.
Quand aucun signal fiable n’existe, le système ne devine pas. Il bascule en qualification humaine. C’est la différence entre un outil qui se trompe silencieusement et un outil qui pose la question au bon moment.
Chaque action a un responsable unique, jamais un service
« Le service technique » n’est pas un responsable : c’est une file d’attente. GMA attribue en fonction des rôles métier déclarés — responsable d’affaire, qualité, comptabilité, direction — et gère les absences, délégations et remplacements. Les attentes envers des tiers — client, fournisseur, sous-traitant, administration — sont suivies comme des objets à part entière, avec leur propre échéance.
C’est cette séparation entre « ce que je dois faire » et « ce que j’attends de quelqu’un » qui rend une relance légitime. On ne relance pas un fournisseur parce qu’on croit se souvenir qu’il devait livrer ; on le relance parce qu’une attente est enregistrée, avec une date.
Le suivi produit une synthèse quotidienne, pas une notification de plus
Chaque collaborateur reçoit une synthèse personnalisée à une heure configurable — 7 h par exemple : actions à réaliser, retards, attentes en cours, priorités du jour. Les escalades internes sont graduées, les situations critiques déclenchent une alerte immédiate, et les demandes restées sans réponse remontent d’elles-mêmes.

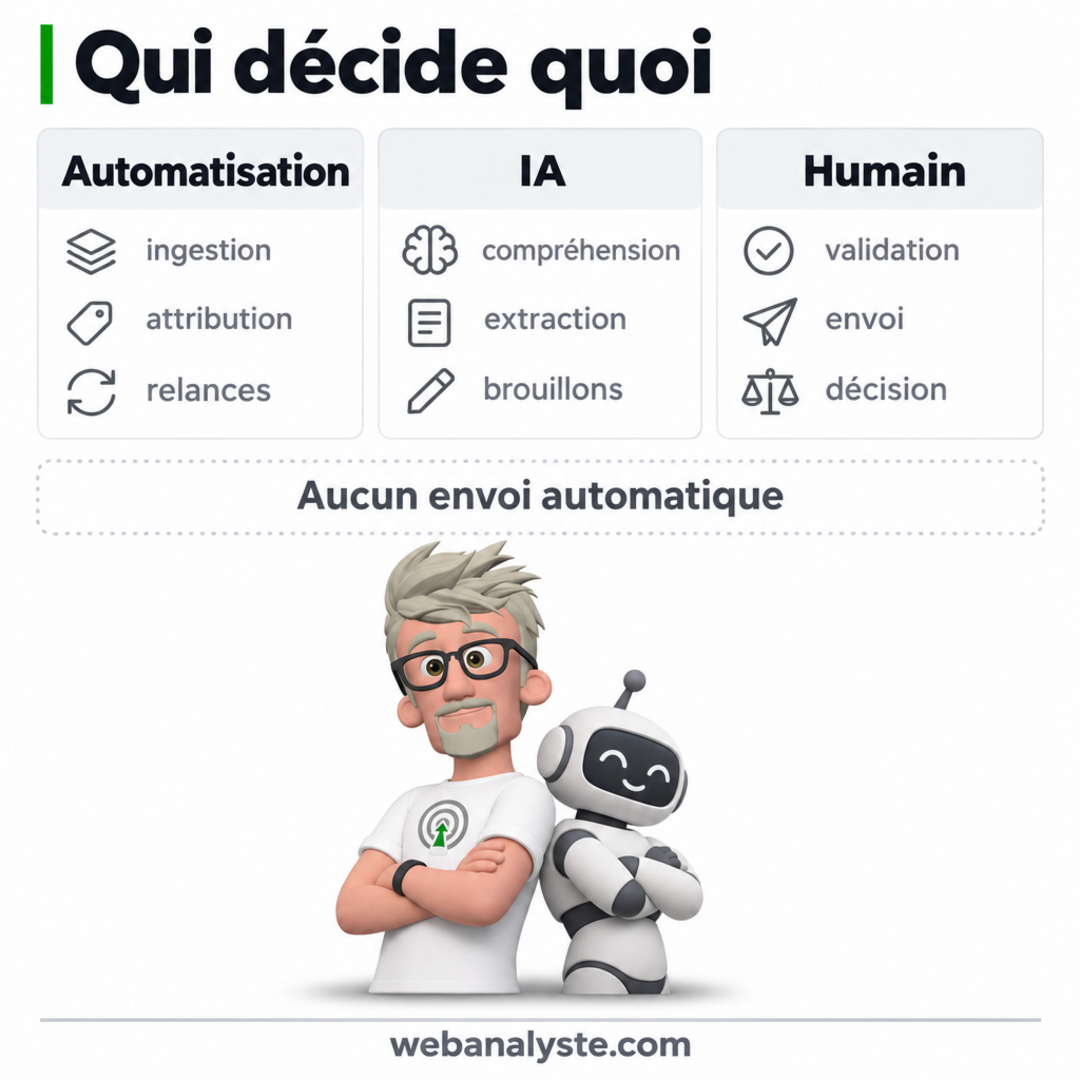
La préparation des réponses se fait dans la continuité : un brouillon rédigé à partir du contexte de l’affaire et de l’historique des échanges, créé directement dans la messagerie du collaborateur, rattaché au fil d’origine quand l’interface le permet. Rien ne part sans validation : GMA écrit, l’humain envoie.
Que fait GMA quand l’IA n’est pas sûre d’elle ?
Il ne décide pas et il ne classe pas au hasard : le message part dans une file « À qualifier », où une personne habilitée confirme, corrige ou complète la proposition. C’est un temps de travail assumé, pas un rebut : mieux vaut une file de qualification qui se vide chaque jour que des erreurs d’attribution que personne ne repère.
Un score de confiance ne suffit pas, la règle de décision est explicite
Une probabilité sortie d’un modèle n’est pas une politique. Ce qui décide du passage en automatique ou en qualification, c’est une règle configurée : un type de demande connu, un numéro d’affaire retrouvé dans le référentiel, un responsable identifiable sans ambiguïté. Si l’une des conditions manque, le sujet est qualifié à la main. Ces règles se modifient sans développeur, et chaque modification est historisée.
L’IA prépare, l’humain envoie : la séparation est technique
Aucun envoi externe automatique, aucune clôture de sujet sensible sans intervention humaine, aucune suppression de message ou de preuve. Ces règles ne sont pas des promesses commerciales : les permissions demandées aux API de messagerie sont dimensionnées pour elles — lecture des messages, création de brouillons, et rien de plus sur le chemin sortant.
Il faut ajouter un risque que les projets de ce type sous-estiment : un e-mail est une entrée non fiable. N’importe quel expéditeur peut y écrire une instruction destinée à un agent. L’injection de prompt figure en tête du Top 10 OWASP des risques LLM (2025), et la parade n’est pas un filtre de mots-clés. Elle est architecturale : le contenu d’un message ne peut jamais déclencher d’action à effet externe. Seules les règles configurées et validées par un humain produisent un effet.
La traçabilité sert à améliorer les règles, pas à se couvrir
Chaque action, validation, correction et décision est historisée avec son auteur et son horodatage. Les corrections apportées aux propositions de l’IA sont conservées, ce qui donne une mesure directe de la qualité du traitement automatique et une matière pour ajuster les instructions. Le même journal sert aux audits qualité, sécurité et conformité, et il existe en cas de litige. Un audit trail n’a de valeur que s’il est lisible par celui qui doit décider, pas seulement exportable : c’est le sujet de mon article sur l’audit des workflows IA.
Le RGPD impose une base, pas seulement un cloisonnement
Une boîte mail professionnelle contient des données personnelles : clients, salariés, candidats. GMA cloisonne les informations par société, service, affaire et niveau d’habilitation, restreint l’accès aux sujets RH, juridiques ou financiers, et permet d’exclure certaines catégories de messages du traitement par l’IA. Le règlement (UE) 2016/679 demande en plus une base légale et une minimisation : on ne traite que ce qui est nécessaire à la finalité. Concrètement, cela se traduit par un périmètre de boîtes limité, une durée de conservation définie, et un traitement des messages hors périmètre qui ne part jamais vers un modèle.
L’article 22 du règlement encadre les décisions entièrement automatisées produisant des effets juridiques. Router une demande interne vers un responsable n’en relève pas toujours, mais la conception retenue — aucune décision métier laissée à l’IA, validation humaine sur tout ce qui engage l’entreprise — garde la marge de manœuvre intacte, y compris si l’usage s’étend.
Pourquoi l’architecture pèse plus que le modèle ?
Parce que les pannes d’un tel système viennent rarement du modèle. Elles viennent des quotas, des doublons, des reprises après incident, des permissions trop larges et des référentiels absents. La qualité du LLM déplace le taux de qualification manuelle de quelques points ; une plomberie mal conçue empêche purement et simplement la mise en production.
n8n auto-hébergé pour l’orchestration, avec des workers séparés
Les traitements sont orchestrés dans n8n en mode queue : le processus principal distribue les tâches, des workers exécutent, Redis fait la file. Un pic de messages ne bloque pas l’interface, et un worker qui tombe ne perd pas le lot en cours. C’est aussi ce qui rend l’automatisation lisible pour l’équipe technique du client : les flux sont des objets modifiables, pas une boîte noire. Si vous hésitez encore sur l’outil d’orchestration, j’ai comparé les plateformes dans ce comparatif des plateformes d’automatisation.
PostgreSQL porte les données et les permissions
Le cloisonnement n’est pas un filtre appliqué dans l’interface React : il est appliqué par la base, via des politiques de sécurité au niveau des lignes (Row Level Security sur PostgreSQL / Supabase). Un utilisateur qui contourne l’interface ne lit pas les affaires d’une autre société. L’authentification passe par le fournisseur d’identité de l’entreprise — Microsoft Entra ID, Google Workspace ou tout fournisseur compatible OpenID Connect — donc les départs et les changements de rôle se répercutent sans gestion de comptes parallèle.
Le fournisseur de modèle est un paramètre, pas une fondation
OpenAI, Anthropic, Google, Mistral AI ou un fournisseur interne : le modèle se choisit dans la configuration, par usage, et se remplace. Ce n’est pas de la modularité décorative. Une entreprise qui doit garder ses données dans l’Union européenne, ou qui veut un modèle hébergé chez un prestataire précis, ne doit pas avoir à reconstruire l’application pour changer d’avis. Les prompts, les règles métier et les référentiels vivent en base : ils survivent au changement de modèle.
Hébergement dans l’UE et réversibilité, ce que ça implique
Conteneurs Docker sur des serveurs hébergés dans l’Union européenne, infrastructure et comptes au nom du client, sauvegardes chiffrées, données exportables. La réversibilité n’est pas une clause de sortie : c’est la possibilité de remplacer un composant — orchestrateur, base, fournisseur de modèle — sans reconstruire l’ensemble. Sur des sujets où l’on confie son courrier à un système, cette propriété compte autant que la performance du modèle. Le coût réel de ce type de dispositif, une fois la reprise humaine et l’exploitation comptées, est détaillé dans mon analyse du coût d’un agent en production.
Combien de temps avant que ça tourne ?
Le déploiement se fait par lots, avec un pilote sur un périmètre restreint avant toute généralisation. Il n’y a pas de durée standard : elle dépend du nombre de boîtes, de la qualité du référentiel d’affaires et de la clarté des règles d’attribution. Ce qui est standard, c’est la séquence.
Le cadrage porte sur les règles, pas sur les fonctionnalités
Cadrage des besoins, des responsabilités et des règles métier ; identification des sources de données et des environnements de messagerie ; configuration des intégrations. Les questions qui prennent du temps ne sont pas techniques : qui est responsable d’une demande de devis entrante un vendredi à 17 h ? Qui remplace le responsable qualité absent ? À partir de quel montant une validation à deux niveaux s’applique ? Si ces réponses n’existent pas, l’IA les inventera mal.
La recette se fait sur des cas fictifs, puis sur des affaires réelles
On rejoue des cas représentatifs — message multi-sujets, pièce jointe scannée, affaire sans numéro, expéditeur inconnu — avant de brancher une boîte de production. Puis on expérimente sur un service avec de véritables affaires, en mesurant. Un pilote qui ne mesure rien n’est pas un pilote, c’est une démonstration prolongée.
Trois indicateurs suffisent pour décider de généraliser
Le délai entre l’arrivée d’une demande et sa première prise en charge ; le taux de sujets qualifiés sans correction humaine ; le nombre de demandes restées sans réponse au-delà du délai fixé. Si les deux premiers s’améliorent et que le troisième baisse, l’extension se justifie. Sinon, le problème n’est pas le modèle : il est dans les règles ou dans les référentiels, et il faut le traiter là.
À qui GMA ne sert à rien ?
À une entreprise dont les demandes arrivent déjà dans un outil de ticketing correctement utilisé, et à celle qui n’est pas prête à nommer un responsable par sujet. Dans le premier cas, GMA ajoute une couche inutile ; dans le second, il produira une file « À qualifier » qui grossit, parce qu’aucune règle d’attribution ne peut être écrite sans responsable identifiable.
Il sert en revanche à celles dont l’activité opérationnelle transite réellement par la messagerie : BTP et travaux publics, industrie et maintenance, services techniques, négoce et distribution, bureaux d’études, gestion immobilière, transport et logistique, services professionnels. Le point commun n’est pas le secteur, c’est le volume de demandes entrantes non structurées et le nombre de personnes qui doivent se coordonner dessus. Le raisonnement est le même que pour une application métier sur mesure, décrit dans cet article sur les applications métier : on part du processus, pas de l’outil.
Ce que GMA ne remplace pas
La messagerie, l’ERP, la GED, le logiciel de facturation. GMA est une couche de coordination entre ces outils : il lit ce qui entre, structure ce qui doit être fait, et prépare la réponse. Il ne devient pas votre système de vérité comptable, et il ne décide pas à la place du responsable d’affaire.
| Ce qui est automatisé | Ce qui reste humain | Ce qui reste dans l’outil existant |
|---|---|---|
| Découpage en sujets et rattachement à l’affaire | Validation de la qualification et de l’attribution | Envoi des réponses, depuis la messagerie |
| Attribution selon les rôles et les délégations | Décision métier et clôture des sujets sensibles | Devis, factures, commandes, documents |
| Relances, escalades et synthèse quotidienne | Choix du fournisseur de modèle et des périmètres | Données comptables et RH de référence |
| Rédaction des brouillons de réponse | Relecture, modification, envoi | Archivage légal et GED |
Faut-il automatiser les règles ou l’IA en premier ?
Les règles. Un modèle qui comprend parfaitement un message mais ne sait pas à qui l’attribuer ne produit rien d’exploitable ; une organisation qui sait qui décide de quoi, avec un référentiel d’affaires à peu près propre, obtient un résultat mesurable même avec un modèle moyen. C’est l’ordre dans lequel j’ai construit GMA, et c’est celui que je recommande : d’abord le responsable, l’échéance et la trace, ensuite l’intelligence qui accélère le tri.
Le bénéfice n’est pas spectaculaire, il est structurel : les demandes cessent de dépendre de la mémoire de quelqu’un, les urgences remontent par règle et non par intuition, et l’absence d’un collaborateur ne bloque plus un dossier. Si vous voulez regarder ce que ça donne sur vos propres flux, prenons une heure pour cartographier vos boîtes entrantes — avant de parler d’IA.
Questions fréquentes
- GMA lit-il tous les e-mails de l’entreprise ?
Non. Seules les boîtes explicitement autorisées sont connectées, en lecture seule pour les messages existants, avec un droit d’écriture limité à la création de brouillons. Le périmètre est configurable et les catégories de messages exclues du traitement par l’IA sont définies par l’entreprise. - Peut-on connecter Microsoft 365 et Gmail en même temps ?
Oui. GMA est indépendant de l’éditeur de messagerie : Microsoft Graph, API Gmail, API dédiées ou IMAP selon les fonctionnalités disponibles. Une affaire peut être suivie alors que ses messages arrivent dans deux environnements différents. - Où passent les données et qui choisit le modèle ?
L’application et sa base sont hébergées dans l’Union européenne, et le fournisseur d’intelligence artificielle est un paramètre de configuration. Le choix se fait selon les exigences de confidentialité, de localisation et de traitement ; les conditions contractuelles de chaque fournisseur se vérifient au cas par cas avant mise en production. - Que se passe-t-il si l’IA attribue un sujet au mauvais responsable ?
La correction est possible à tout moment, elle est historisée, et elle alimente la mesure de qualité du traitement automatique. Les règles d’attribution et les instructions se corrigent ensuite dans la configuration, sans intervention d’un développeur. - Faut-il changer d’outil de messagerie ou d’ERP ?
Non. GMA s’intègre aux outils existants via leurs API et ne modifie ni les interfaces ni les habitudes de travail. Il se place entre la messagerie et les logiciels métier, comme couche de coordination et de suivi.
Franck Scandolera — data engineer et développeur d’applications métier qui intègrent l’IA. Je conçois des systèmes où l’automatisation prend en charge la coordination et où la décision reste humaine, avec des architectures réversibles et hébergées en Europe.
Sources
- Microsoft, Microsoft Graph throttling guidance, documentation consultée le 19 novembre 2026. learn.microsoft.com/en-us/graph/throttling
- Microsoft, Microsoft Graph Data Connect overview, documentation consultée le 19 novembre 2026. learn.microsoft.com/en-us/graph/data-connect-concept-overview
- Google, Gmail API usage limits (quotas mis à jour au 1er mai 2026), consulté le 19 novembre 2026. developers.google.com/workspace/gmail/api/reference/quota
- Union européenne, Règlement (UE) 2016/679 (RGPD), Journal officiel de l’Union européenne. eur-lex.europa.eu/eli/reg/2016/679/oj
- OWASP, Top 10 for Large Language Model Applications, 2025. genai.owasp.org/llm-top-10
- n8n, Queue mode, documentation consultée le 19 novembre 2026. docs.n8n.io/hosting/scaling/queue-mode
- Supabase, Row Level Security, documentation consultée le 19 novembre 2026. supabase.com/docs/guides/database/postgres/row-level-security

Dev d’applications métier · Data Engineer · Automatisation IA
Clients : Logis Hôtels, Yelloh Village, BazarChic, FFF, Texdecor…
- Apps & agents IA : Node.js, Python, API, RAG, OpenAI, Mistral, Claude
- Data & Analytics Engineering : GCP, BigQuery, Snowflake, PostgreSQL, ClickHouse, dbt, Airflow, Dataform, Looker, Power BI, Metabase
- Automatisation IA : n8n, Apps Script, scraping, API, LLM
- Tracking & perf Web : GA4, GTM server, Matomo, Piano, Tealium, CAPI, Core Web Vitals