
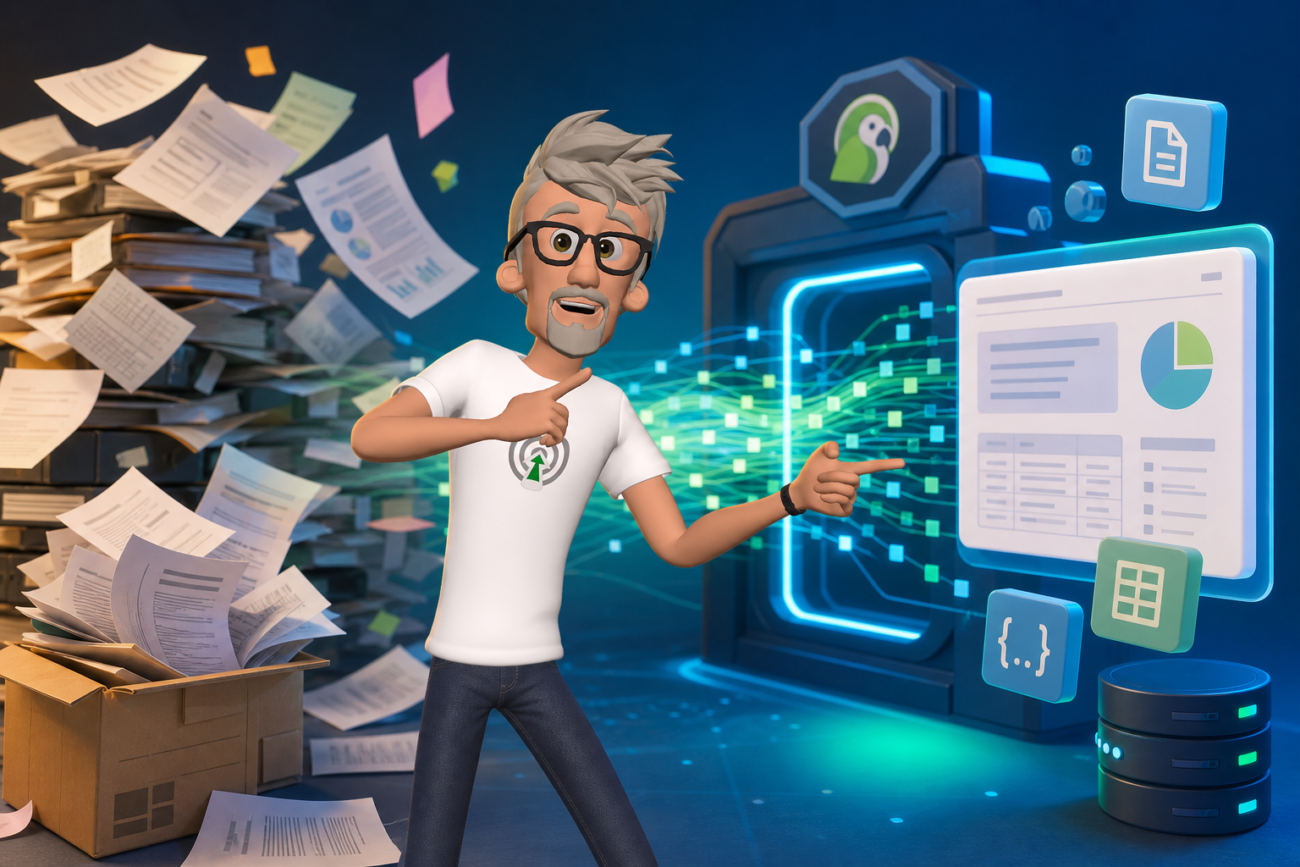





Docling convertit des documents variés en données structurées, prêtes à être lues par vos équipes ou vos systèmes d’IA. Je vous explique pourquoi l’extraction documentaire est difficile, ce que l’outil sait traiter et les prérequis à vérifier avant de commencer.
Qu’est-ce que Docling ?
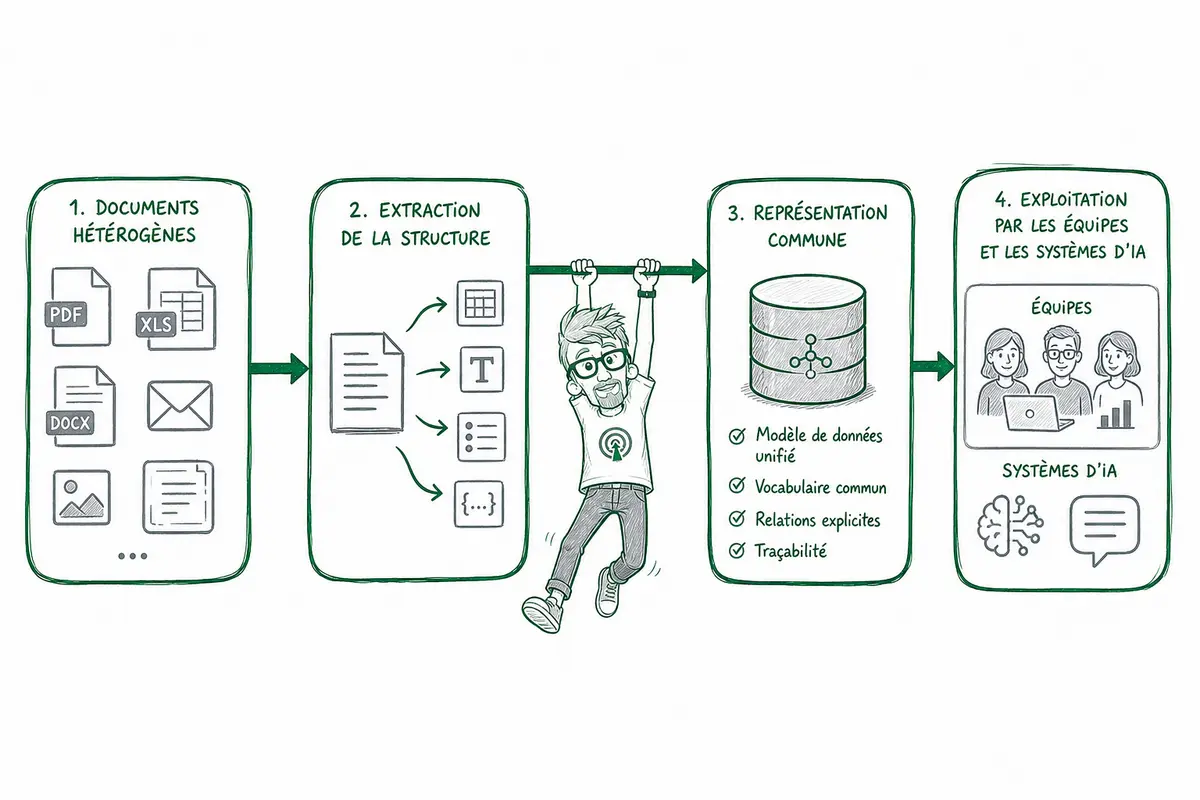
Docling est un outil open source de traitement documentaire qui convertit des documents de formats variés en une représentation structurée commune. Il a été créé au sein de l’équipe AI for Knowledge d’IBM Research Zurich. Son code est publié sous licence MIT et le projet est hébergé par la LF AI & Data Foundation.
Cette représentation commune permet de travailler avec le contenu des documents sans devoir repartir de zéro pour chaque format. Un document peut être présenté de différentes façons selon son type et l’application qui l’ouvre. Avec une structure commune, les personnes et les systèmes d’IA disposent d’un même point de départ pour consulter ou exploiter ce contenu.
Pour une personne, cette idée est assez simple : au lieu de manipuler séparément des fichiers qui n’ont pas la même forme, on peut s’appuyer sur une représentation organisée de leur contenu. Pour un système d’IA, cette représentation fournit une manière commune de recevoir des documents issus de formats différents. Elle facilite ainsi leur prise en compte dans un traitement, sans que cela signifie que tous les documents sont interprétés parfaitement ou de la même façon.
Docling se situe donc à l’étape où des documents hétérogènes deviennent des données représentées selon une forme commune. C’est un principe utile, mais il ne fait pas disparaître les difficultés de l’extraction documentaire. Les fichiers peuvent varier par leur format, leur mise en page et la façon dont l’information y est présentée. Retrouver leur contenu de manière cohérente reste un problème concret : comment distinguer ce qui est important, et comment préserver le sens de l’information quand sa présentation change ?
Pourquoi les documents sont-ils difficiles à extraire ?
Les documents, et surtout les PDF, ne conservent pas toujours une structure sémantique exploitable. Ils peuvent afficher un titre, un paragraphe ou un tableau de façon parfaitement lisible, sans préciser clairement à quel type d’élément correspond chaque zone.
Dans un PDF, le texte est souvent enregistré comme une série de blocs placés à des coordonnées précises sur la page. La position indique où se trouve un mot, mais pas nécessairement s’il appartient à un titre, à un paragraphe ou à une colonne. Une extraction simple peut alors mélanger les colonnes et produire une phrase incohérente. Dans un tableau, elle peut récupérer les valeurs sans conserver le lien entre une cellule et son en-tête. Vous obtenez les bons mots, mais plus forcément le bon sens.
Le problème est encore différent avec un document numérisé. Il s’agit alors d’une image de la page, pas de texte directement exploitable. Il faut utiliser l’OCR, la reconnaissance optique de caractères, pour convertir les caractères visibles en texte. Cette reconnaissance peut comporter des erreurs, surtout si le scan est flou, incliné ou de mauvaise qualité.
Certains éléments demandent aussi une attention particulière. Les en-têtes et les pieds de page peuvent être répétés sur chaque page et se retrouver mélangés au contenu. Les formules, les blocs de code et les légendes ont chacun une organisation propre qu’une extraction brute risque d’abîmer. J’ai déjà vu des documents où une légende se retrouvait séparée de l’image qu’elle décrivait.
C’est pour ça qu’on a besoin d’une représentation structurée, comme évoqué dans le chapitre précédent. Il ne suffit pas de récupérer du texte : il faut aussi préserver, autant que possible, l’organisation du document et les relations entre ses éléments. Sans ça, les données extraites deviennent difficiles à interpréter correctement.
Que peut traiter et exporter Docling ?
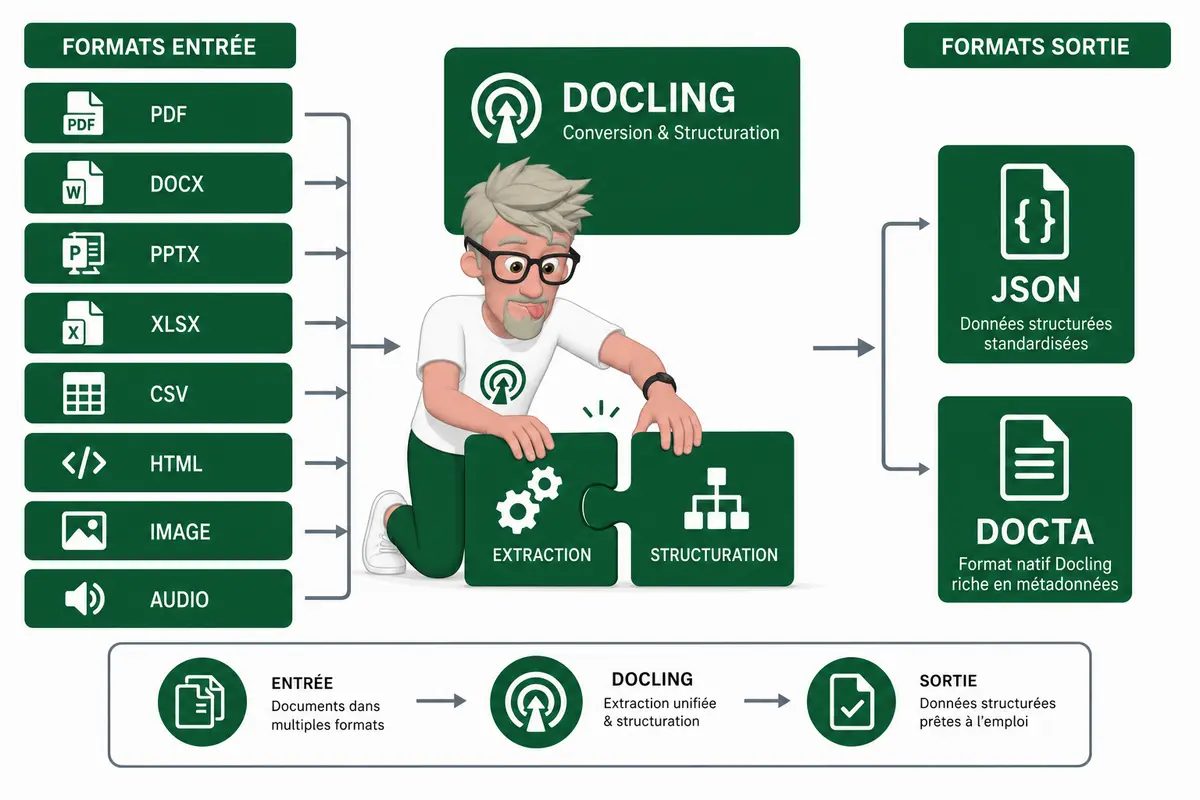
Docling prend en charge plusieurs formats d’entrée et peut produire différentes représentations en sortie. Il peut traiter des PDF, des fichiers DOCX et PPTX, du Markdown, du HTML, des classeurs XLSX et des fichiers CSV, ainsi que différents formats d’image et d’audio. Ces formats servent à fournir les documents à analyser ; ils ne correspondent pas aux formats d’export.
Lors du traitement, Docling peut reconstituer la structure du document, pas seulement en extraire le texte. Il repère notamment les paragraphes, les listes, les tableaux et leurs cellules, ainsi que les formules et les légendes. Il peut aussi conserver l’ordre de lecture et les coordonnées des éléments sur la page. Ces informations sont utiles, par exemple, pour retrouver où se trouvait un passage dans un PDF ou pour exploiter les cellules d’un tableau sans les mélanger au texte qui l’entoure.
Une fois le document analysé, vous pouvez exporter le résultat en JSON, en Doctags, en Markdown, en HTML ou en texte brut. Le JSON permet de conserver une structure exploitable par un programme. Les Doctags représentent le contenu sous une forme structurée propre à Docling. Le Markdown et le HTML sont pratiques pour relire ou publier le contenu, tandis que le texte brut convient à une extraction simple. Le niveau de détail conservé dépend du format choisi.
| Usage | Formats |
| Formats d’entrée | PDF, DOCX, PPTX, Markdown, HTML, XLSX, CSV, formats d’image et d’audio |
| Formats d’export | JSON, Doctags, Markdown, HTML, texte brut |
| Éléments détectés | Paragraphes, listes, tableaux, cellules, formules, légendes, ordre de lecture et coordonnées des éléments |
Quels prérequis faut-il pour commencer ?
Il vous faut Python 3.10 ou une version ultérieure, Pip et quelques notions de base pour lancer un script Python depuis un terminal. C’est suffisant pour commencer à utiliser Docling, sans mettre en place une infrastructure particulière.
Les modèles de base de Docling fonctionnent localement par défaut. Une fois l’outil installé et les modèles nécessaires disponibles, la conversion d’un document ne nécessite pas de clé API. Le traitement s’effectue sur votre machine, plutôt que par l’intermédiaire d’un service distant qui vous demanderait une clé.
Vous devez simplement être à l’aise avec quelques gestes courants : ouvrir un terminal, vous déplacer dans un dossier et lancer un script Python. Pas besoin d’être développeur confirmé. Si vous avez déjà suivi une commande dans un terminal ou exécuté un petit script, vous avez les bases nécessaires.
Le matériel et les contraintes de votre environnement peuvent influencer la vitesse de traitement ou la facilité d’installation, mais ils ne changent pas ces prérequis de départ. Et si vous travaillez dans un environnement où les données ne doivent pas être envoyées à un service externe, le fonctionnement local des modèles de base peut être un avantage concret. Il faut simplement vérifier que votre configuration permet de les utiliser localement.
- Python 3.10 ou ultérieur.
- Pip, l’outil qui sert à gérer les paquets Python.
- Des connaissances élémentaires pour lancer un script Python depuis un terminal.
Une fois Docling installé et les modèles disponibles, vous pouvez convertir des documents sans dépendre d’une clé API.
Alors, Docling peut-il vous aider à mieux exploiter vos documents ?
Docling transforme des documents hétérogènes en représentations structurées, ce qui aide à rendre leur contenu plus exploitable par des personnes et des systèmes d’IA. C’est utile parce qu’un PDF ne conserve pas toujours clairement ses titres, ses tableaux ou son ordre de lecture, et qu’une extraction simple peut dégrader ces relations. Docling prend en charge plusieurs formats d’entrée et propose différents formats d’export, tout en détectant des éléments comme les tableaux, les cellules et les légendes. Pour commencer, il faut Python 3.10 ou plus récent et Pip. Ses modèles de base fonctionnent localement par défaut, sans clé API pour convertir un document. Vous pouvez ainsi mieux structurer vos documents et préparer leur exploitation.
FAQ
- À quoi sert Docling ?
Docling convertit des documents de formats variés en une représentation structurée exploitable par des personnes et des systèmes d’IA. - Quels formats de documents Docling prend-il en charge ?
Les formats mentionnés comprennent PDF, DOCX, PPTX, Markdown, HTML, XLSX, CSV, ainsi que divers formats d’image et d’audio. - Quels formats Docling peut-il produire ?
Docling peut exporter les résultats en JSON, Doctags, Markdown, HTML ou texte brut. - Pourquoi extraire des données d’un PDF est-il difficile ?
Un PDF peut positionner le texte sur une page sans préserver clairement les titres, paragraphes ou relations entre cellules. Une extraction simple peut mélanger les colonnes ou perdre la structure des tableaux. Les documents numérisés nécessitent aussi de l’OCR. - Faut-il une clé API pour utiliser Docling ?
Les modèles de base fonctionnent localement par défaut. Aucune clé API n’est nécessaire pour convertir un document une fois Docling installé.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en data, IA et automatisation No/Low Code. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne des entreprises comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor sur leurs projets data et IA. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.