





Google Data Cloud étend ses capacités sur trois fronts : agents IA, données distribuées et exécution analytique. Je détaille les nouveautés de BigQuery, AlloyDB, Spanner, du lakehouse et des services de traitement, puis les déploiements clients qui montrent leurs effets en production.
Comment Google Data Cloud outille-t-il les agents IA ?
Google fournit des outils pour connecter les agents de programmation à ses services de données et intégrer des capacités adaptées aux agents dans AlloyDB. Le Data Agent Kit, gratuit et conçu par Google, regroupe des outils basés sur MCP (Model Context Protocol, un protocole qui permet aux agents d’interagir avec des outils et des services) et des compétences prédéfinies. Google annonce sa disponibilité générale du 5 au 9 octobre.
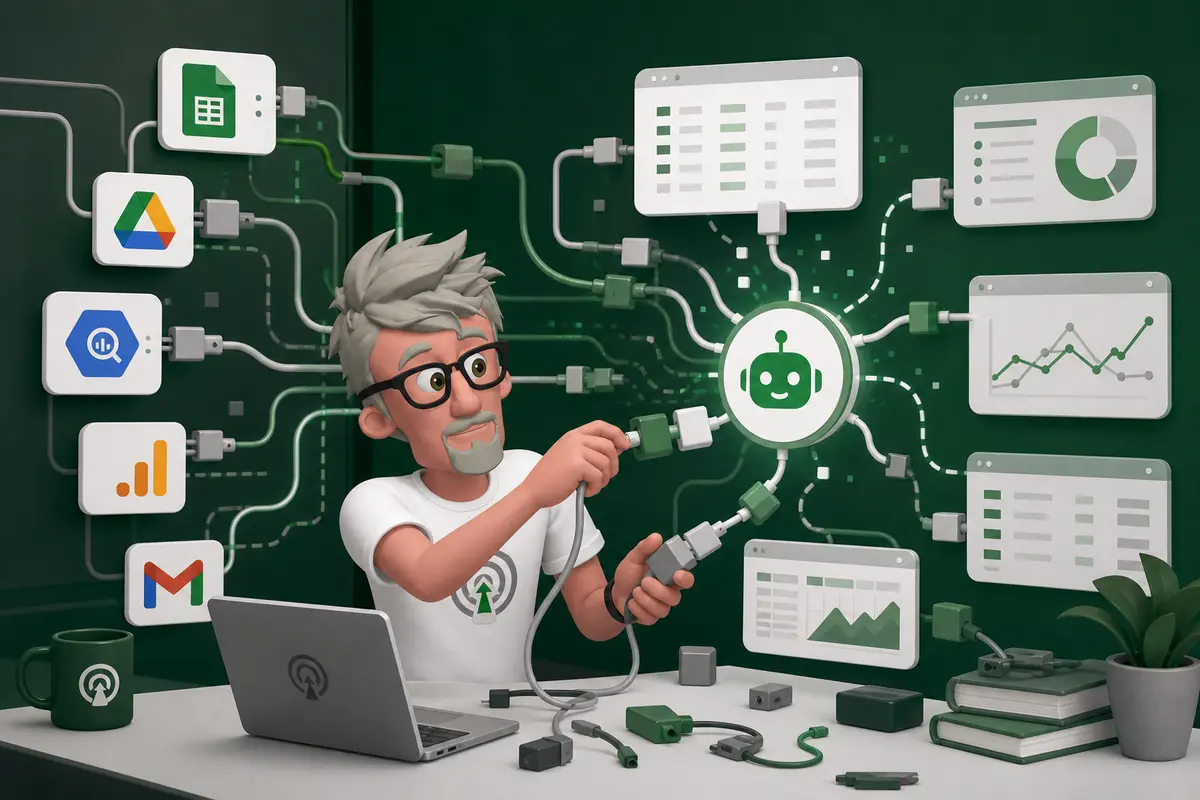
Depuis un IDE ou une interface en ligne de commande, un agent de programmation peut utiliser ce kit pour interagir avec plus de 15 services Google Data Cloud. L’objectif est de permettre aux développeurs de travailler avec ces services depuis leur environnement habituel, sans que l’annonce décrive une configuration ou une API particulière. La disponibilité générale signifie que le kit est proposé comme produit, et non en préversion.
Google présente aussi des évolutions d’AlloyDB, avec une architecture pensée pour les accès en temps réel et l’isolation des charges de travail. Cette isolation aide à éviter que différentes charges ne se perturbent mutuellement ; l’annonce ne précise pas de niveaux de performance ni de mécanisme technique particulier. Le classement BM25, fondé sur la correspondance et la fréquence des termes dans les documents, est disponible en préversion dans AlloyDB et Cloud SQL. Il permet de combiner la recherche par mots-clés avec des embeddings vectoriels, des représentations numériques utilisées pour retrouver des contenus proches par leur sens. Cette combinaison peut servir lorsque la recherche doit tenir compte à la fois de termes précis et de la similarité sémantique. BM25 reste en préversion : il ne s’agit pas d’une disponibilité générale.
Quelles évolutions pour les bases de données ?
Google renforce les options de déploiement distribué et propose des moteurs adaptés à différents types de charges. Deux évolutions concernent directement les bases de données : la disponibilité générale de Spanner Omni et celle de l’orchestrateur RPM d’AlloyDB Omni.
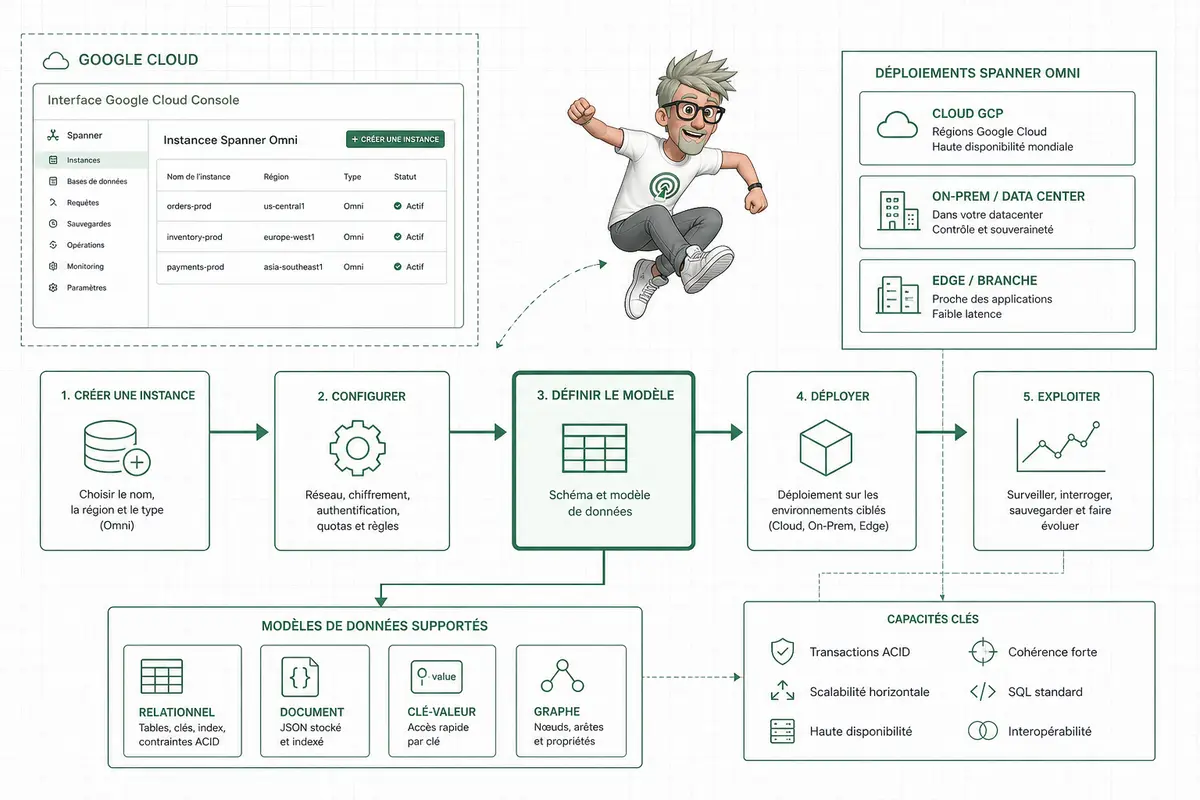
Spanner Omni est désormais disponible de façon générale. Il étend Spanner, la base SQL distribuée de Google, avec des capacités de graphe, de recherche vectorielle et de stockage clé-valeur. Ces modèles permettent de traiter plusieurs catégories de données et de charges au sein d’une même offre. Spanner Omni conserve des API et des moteurs de requête cohérents dans différents environnements. Concrètement, les équipes peuvent s’appuyer sur des interfaces et des modes d’interrogation communs lorsque leur contexte d’exécution varie, sans que cela implique une compatibilité universelle entre environnements.
AlloyDB Omni franchit aussi une étape avec la disponibilité générale de son orchestrateur RPM. RPM désigne un format de paquet logiciel utilisé sur des systèmes Linux. La disponibilité générale signifie que cette version est officiellement proposée, mais ne permet pas, à elle seule, de déduire des conditions précises de déploiement, de compatibilité ou de coût. Les informations annoncées portent sur l’orchestrateur et son format de distribution ; elles ne suffisent pas à conclure à des changements sur les performances ou les opérations quotidiennes.
Ces annonces prolongent les évolutions évoquées dans le chapitre précédent. Les capacités agentiques et la recherche hybride concernent aussi les bases de données : elles rapprochent les traitements liés à l’IA des données qu’ils exploitent. Avec Spanner Omni, les capacités SQL distribuées coexistent avec des modèles graphe, vectoriel et clé-valeur. Le point opérationnel établi est la cohérence des API et des moteurs de requête dans différents environnements. Il faut s’en tenir à ce périmètre : aucun détail supplémentaire sur la migration, la disponibilité selon les régions ou les contraintes d’exploitation n’est précisé ici.
Que changent le lakehouse et BigQuery ?
Les nouveautés portent sur deux plans : la gouvernance régionale des catalogues lakehouse et l’extension des capacités analytiques de BigQuery. Google distingue clairement les fonctionnalités disponibles de celles encore en préversion.
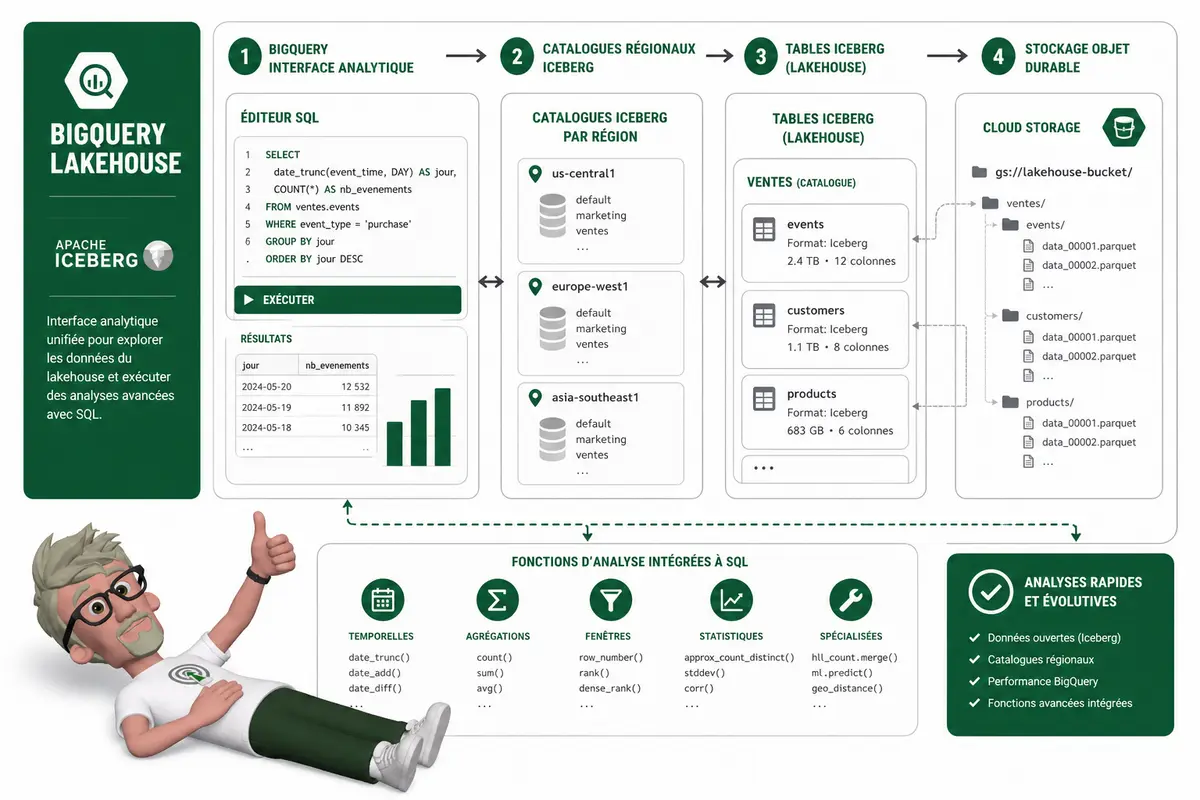
Le catalogue d’exécution Lakehouse propose des points de terminaison régionaux dans 22 régions pour les catalogues Apache Iceberg REST et Apache Hive. Ils permettent d’aligner l’accès au catalogue sur les exigences de résidence des données. Cette régionalisation concerne le point de terminaison du catalogue ; elle ne garantit pas, à elle seule, l’emplacement des données sous-jacentes.
Les niveaux de disponibilité sont différents selon les fonctions :
- Disponibles de manière générale : les tables Iceberg acceptent des noms de colonnes flexibles.
- En préversion : la mise en cache et les connexions inter-cloud.
BigQuery ajoute aussi six fonctions de table destinées à automatiser des analyses de mesures, de tendances et de motifs. Elles couvrent le diagnostic de mesures, l’analyse des tendances et la détection de motifs. Les éléments disponibles ne précisent pas le nom ni le comportement détaillé de chacune ; mieux vaut donc ne pas leur attribuer des cas d’usage individuels. Une fonction de table s’intègre à une requête SQL et produit un résultat tabulaire, ce qui permet d’incorporer ces analyses aux traitements existants.
TabFM, un modèle de fondation pour les données tabulaires, apporte des capacités d’analytique prédictive. Les colonnes d’identité répondent à un autre besoin : BigQuery peut générer automatiquement des valeurs séquentielles pour les clés, sans que l’application ait à construire elle-même cette logique. Ces valeurs ne doivent pas être assimilées à une numérotation nécessairement sans interruption.
Le changement est donc concret, mais ciblé : davantage de contrôle régional sur l’accès aux catalogues, des analyses intégrées à BigQuery et moins de logique personnalisée pour produire des clés séquentielles.
Comment évoluent les services de traitement et de cache ?
Les annonces améliorent le contrôle des pipelines, leur capacité à traiter des charges d’IA et les performances du cache. Les évolutions touchent Dataflow, Memorystore for Valkey et Pub/Sub, mais les gains annoncés ne doivent pas être interprétés comme des garanties identiques pour tous les workloads.
Dataflow ajoute des commandes permettant de mettre les tâches en pause puis de les reprendre. C’est utile pour mieux maîtriser l’exécution des pipelines, notamment lors d’opérations de maintenance. Google annonce aussi la prise en charge des GPU NVIDIA RTX PRO 6000 Blackwell pour les pipelines d’IA à grande échelle. Cette évolution élargit les ressources matérielles disponibles pour ces traitements, sans préciser ici les performances attendues selon les modèles ou les configurations.
Pour Memorystore for Valkey 9.1, Google annonce jusqu’à trois fois plus de requêtes par seconde et une latence de cache de l’ordre de la microseconde. Ce sont des performances annoncées, pas un benchmark universel : le résultat réel dépend du scénario et de la charge. Je resterais donc prudent avant de les reprendre telles quelles dans un dimensionnement de production.
Entre le 7 et le 10 septembre, une annonce Pub/Sub décrit une évolution des transformations SMT, pour Single Message Transformations, c’est-à-dire des transformations appliquées aux messages individuels. Elles peuvent exécuter des inférences sur les événements entrants à l’aide de modèles hébergés sur Gemini Enterprise Agent Platform, puis ajouter les prédictions aux événements.
- À retenir. Dataflow gagne en contrôle et en capacité GPU, Valkey vise un cache plus rapide, et Pub/Sub peut enrichir les événements avec des prédictions.
- Limite. Les détails disponibles sur l’annonce Pub/Sub restent limités. Les modalités précises de configuration et les contraintes d’exploitation ne sont pas établies par les informations publiées.
Quels résultats les clients obtiennent-ils en production ?
Les résultats publiés par les clients couvrent la fiabilité, la disponibilité et la performance, sur des services Google Cloud différents. Ils illustrent des déploiements précis, pas des garanties applicables à tous les environnements.
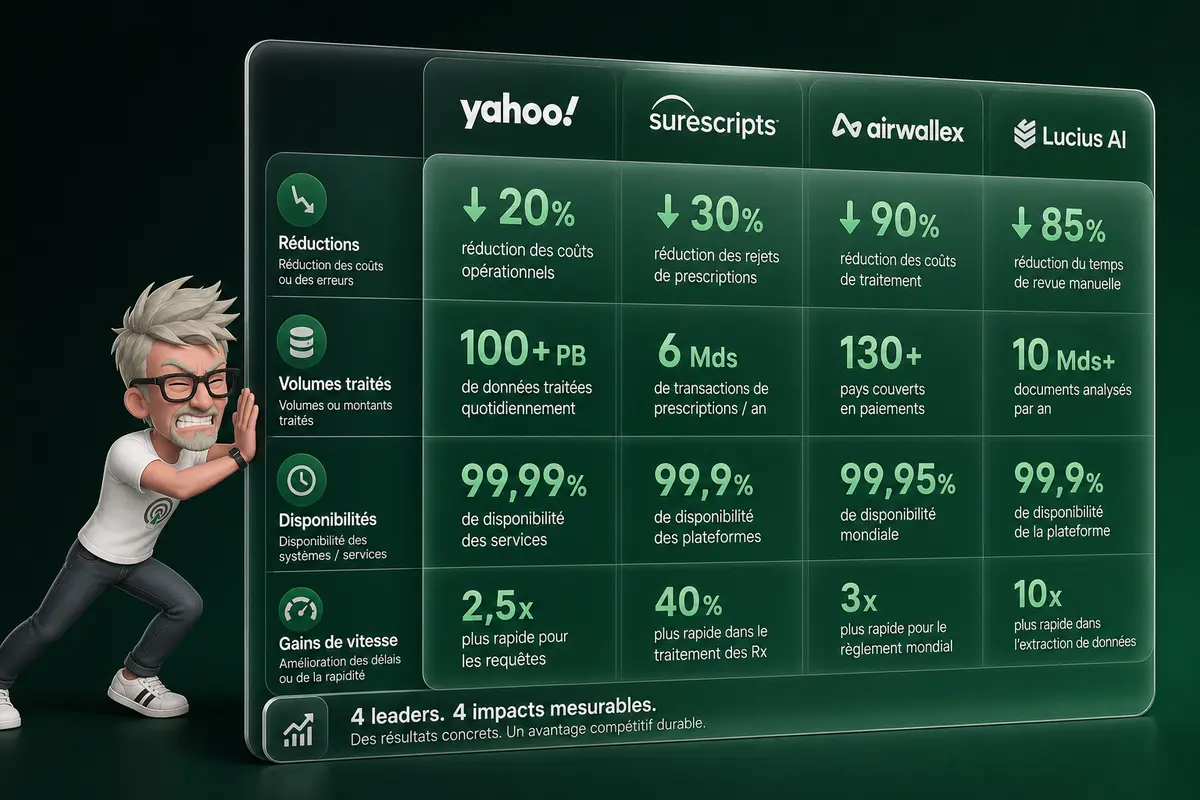
Yahoo a réduit de 85 % les échecs de provisionnement en utilisant les machines virtuelles flexibles de Managed Service for Apache Spark. PayPal a, de son côté, migré des charges analytiques critiques vers ce service. Les chiffres de réduction des échecs sont attribués à Yahoo, pas à PayPal.
Surescripts traite 30,5 milliards de transactions de santé par an sur AlloyDB et rapporte une disponibilité de 99,998 %. Airwallex exploite plus de 5 000 bases de données Cloud SQL avec une disponibilité annoncée de 99,99 %, gérées par quatre administrateurs de bases de données. Ces résultats montrent qu’une équipe réduite peut opérer un parc important, mais ils dépendent de l’architecture et des pratiques propres à Airwallex.
Lucius AI s’appuie sur AlloyDB pour sa plateforme mondiale, qui couvre 210 000 appels d’offres. L’entreprise annonce une recherche vectorielle ScaNN 47 fois plus rapide. ScaNN est une technologie de recherche de vecteurs, utilisée notamment pour retrouver des contenus sémantiquement proches. L’architecture intègre MCP, le Model Context Protocol, un protocole permettant de connecter des modèles d’IA à des outils et à des sources de données.
| Client | Service ou usage | Résultat documenté |
| Yahoo | Managed Service for Apache Spark, VM flexibles | 85 % d’échecs de provisionnement en moins |
| PayPal | Managed Service for Apache Spark | Migration de charges analytiques critiques |
| Surescripts | AlloyDB | 30,5 milliards de transactions de santé par an ; 99,998 % de disponibilité |
| Airwallex | Cloud SQL | Plus de 5 000 bases ; 99,99 % de disponibilité ; quatre administrateurs |
| Lucius AI | AlloyDB, ScaNN et MCP | Plateforme couvrant 210 000 appels d’offres ; recherche annoncée 47 fois plus rapide |
Que retenir de ces nouveautés Google Data Cloud ?
Google Data Cloud fait progresser plusieurs couches de la plateforme : les agents disposent du Data Agent Kit et de nouvelles capacités de recherche, les bases couvrent davantage de modèles de données et d’environnements, tandis que BigQuery et le lakehouse gagnent en fonctions analytiques et en options régionales. Dataflow, Pub/Sub et Memorystore ciblent le contrôle des traitements et les performances. Les déploiements de Yahoo, PayPal, Surescripts, Airwallex et Lucius AI apportent des repères concrets, sans constituer des garanties transposables à chaque architecture. Pour choisir les nouveautés à évaluer, partez de vos contraintes de résidence, de charge et de disponibilité : vous identifierez plus vite les gains applicables à votre environnement.
FAQ
- À quoi sert le Data Agent Kit ?
Il fournit gratuitement des outils MCP et des compétences Google pour permettre à des agents de programmation d’interagir avec plus de 15 services Google Data Cloud depuis un IDE ou une interface en ligne de commande. - Quelles capacités Spanner Omni prend-il en charge ?
Spanner Omni prend en charge les usages SQL distribués, graphe, vectoriels et clé-valeur. Ses API et ses moteurs de requête restent cohérents dans différents environnements. - Que permet le classement BM25 dans AlloyDB ?
En préversion dans AlloyDB et Cloud SQL, il associe la recherche par mots-clés aux embeddings vectoriels pour combiner ces approches de recherche. - Où sont disponibles les catalogues régionaux du lakehouse ?
Les points de terminaison régionaux des catalogues Apache Iceberg REST et Apache Hive sont disponibles dans 22 régions pour soutenir les exigences de résidence des données. - Quels résultats clients sont annoncés sur Google Data Cloud ?
Les exemples cités incluent 85 % d’échecs de provisionnement en moins chez Yahoo, 99,998 % de disponibilité chez Surescripts sur AlloyDB et 99,99 % chez Airwallex sur Cloud SQL. Ces résultats correspondent à leurs déploiements respectifs.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Analytics, Data engineering et automatisation IA. J’accompagne les équipes dans la conception de plateformes data, l’industrialisation des traitements et l’intégration de l’IA aux workflows métier.

⭐ Analytics engineer, Data Analyst et Automatisation IA ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GA4, Matomo, Piano, GTM server, Tealium, Commander Act, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.